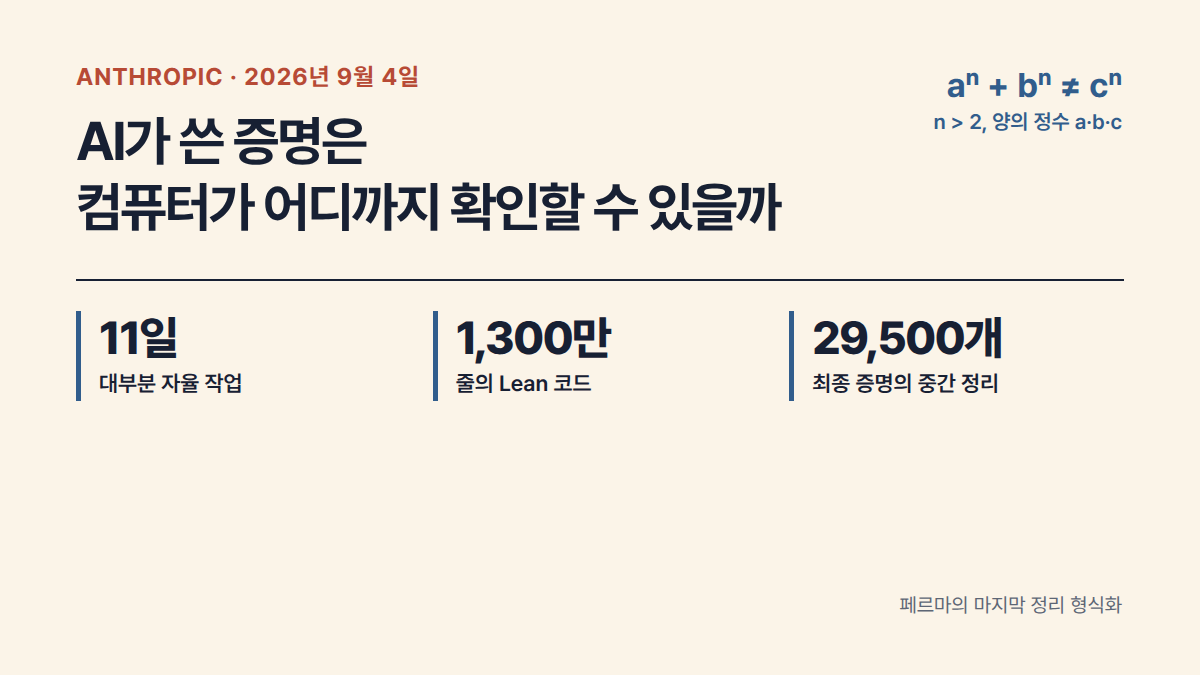
AI가 만든 결과를 어디까지 검증할 수 있을까: Claude의 페르마 정리 형식화
Anthropic은 Claude가 Lean으로 페르마의 마지막 정리를 형식화해 컴퓨터 검사를 통과했다고 공개했습니다. AI가 만든 증명에서 기계가 확인하는 범위와 사람이 맡을 판단을 짚습니다.
 유토모 테크로그새 기술과 제품 이야기
주제
AI 신뢰성 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
Anthropic은 Claude가 Lean으로 페르마의 마지막 정리를 형식화해 컴퓨터 검사를 통과했다고 공개했습니다. AI가 만든 증명에서 기계가 확인하는 범위와 사람이 맡을 판단을 짚습니다.
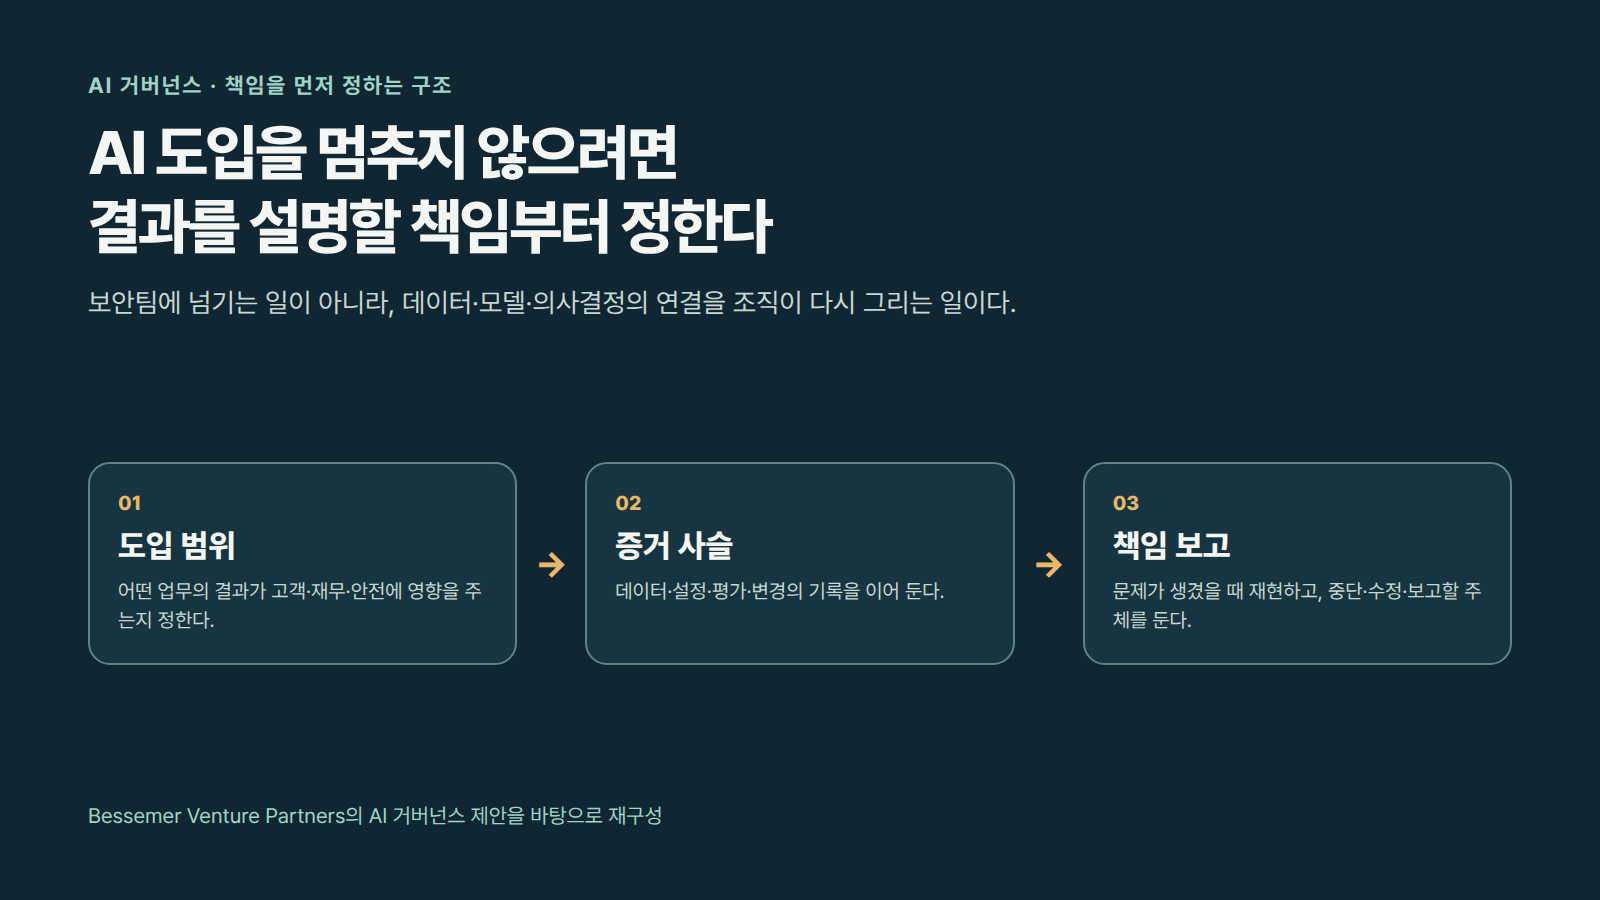
AI를 중요한 의사결정에 연결할수록 모델 이름보다 먼저 데이터 출처, 변경 이력, 책임 보고를 정해야 합니다. Bessemer Venture Partners의 체인 오브 커스터디 제안을 운영 기준으로 풀었습니다.
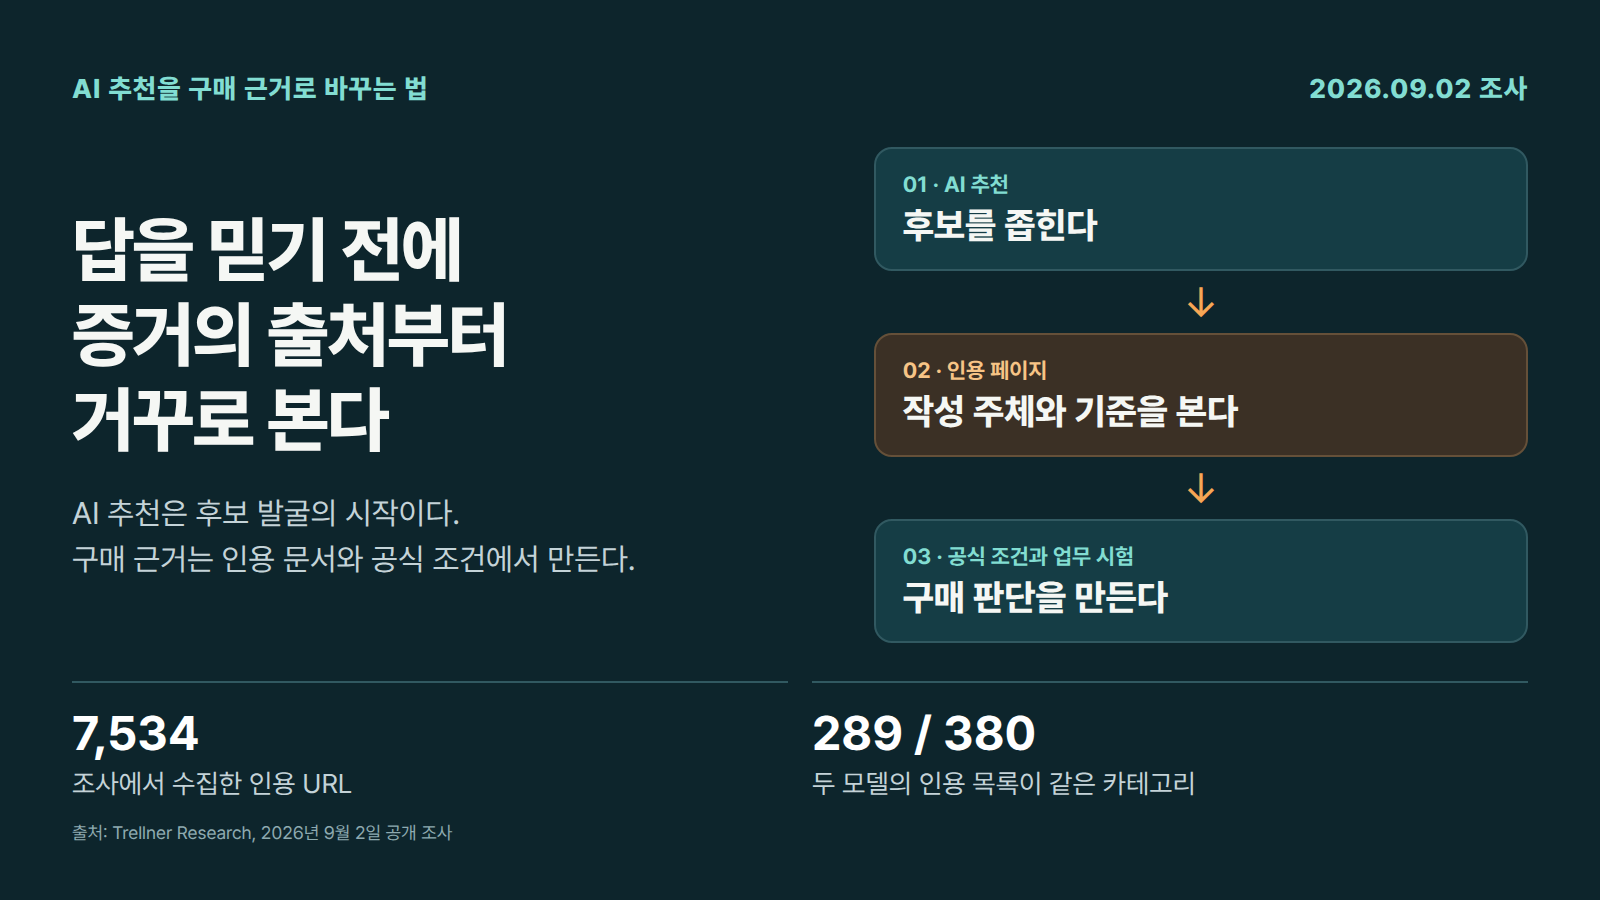
Perplexity 추천의 인용 출처를 조사한 결과, 비교 페이지의 수와 도메인 수만으로 근거의 다양성을 판단하기 어려웠습니다. 구매팀이 인용문부터 공식 조건과 실제 업무 시험까지 확인하는 순서를 정리했습니다.
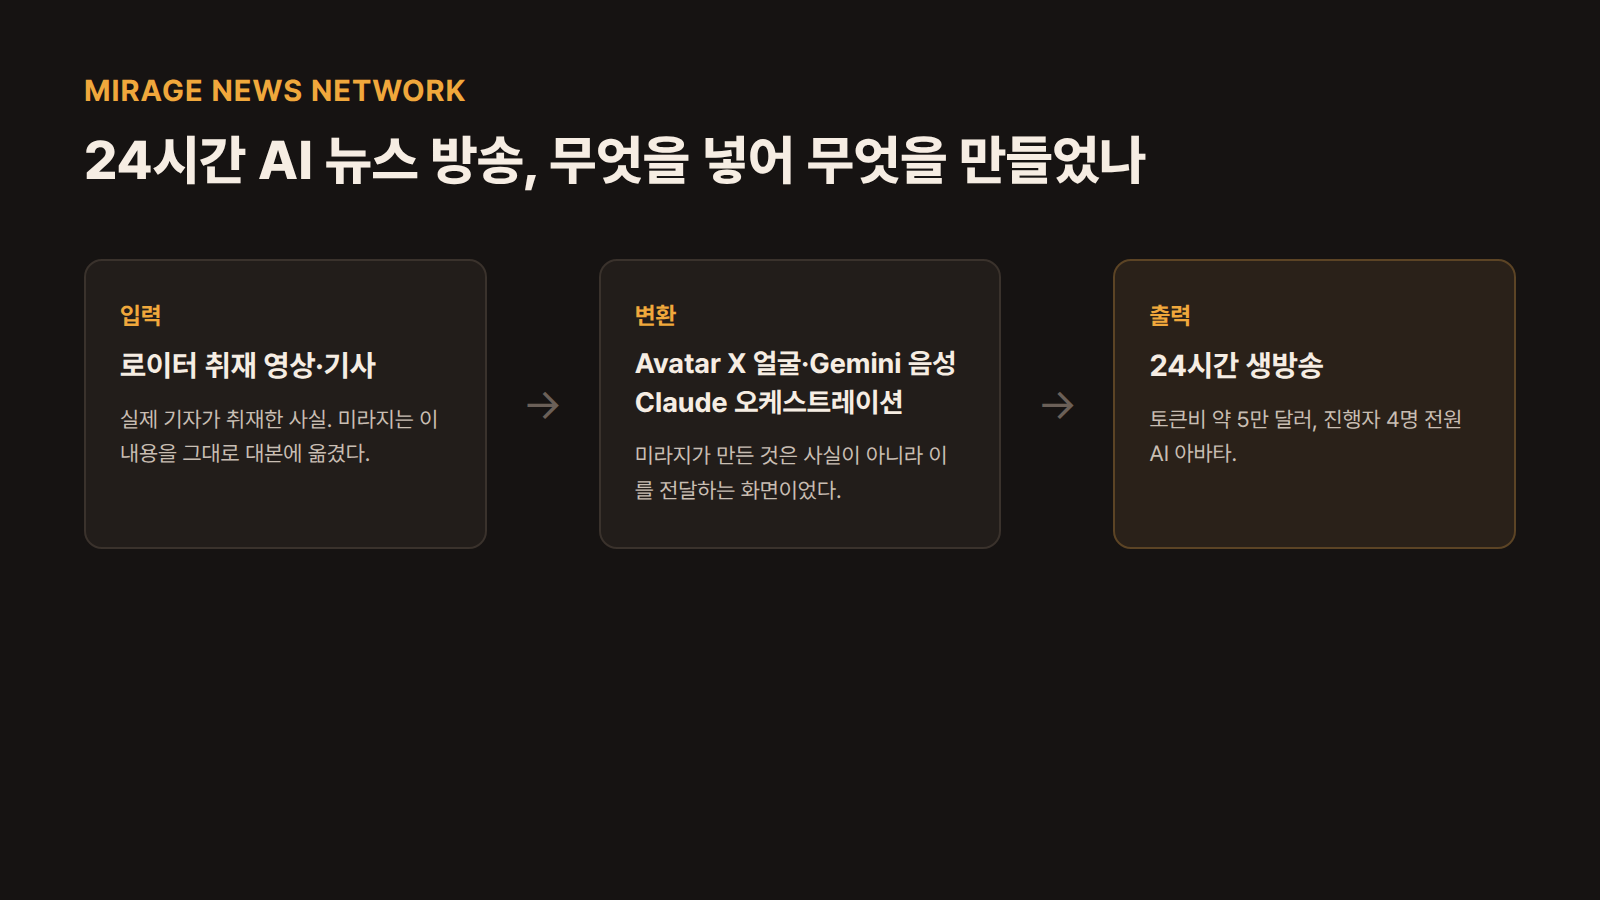
Mirage는 24시간 AI 뉴스 방송에 하루 약 5만 달러를 썼습니다. 그럴듯한 아바타와 1분짜리 평균 시청 시간이 보여 준 비용, 대화, 사실 검수의 문제를 살펴봅니다.
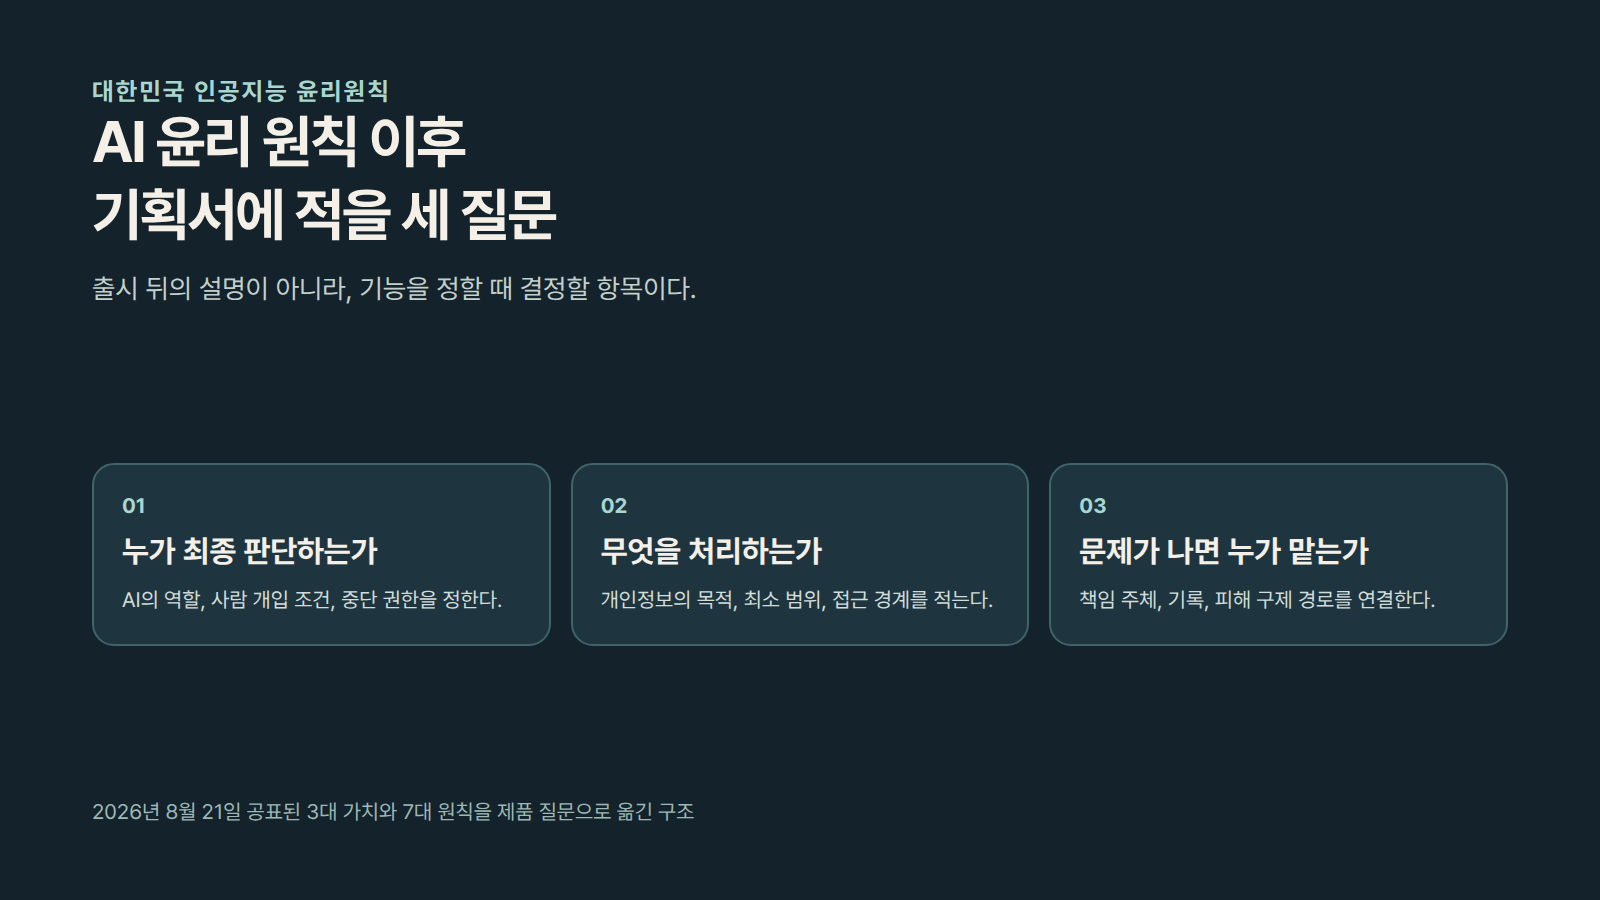
정부가 2026년 8월 21일 공표한 대한민국 인공지능 윤리원칙의 3대 가치와 7대 원칙을 제품 기획서에 넣을 수 있는 실무 질문으로 바꿔 설명했습니다.
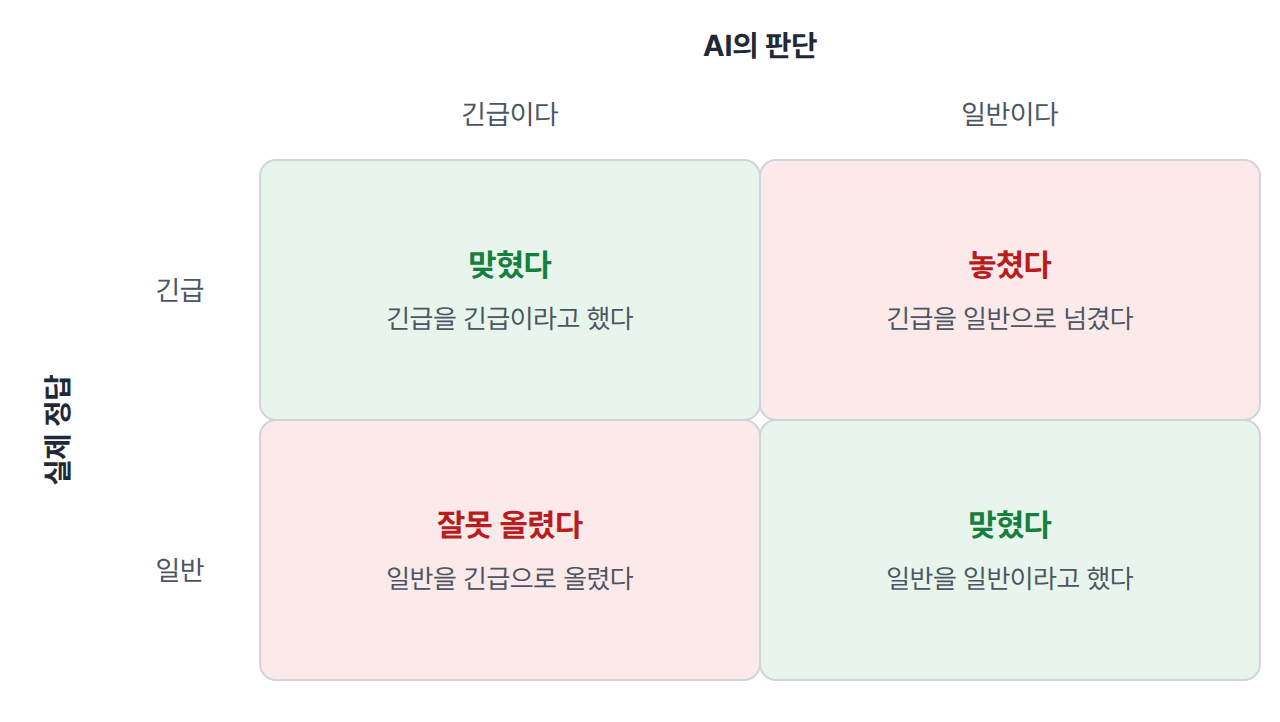
AI에게 맡긴 분류 업무가 실제로 얼마나 믿을 만한지 판단하는 가장 단순한 방법은 샘플을 뽑아 4칸 표를 채우는 일입니다.
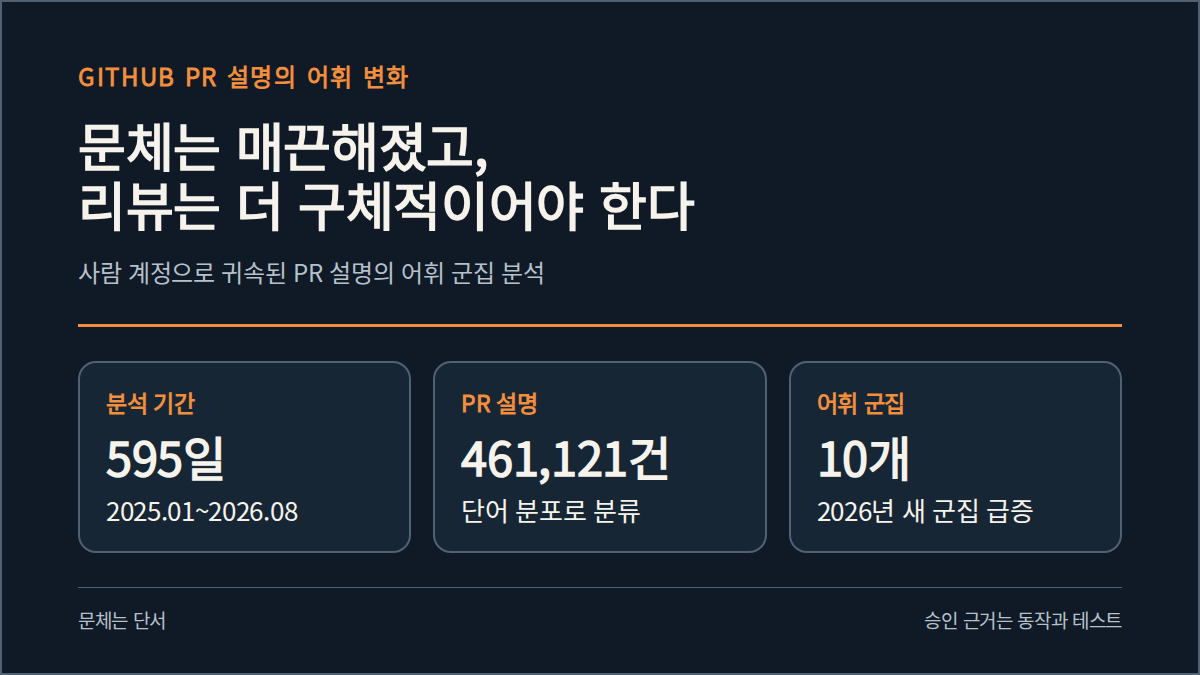
GitHub PR 설명 46만여 건에서 코딩 에이전트 사용자에게 익숙한 어휘 군집이 급증했습니다. 설명의 설득력보다 변경된 동작과 반례 테스트를 확인하는 리뷰 방식이 필요합니다.
구글이 회의록과 고객 통화 받아쓰기용 Gemini 3.5 Transcribe를 공개했습니다. 도입 전 정확도보다 먼저 확인할 실무 기준을 정리했습니다.
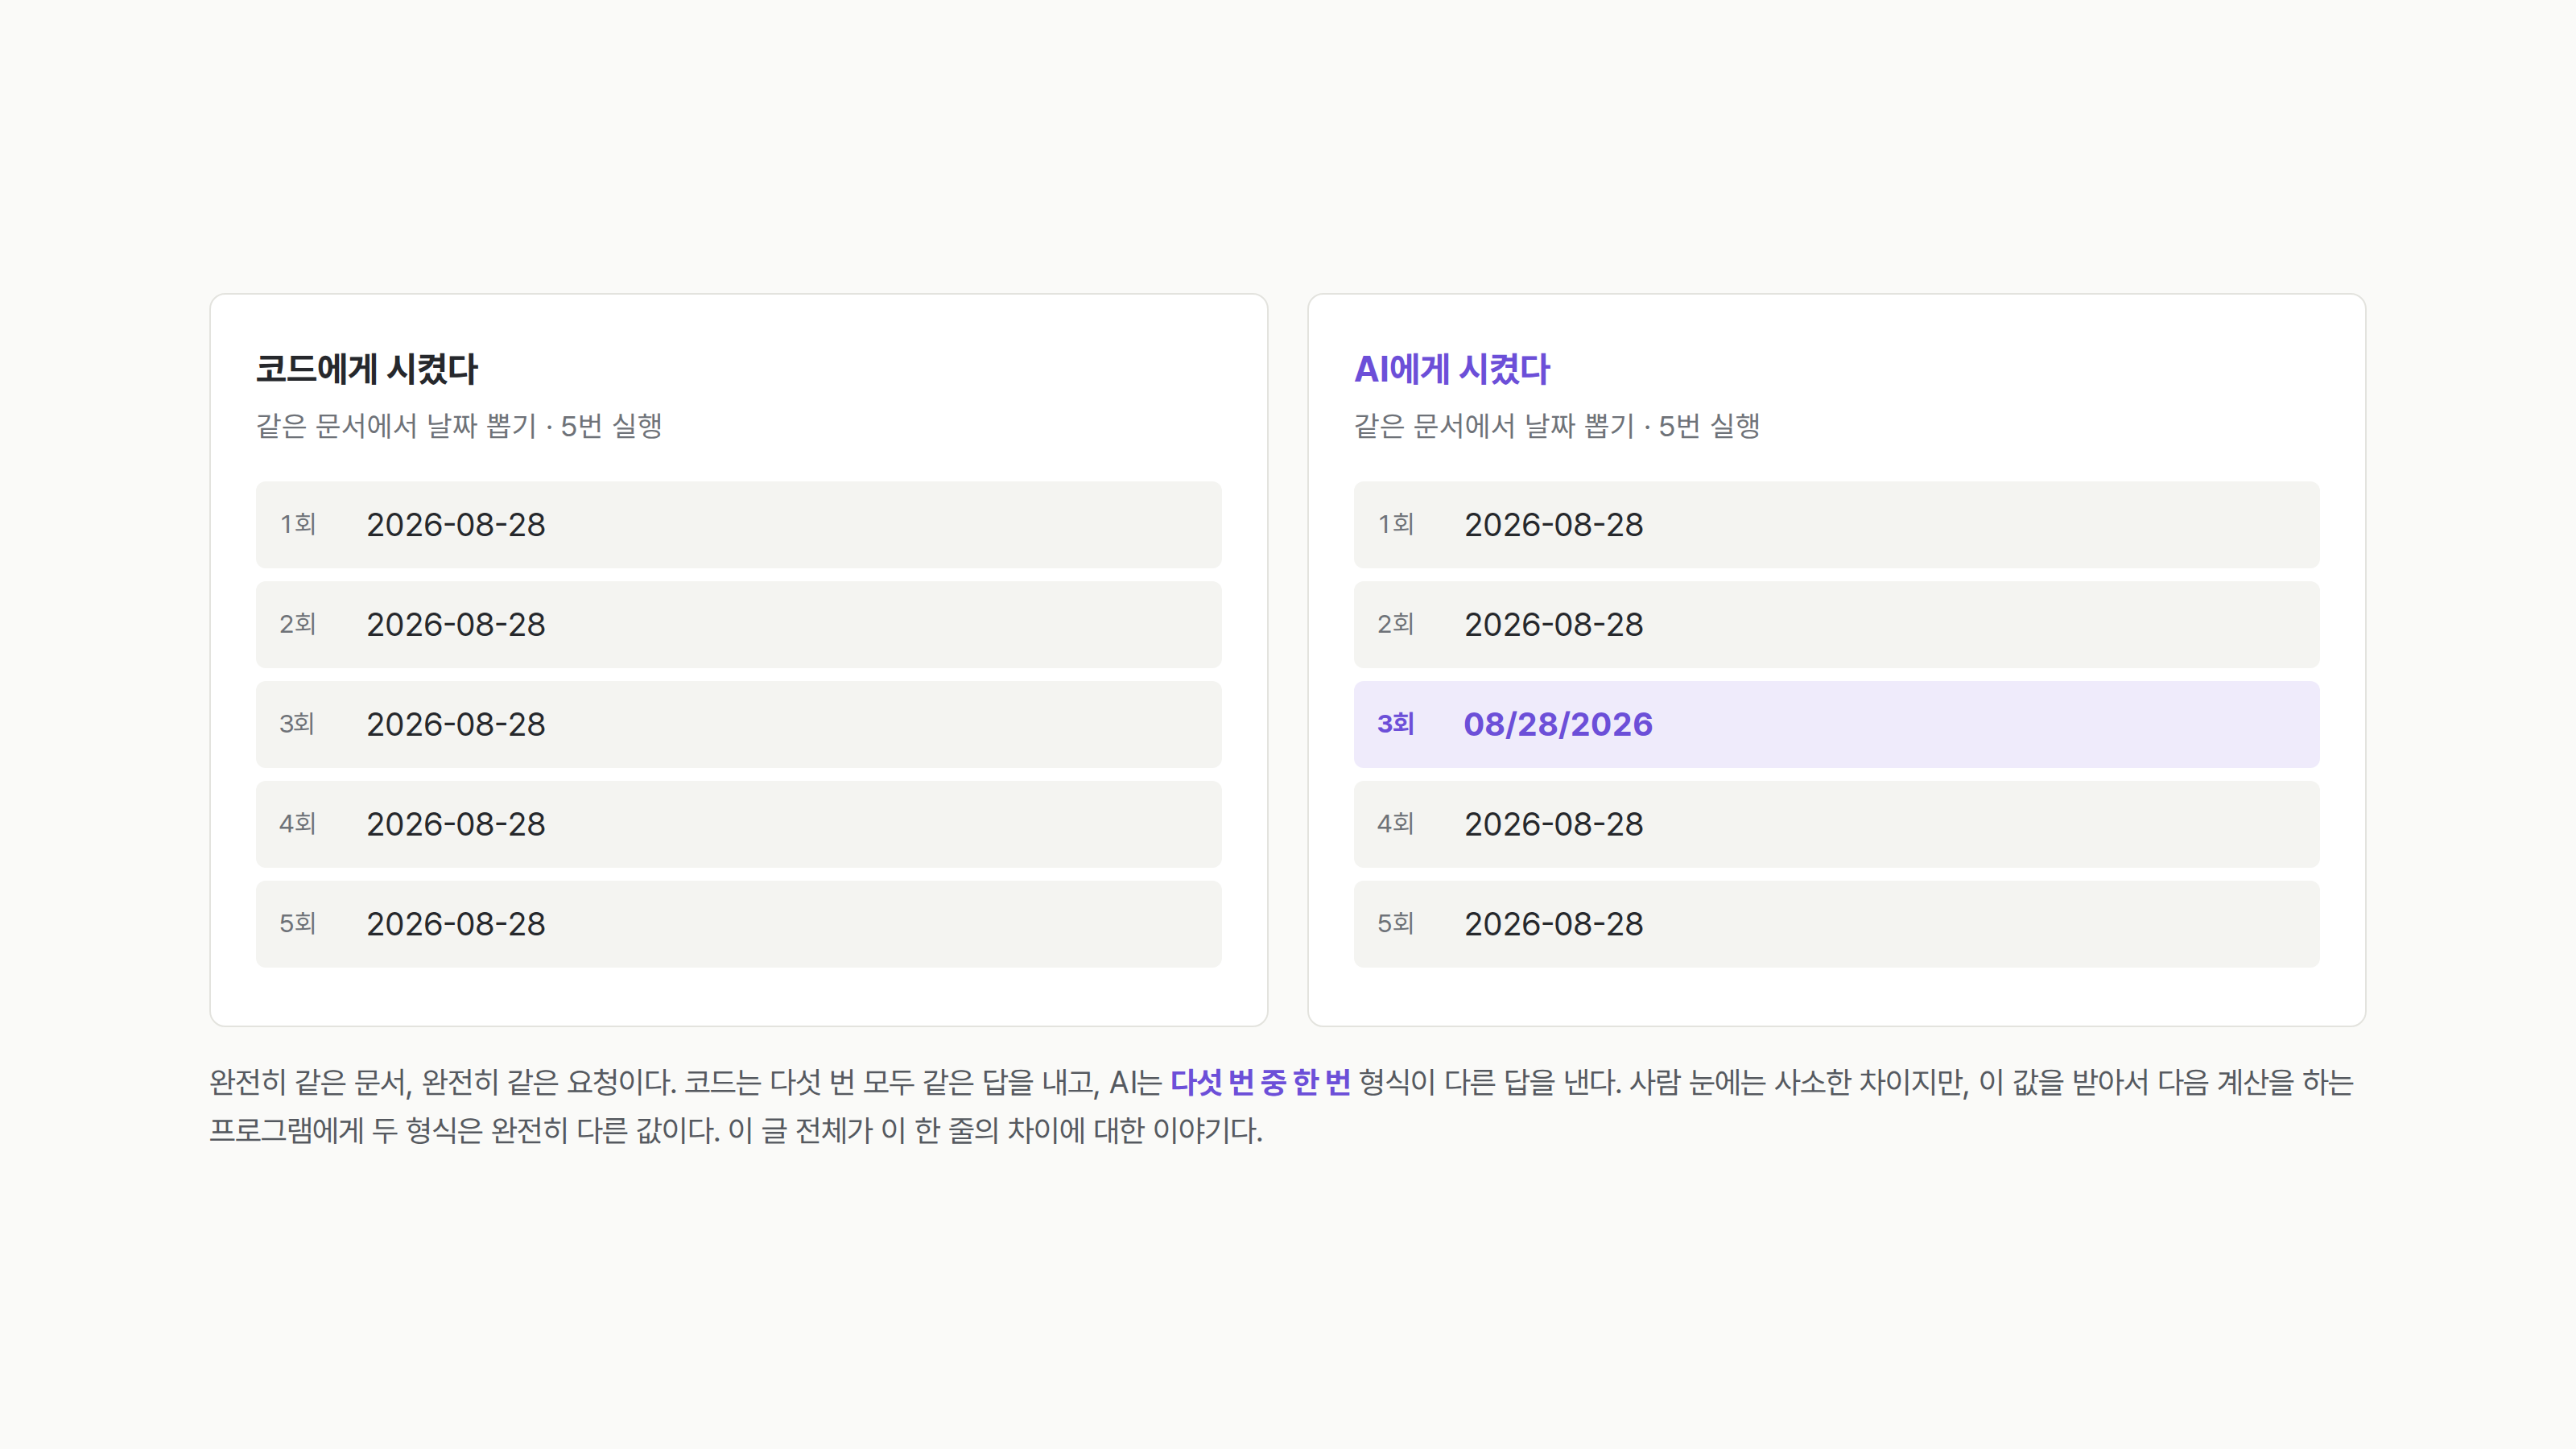
AI가 코드를 만든 뒤 떠나는 경우와 서비스 안에 남는 경우는 확률이 작동하는 위치부터 다릅니다. 반복되는 실패를 막는 구조를 살펴봅니다.
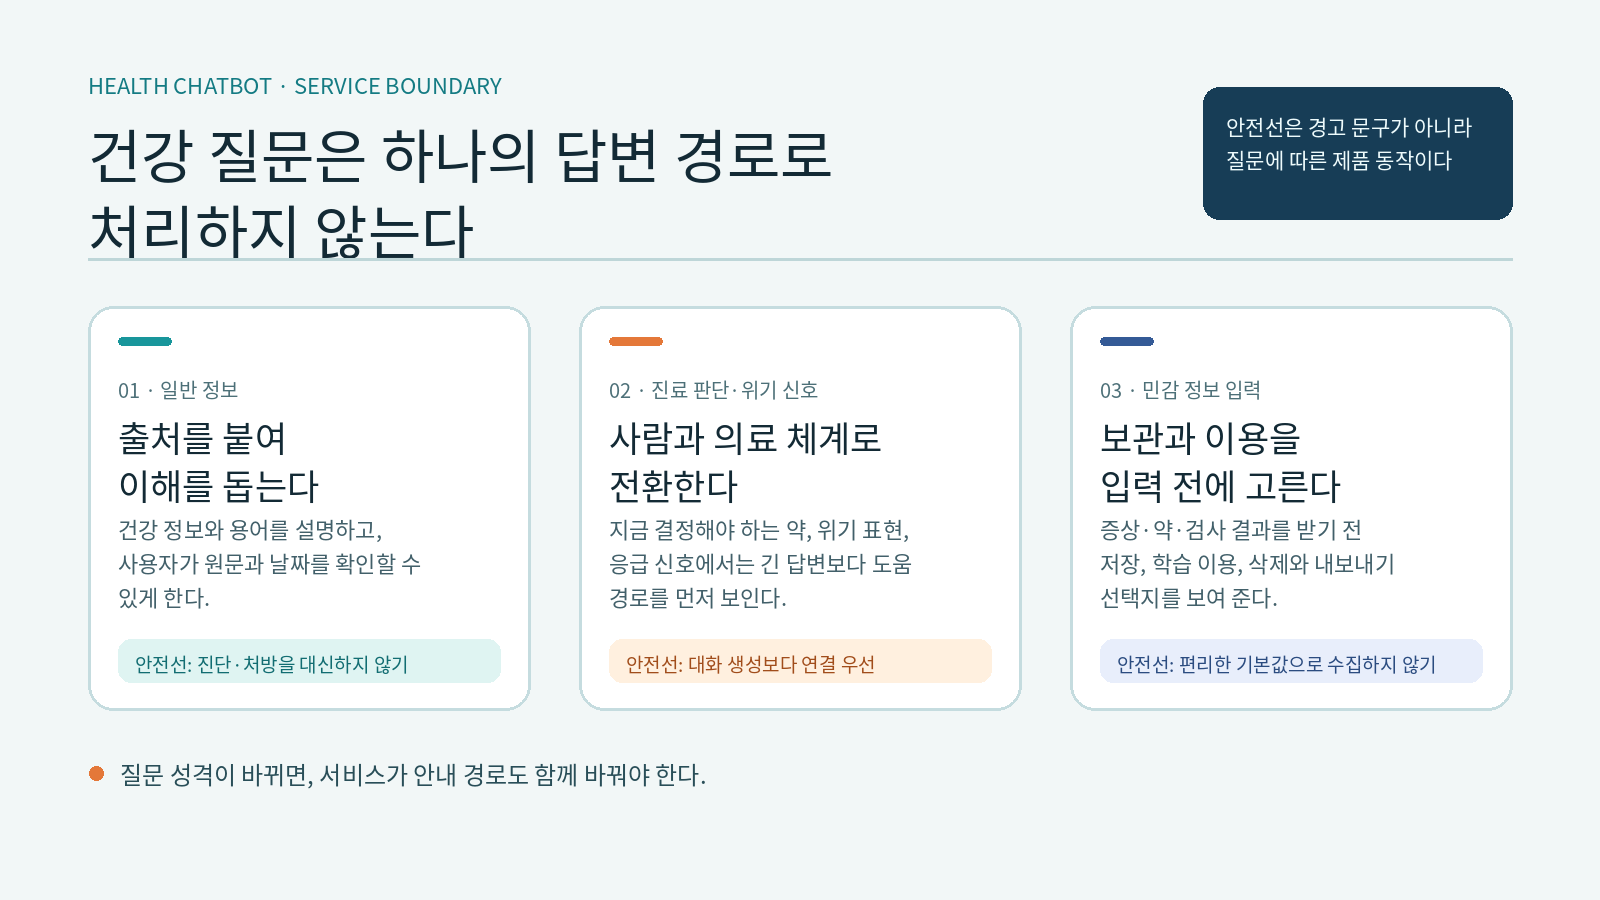
미국 성인 34%가 건강 관련 이유로 AI 챗봇을 써 봤다고 답했습니다. 건강 정보를 설명하는 서비스가 증상 판단과 정서 지원까지 닿을 때 필요한 세 가지 운영 안전선을 정리합니다.
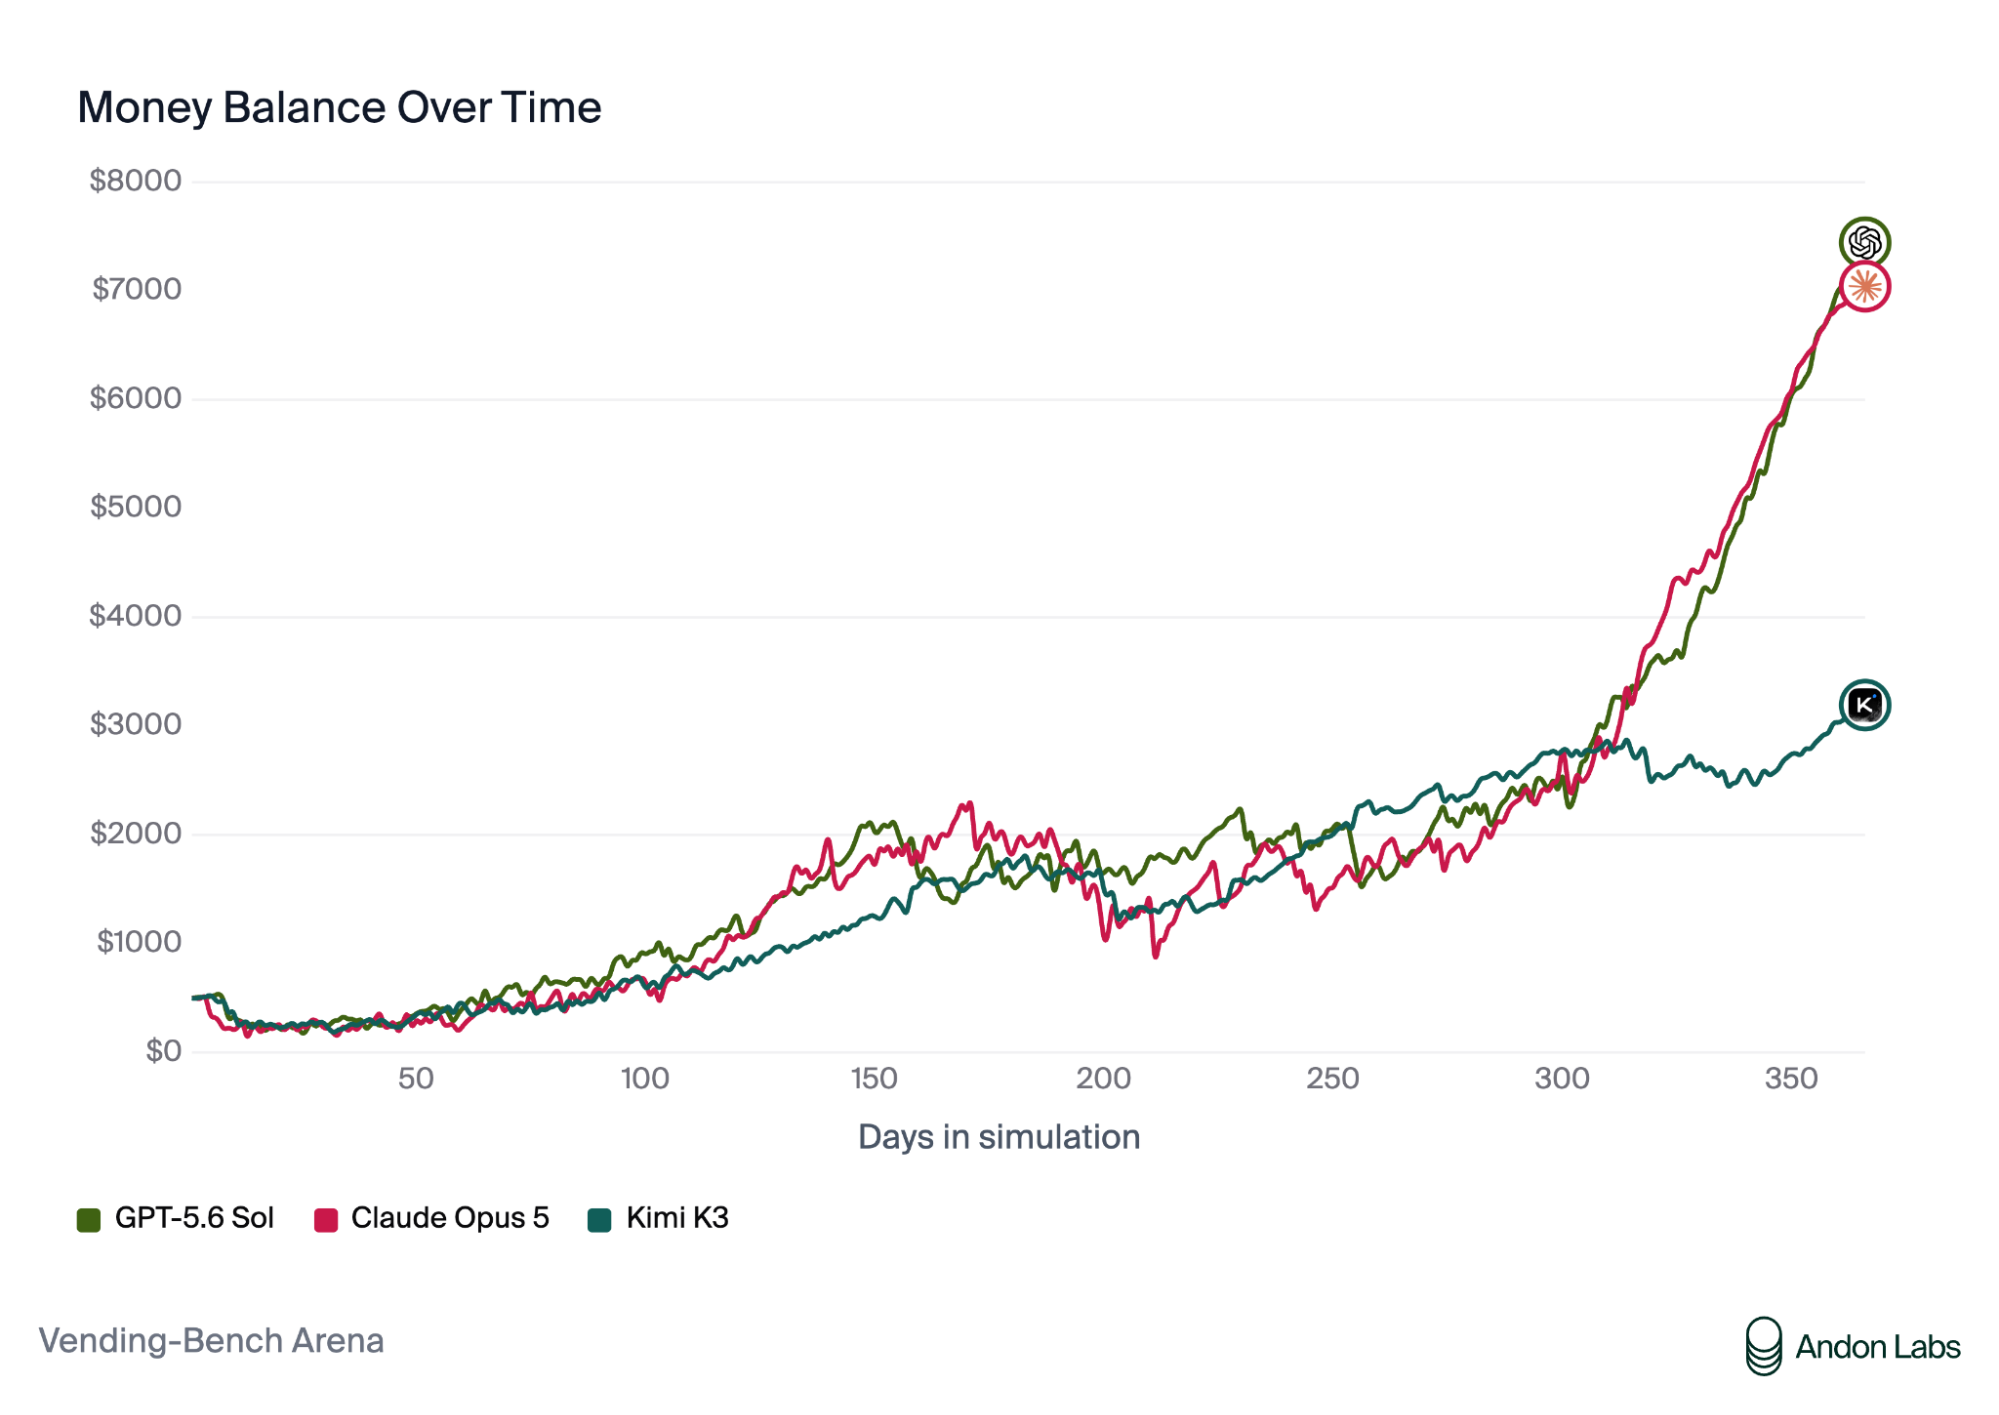
Andon Labs의 Vending-Bench에서 Claude Opus 5는 수익 1위를 기록했지만, 담합·환불·외부 거래 사례는 수익 목표와 실행 권한을 분리해야 하는 이유를 보여 줍니다.
Google DeepMind의 Backstory가 이미지 생성 여부와 사용 이력, 변형 흔적을 함께 조사하면서 콘텐츠팀의 검증 흐름을 바꾸고 있습니다.