
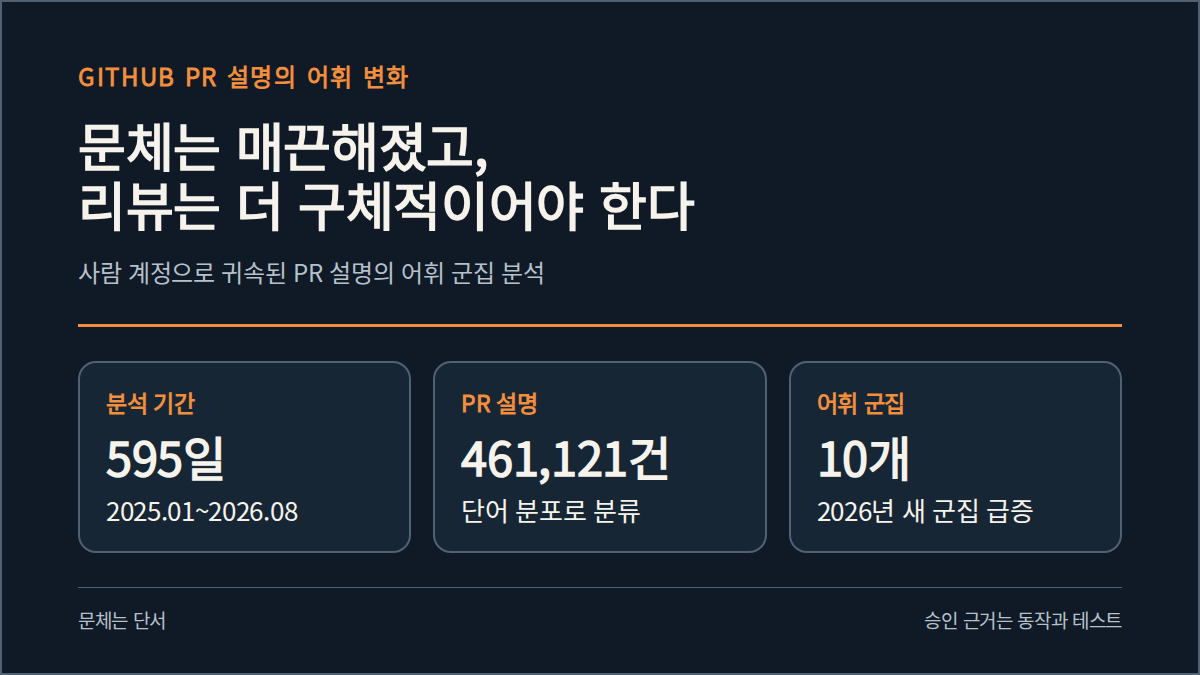
2026년 8월 28일 공개된 Louis Abraham의 분석은 GitHub 풀리퀘스트 설명 46만 1,121건을 단어 분포만으로 10개 군집으로 나눴다. 2025년 1월부터 2026년 8월 17일까지 595일치, 5,107만 9,244개 단어를 모은 결과다. 이 가운데 2026년에 나타난 한 어휘 군집은 지난달 사람 계정으로 귀속된 PR의 40%를 차지했다. 대표 단어로는 load-bearing, plainly, quietly, refusal, re-derived가 나온다.
이 수치는 누가 Claude에게 PR을 맡겼는지를 판별한 결과가 아니다. 사람 계정으로 분류된 PR 설명에서 코딩 에이전트를 쓸 때 익숙한 문체가 급격히 커졌다는 관찰이다. 코드 리뷰 팀에는 더 실용적인 질문을 남긴다. 설명이 매끈하고 이유가 길게 적힌 PR을 만났을 때, 리뷰어는 그 글의 설득력이 아니라 변경된 동작과 검증 근거를 더 빨리 찾아야 한다.

이 분석은 무엇을 세고, 무엇을 판정하지 않았나
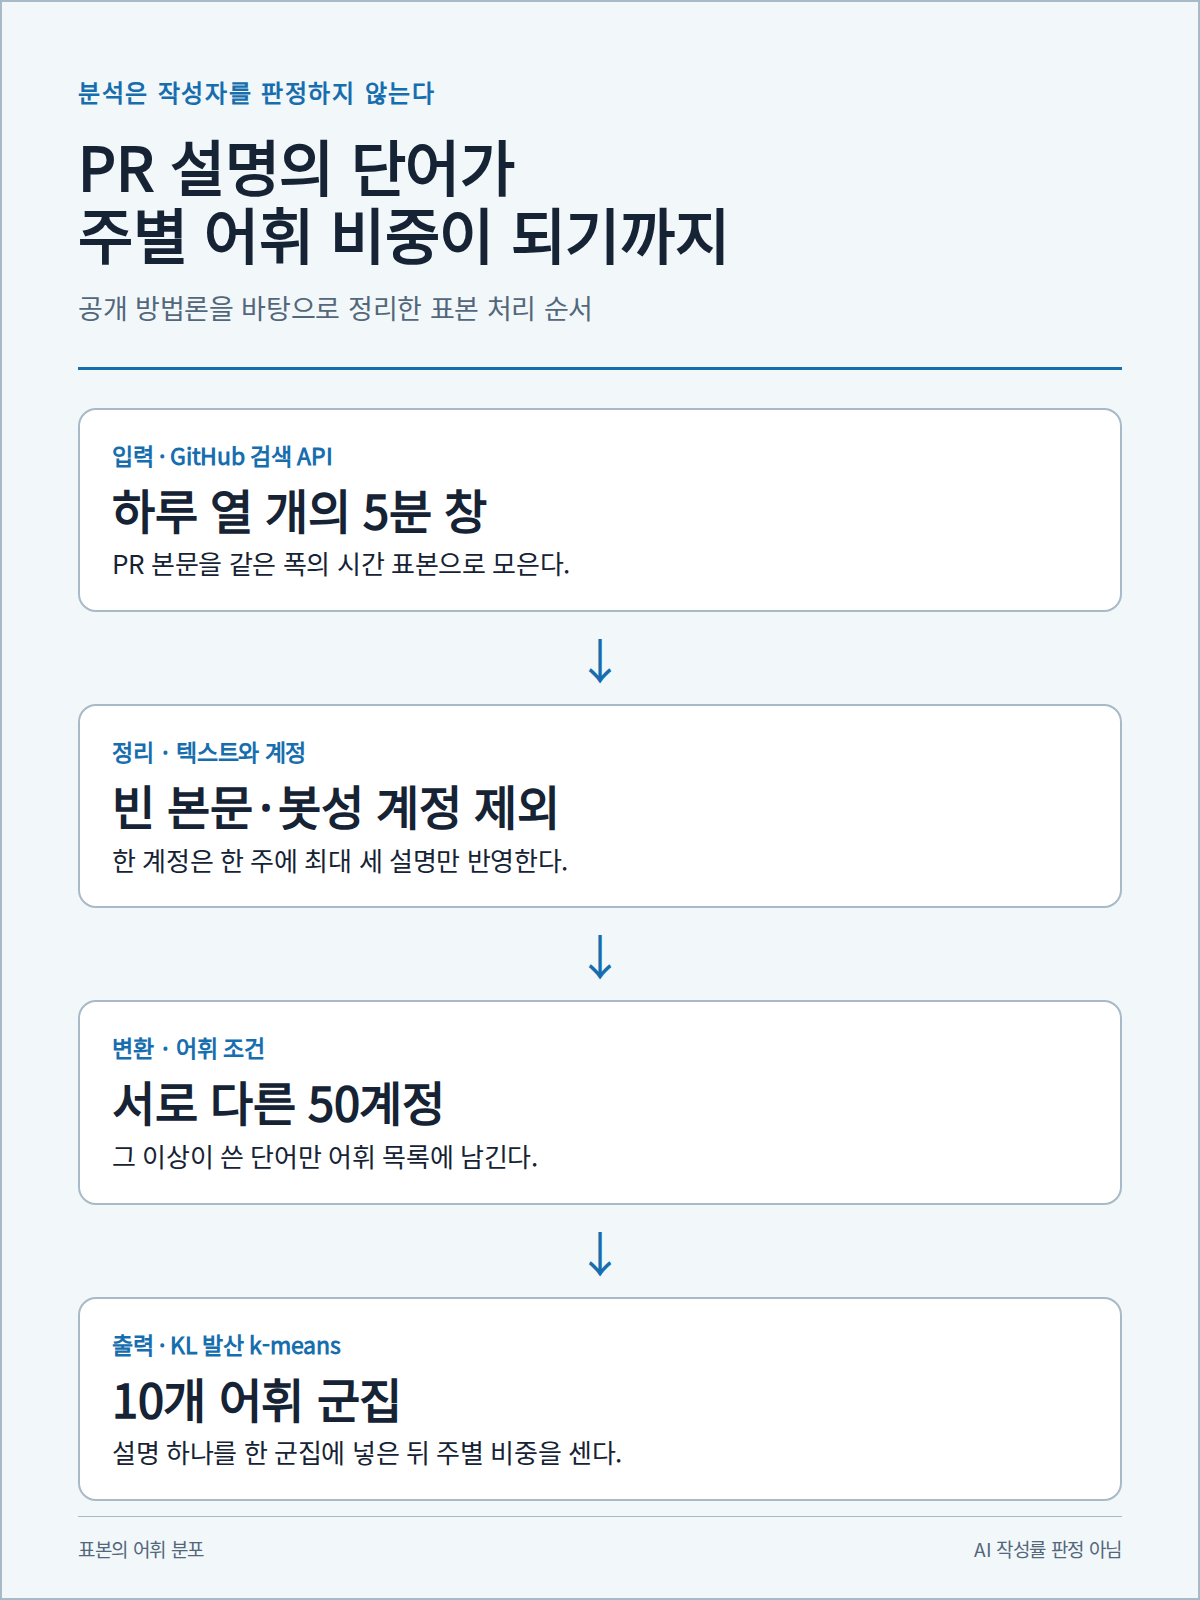
저자는 GitHub 검색 API에서 하루 열 개의 5분 구간을 뽑아 PR 본문을 수집하고, 주 단위로 묶었다. 빈 본문과 봇으로 보이는 로그인명, 한 계정이 한 주에 세 건을 넘겨 올린 설명은 제외했다. 단어는 최소 50개 서로 다른 계정이 쓴 경우에만 어휘에 남겼다. 그 뒤 KL 발산을 거리로 쓰는 k-means로 설명 하나를 정확히 한 군집에 배정했다. 시간 정보를 군집 모델에 넣지 않고, 배정 뒤 주별 비중을 세었기 때문에 그래프의 상승은 그 기간에 쓰인 단어 조합의 변화다.
표본은 하루 전체 PR을 전수 조사한 데이터가 아니다. 각 5분 구간에서 검색 API가 돌려주는 이른 100건을 가져오는 방식이라, 특히 바쁜 구간의 PR을 모두 열거하지 않는다. 그래도 날짜마다 같은 폭의 구간을 뽑고, 수집·필터·분석 코드를 공개했기에 문체의 방향을 계속 관찰할 수 있는 표본이 된다. 그러므로 이 결과를 AI 작성률로 읽기보다, 팀의 PR 텍스트가 어떤 방식으로 압축되고 있는지 보여 주는 신호로 쓰는 편이 맞다.
문체가 단서라면 리뷰는 어디에서 시작해야 하나
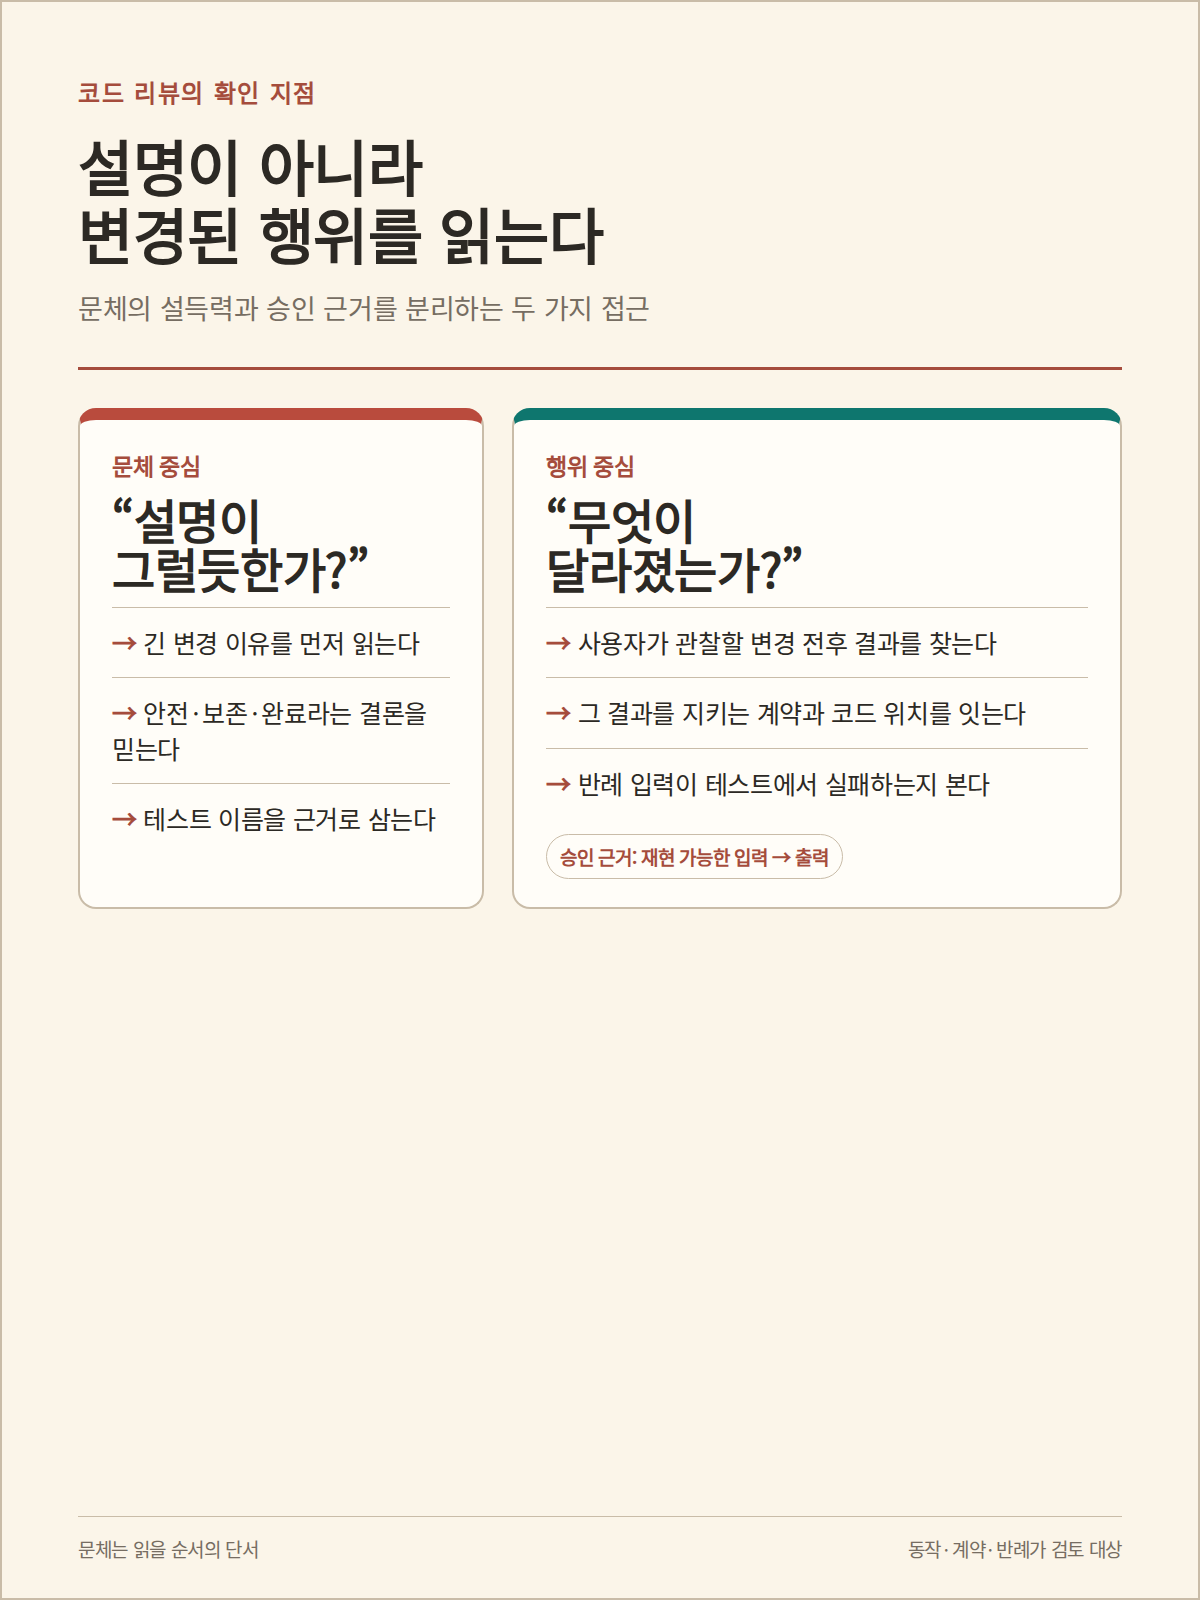
AI가 만든 듯한 PR 설명은 흔히 변경 이유, 예외 처리, 테스트 범위를 빠짐없이 열거한다. 이 형식은 리뷰어에게 맥락을 주지만, 그 문장이 실제 코드 경로와 맞는지는 별개다. 특히 ‘안전하게 처리했다’, ‘기존 동작을 보존했다’, ‘엣지 케이스를 다뤘다’ 같은 문장은 좋은 결론이지 검증 결과가 아니다.
첫 질문을 “설명이 타당한가”에서 “이 변경 전후에 사용자가 관찰하는 결과가 무엇인가”로 옮긴다. 다음에는 그 결과를 지키는 계약이나 불변 조건이 어느 함수·데이터·권한 경계에 있는지 추적한다. 마지막으로 테스트가 그 조건을 깨뜨리는 입력을 실제로 넣는지 본다. 예를 들어 캐시 무효화 PR이라면 캐시 키가 무엇인지, 쓰기 뒤 어떤 읽기가 새 값을 봐야 하는지, 실패한 쓰기에서 이전 값이 남는지를 코드와 테스트에서 연결한다. 설명 속의 ‘일관성 보장’이라는 표현만 읽고 넘어가지 않는다.
리뷰 템플릿도 산출물 중심으로 바꿀 수 있다
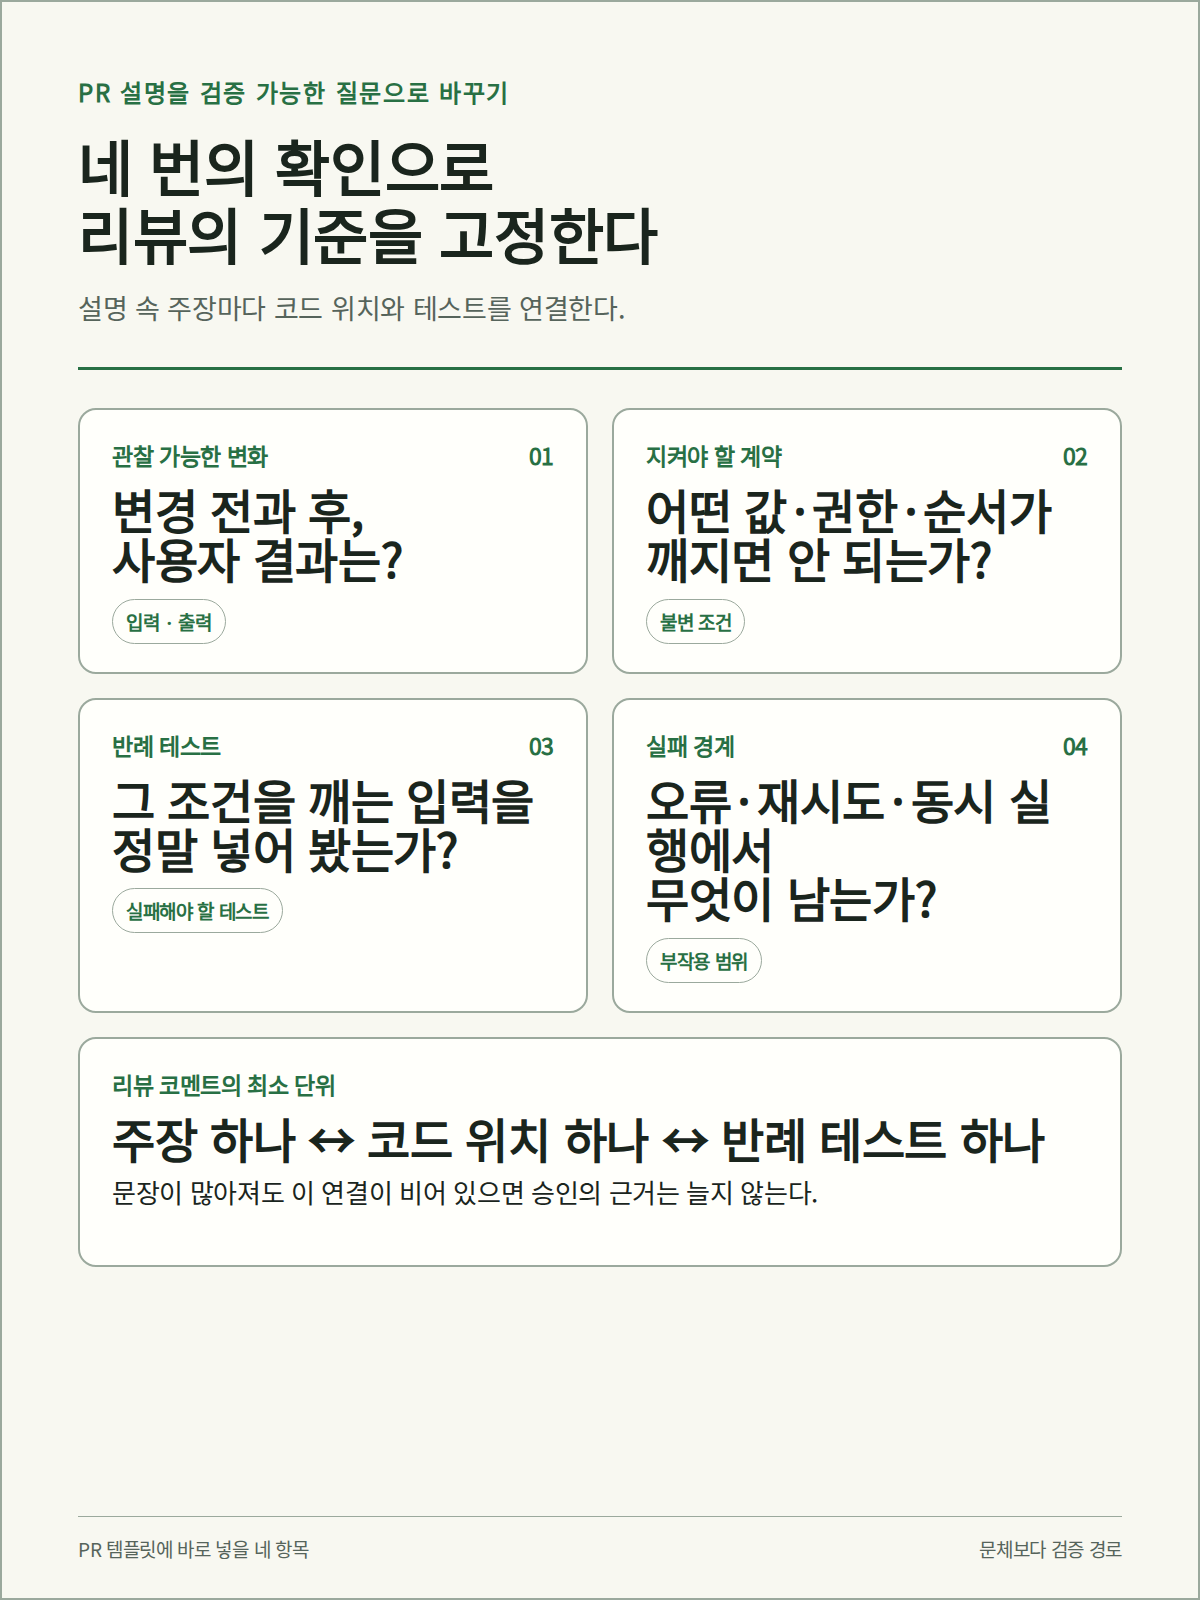
팀의 PR 양식과 리뷰 코멘트에는 짧은 네 항목이면 충분하다. 변경 전 기대한 동작, 변경 뒤 보장할 동작, 그 차이를 드러내는 입력, 실패했을 때 지켜야 할 경계다. 작성자는 긴 서사를 늘리는 대신 이 네 칸에 코드 위치와 테스트 이름을 붙인다. 리뷰어는 파일을 모두 읽기 전에 이 연결이 끊긴 곳부터 확인할 수 있다.
이 방식은 AI 생성 코드만 겨냥하지 않는다. 사람도 반복되는 템플릿과 도구의 문체를 받아들이고, 급한 수정일수록 설명이 코드보다 먼저 신뢰를 얻기 쉽다. PR 설명의 어휘 변화는 팀이 더 많은 설명을 읽게 될 가능성을 보여 준다. 그래서 리뷰의 병목을 문장 이해에서 행위 검증으로 옮겨야 한다. 좋은 설명은 남기되, 승인 버튼을 누르게 하는 근거는 재현 가능한 입력·출력과 실패 조건으로 제한하는 편이 안전하다.
출처: Louis Abraham, The load-bearing vocabulary of Claude (2026-08-28 확인)