
pgrust 0.2는 PostgreSQL과 호환되는 데이터베이스를 Rust로 다시 구현하는 프로젝트다. 저자는 2026년 8월 3일 공개한 글에서 ClickBench 분석 벤치마크에서 pgrust가 PostgreSQL보다 300배 빠르고 ClickHouse도 앞섰다고 밝혔다. 그 차이 전체가 쿼리 엔진 하나에서 나온 것은 아니다. 저자가 같은 글에서 분리해 보인 쿼리 엔진 개선분은 약 10배이며, 그 안에는 배치 처리·연산자 융합·SIMD라는 세 단계가 있다.
핵심은 SQL을 더 빨리 해석하는 일이 아니라, 이미 세워진 실행 계획이 숫자 행을 CPU에 어떻게 건네는가다. 저자는 AWS c8g.4xlarge(Graviton4 16 vCPU)에서 병렬 쿼리를 끈 PostgreSQL 18.4와, 공유 버퍼에 데이터를 올려 둔 조건으로 5억 개 float8 합계를 비교했다. PostgreSQL 실행은 약 20초였고, 저장 형식 해석·잠금 같은 주변 비용을 뺀 축소 실행기는 1.3초였다. 아래 세 최적화는 이 축소 실행기 안의 호출·복사·연산 방식을 바꾼 결과다.
행 하나씩 꺼내는 실행기는 왜 CPU를 낭비하는가
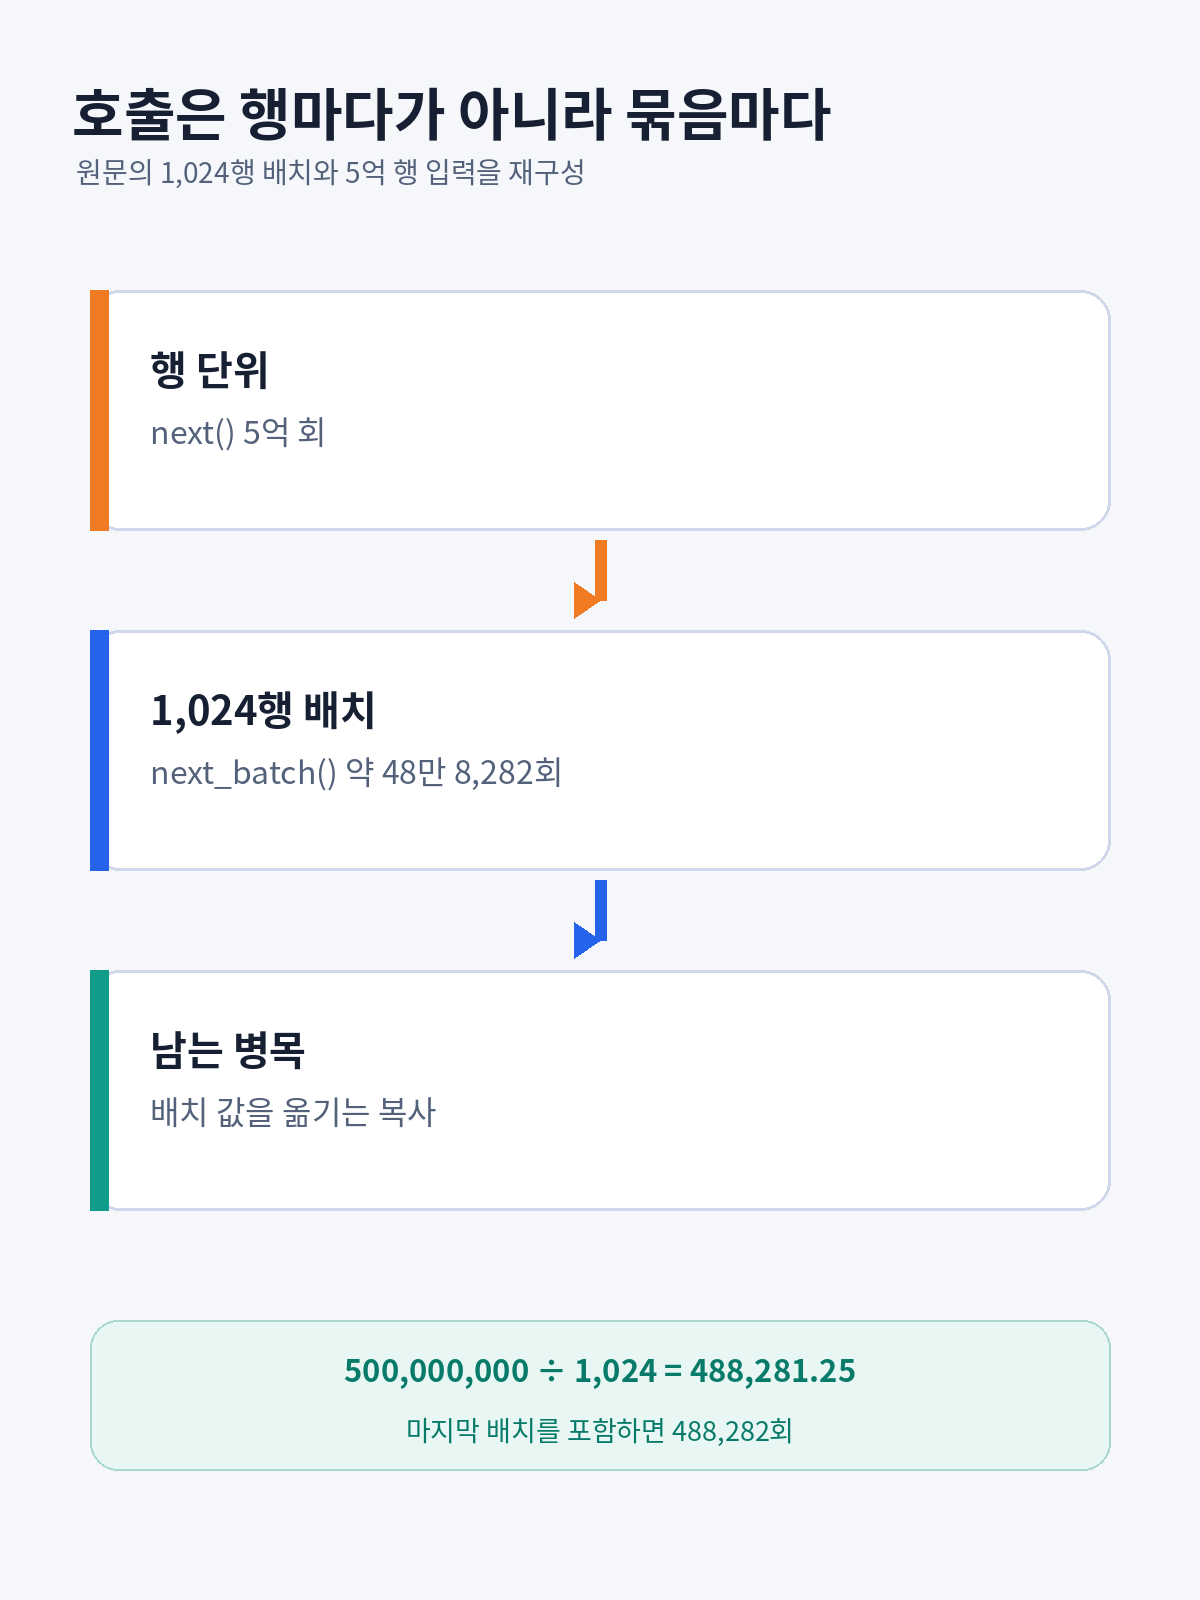
PostgreSQL의 실행기는 흔히 Volcano 모델이라 부르는 행 단위 인터페이스를 쓴다. 순차 스캔 노드가 next()로 한 행을 넘기고, 그 위의 합계 노드가 다시 그 메서드를 호출한다. 계획 노드를 조합하기에는 단순하지만 5억 행이라면 호출·분기·상태 확인도 5억 번 반복된다. 런타임에 대상이 결정되는 함수 호출은 CPU의 파이프라이닝에도 불리하다. 분석 쿼리처럼 대량 스캔이 중심인 작업에서는 디스크보다 CPU와 메모리 대역폭이 병목이 되는 이유다.
배치 처리는 호출 횟수를 줄이고 메모리 할당을 피한다
첫 단계는 next() 대신 한 번에 최대 1,024개 값을 주고받는 next_batch()다. 순차 스캔은 배열 일부를 배치 버퍼로 복사하고, 합계 노드는 버퍼 전체를 순회한다. 5억 행에서는 노드 간 왕복이 약 48만 8,282회가 된다. 원문 구현은 이 버퍼를 스택에 두어 집계 중 새 메모리를 할당하지 않는다. 결과는 1.3초에서 약 480ms다. 행 단위 계획의 유연성은 유지하면서, 그 유연성을 지탱하는 호출 비용을 묶어 낸 셈이다.
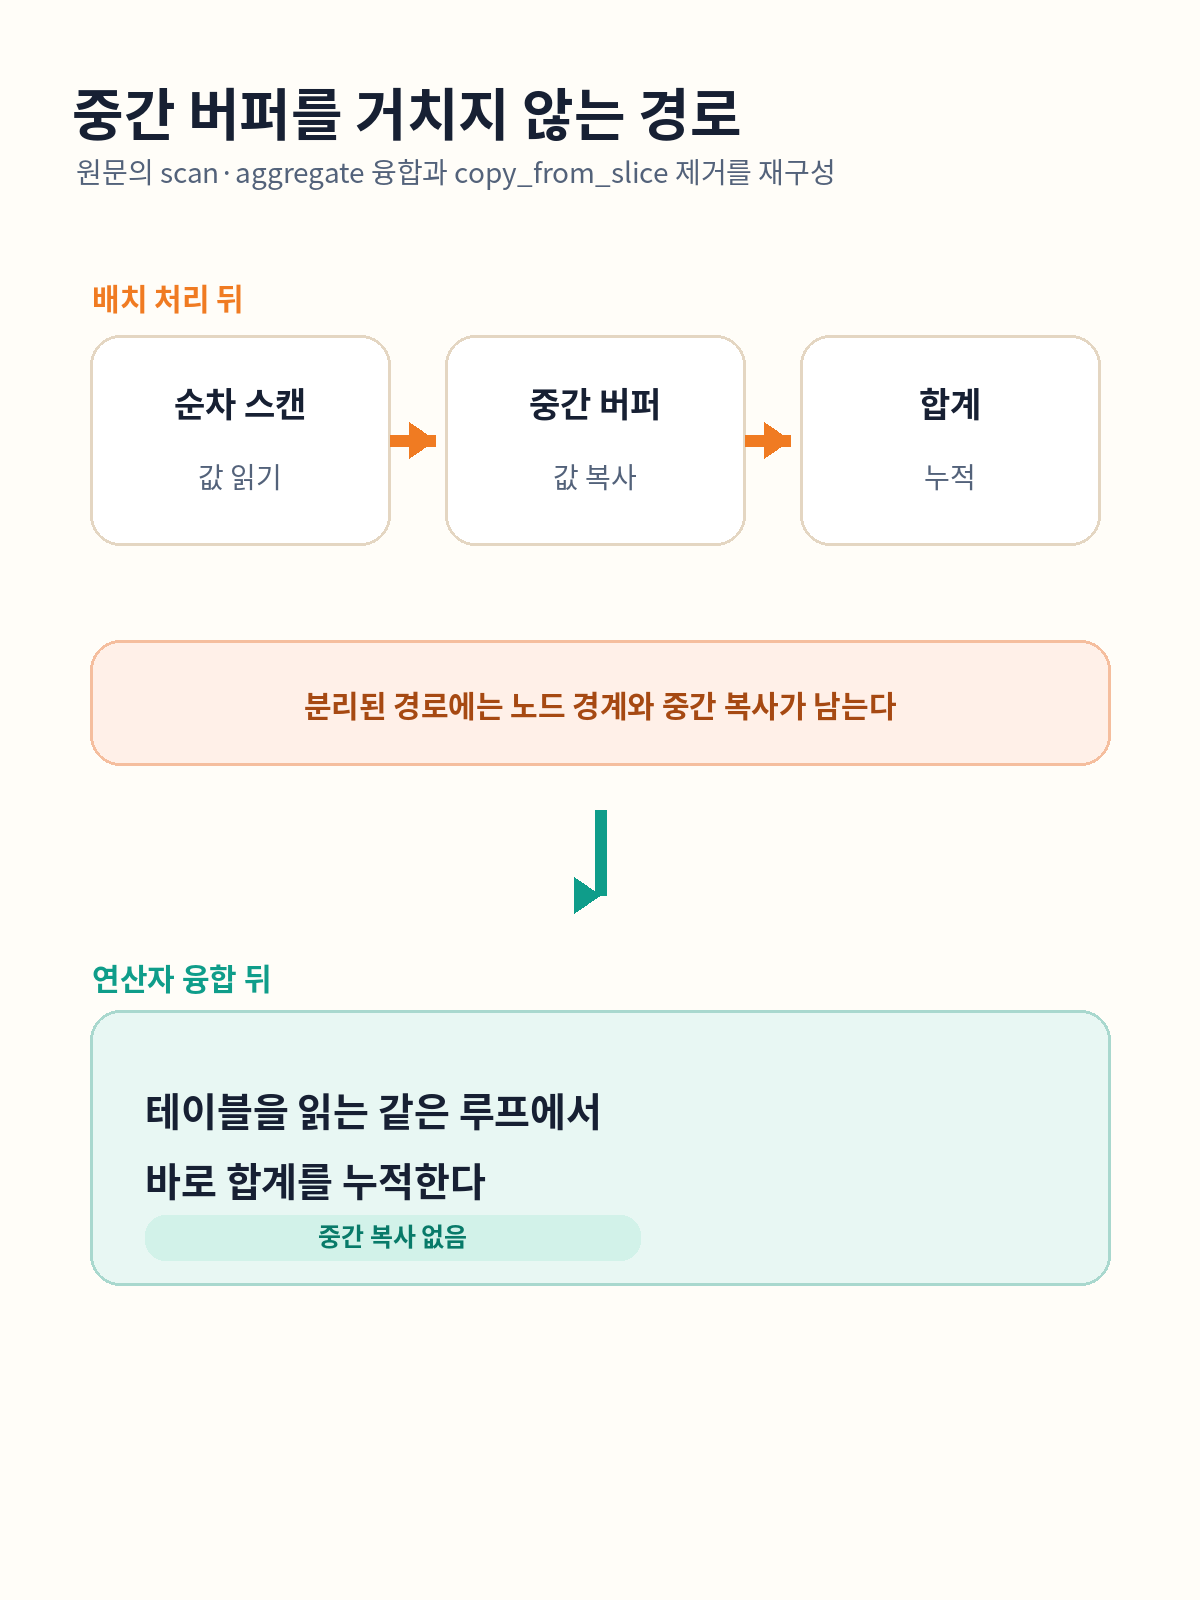
여기서 속도를 단순히 ‘1,024배’라고 읽으면 안 된다. 배치마다 값을 복사하는 copy_from_slice가 새 병목이 되기 때문이다. 배치는 실행기 경계를 통과하는 비용을 낮추지만, 스캔 노드와 집계 노드가 분리된 설계 자체는 그대로 남긴다.
연산자 융합은 복사 경계를 없애는 선택이다
두 번째 단계인 연산자 융합은 자주 함께 쓰이는 노드 둘을 하나의 노드로 바꾼다. 이 사례에서는 순차 스캔과 합계를 합쳐, 테이블의 값을 읽는 루프 안에서 곧바로 누적한다. 중간 배치 버퍼도 copy_from_slice도 사라진다. 저자가 제시한 융합 버전은 일반 for 루프와 같은 코드가 되어 약 358ms에 도달했다.
대신 모든 쿼리 조합을 미리 융합할 수는 없다. 저자도 몇 가지 흔한 경우는 하드코딩할 수 있지만 준비하지 않은 경우가 곧 나타난다고 설명한다. 그래서 글은 쿼리마다 알맞은 코드를 생성해 융합을 일반화하는 JIT를 다음 주제로 예고한다. 이 지점에서 얻을 실무적 판단은 명확하다. 범용 실행기에는 조합성이 필요하고, 매우 빈번한 분석 경로에는 범용 경계를 건너뛰는 특수화가 필요하다.
SIMD는 같은 명령으로 여러 값을 더한다
마지막 단계는 ARM64용 SIMD다. SIMD는 하나의 CPU 명령으로 여러 데이터 조각에 같은 연산을 적용한다. 저자의 구현은 8개 f64 값 묶음을 읽고 네 개의 2원소 벡터 누산기에 더한다. 결과는 약 135ms, 처음의 축소 Volcano 실행기보다 9.6배 빠르다. 부동소수점 덧셈은 결합법칙이 성립하지 않아 합산 순서가 바뀌면 아주 작은 차이가 날 수 있다. 그래서 컴파일러도 부동소수점 루프를 언제나 SIMD로 바꾸지는 않는다.
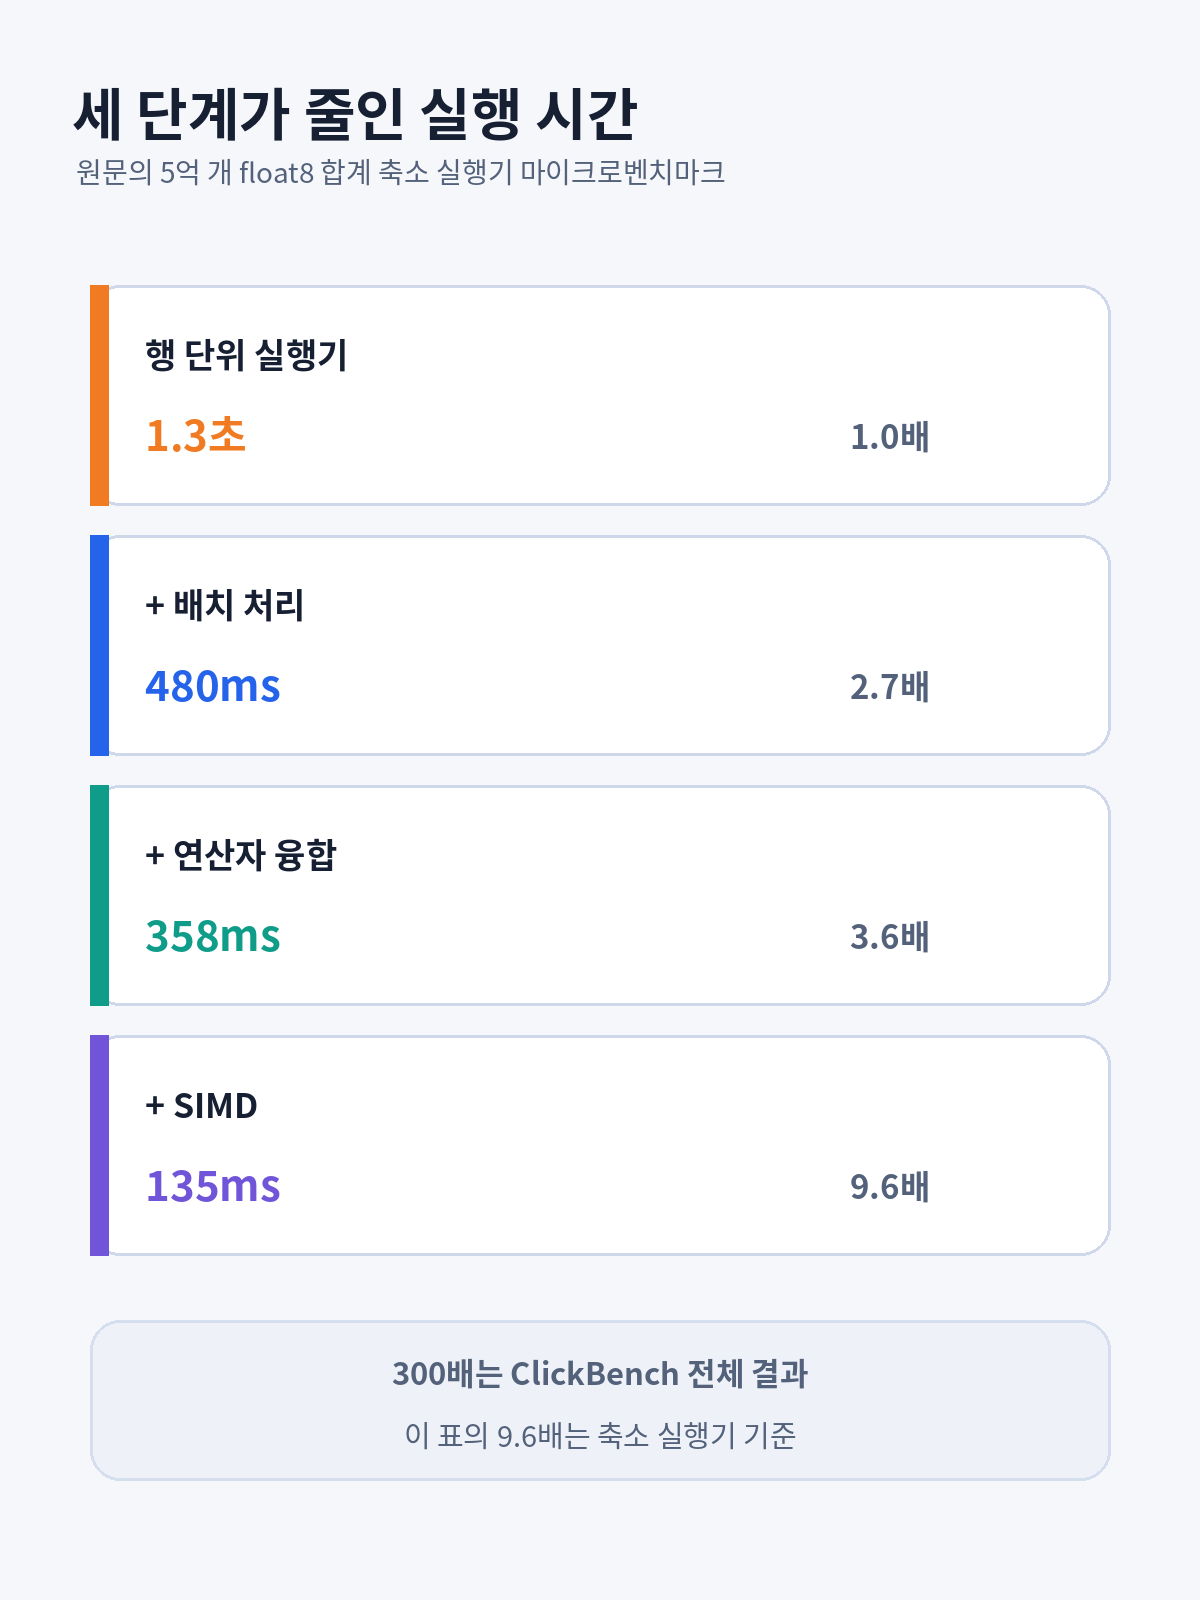
이 표는 PostgreSQL 일반 쿼리가 언제나 9.6배 또는 300배 빨라진다는 약속이 아니다. 300배는 ClickBench 전체 결과에 관한 저자의 수치이고, 9.6배는 데이터가 메모리에 올라와 있고 병렬 실행을 끈 단일 합계 마이크로벤치마크의 수치다. 그럼에도 세 단계는 분석 엔진을 볼 때 유용한 순서를 제시한다. 먼저 행 단위 호출을 배치로 줄이고, 다음으로 불필요한 중간 복사와 실행기 경계를 없애며, 마지막으로 하드웨어가 한 번에 처리할 수 있는 데이터 폭을 쓴다. 분석 워크로드의 성능은 알고리즘 이름보다 이 세 경계에서 먼저 갈린다.