
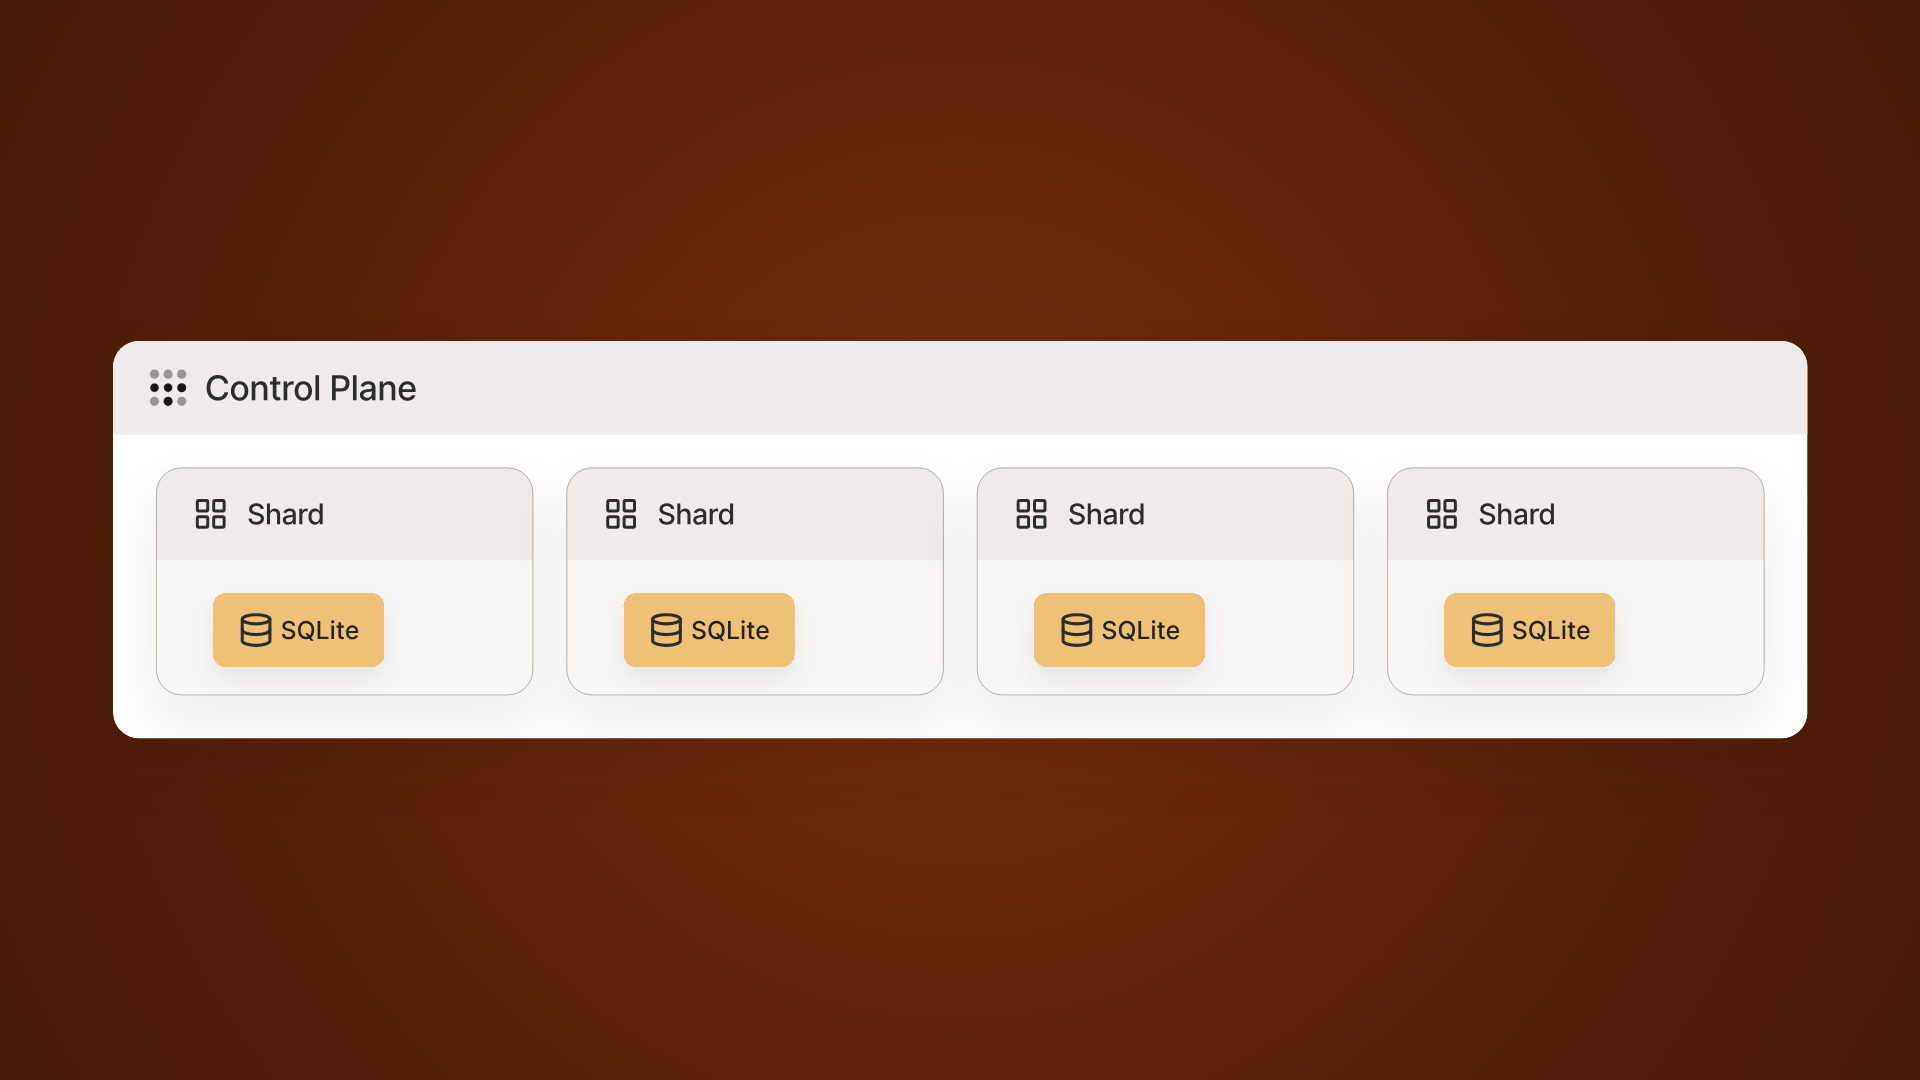
드문 데이터베이스 오류는 대개 로그 한 줄로 끝난다. 그런데 서비스가 수백 개의 작은 제어 평면으로 나뉘어 있고, 그중 한 조각이 멈추면 사용자의 새 연결과 관리 작업이 함께 막힌다면 이야기가 달라진다. Tailscale은 2025년 하반기부터 6개월 동안 SQLite 데이터베이스 손상 19건을 겪었고, 그때마다 해당 샤드의 제어 평면을 멈춰 복구해야 했다.
원인은 SQLite의 WAL(Write-Ahead Log) 체크포인트와 쓰기 트랜잭션이 아주 좁은 순간에 겹칠 때 생기는 경합이었다. SQLite 개발진은 이 결함을 WAL-Reset 버그라고 부르고, 적어도 16년간 코드에 있었을 것으로 추정했다. 2026년 3월 배포된 SQLite 3.51.3의 수정 내역에도 이 데이터베이스 손상 버그의 수정이 기록돼 있다.
한 샤드의 손상이 왜 서비스 장애로 이어졌나
Tailscale의 공개 제어 평면은 하나의 주소처럼 보이지만, 내부에서는 여러 샤드가 각자 일부 tailnet을 맡는다. 샤드 하나에는 SQLite 데이터베이스 하나가 있고, 단일 Go 프로세스가 그 파일에만 접근한다. SQLite가 권장하는 단일 작성자 구조다. 문제는 손상된 파일을 수리하거나 백업본으로 되돌리는 동안 그 샤드의 제어 평면을 중지해야 한다는 데 있었다.

이미 연결된 기기끼리의 WireGuard 통신은 계속될 수 있었다. 하지만 장애 중에 새 기기가 온라인이 되면 제어 평면에서 다른 기기 목록을 받아야 하므로 연결을 시작할 수 없었다. 네트워크 구성 변경, 웹 관리 콘솔, Tailscale API도 그 샤드에서는 멈췄다. 초기 복구는 한 시간을 넘겼고, 이후 자동화로 시간을 줄였다. 영향 범위가 제한돼도 반복 장애가 상태 페이지에 남으면 서비스 신뢰는 따로 쌓인다는 점이 더 까다롭다.
백업 복구 기록이 사라진 쓰기를 드러냈다
원인을 바로 재현할 수 없었던 Tailscale은 손상 뒤의 복구 절차부터 바꿨다. 백업본만 되돌리면 백업 이후 변경분이 사라질 수 있으므로, 데이터베이스를 바꾸는 모든 SQL 문을 별도 로그에 남겼다. 단일 작성자 SQLite의 트랜잭션 이력은 순서가 하나로 정해져 있어, 마지막 정상 백업에 그 로그를 다시 적용할 수 있었다.
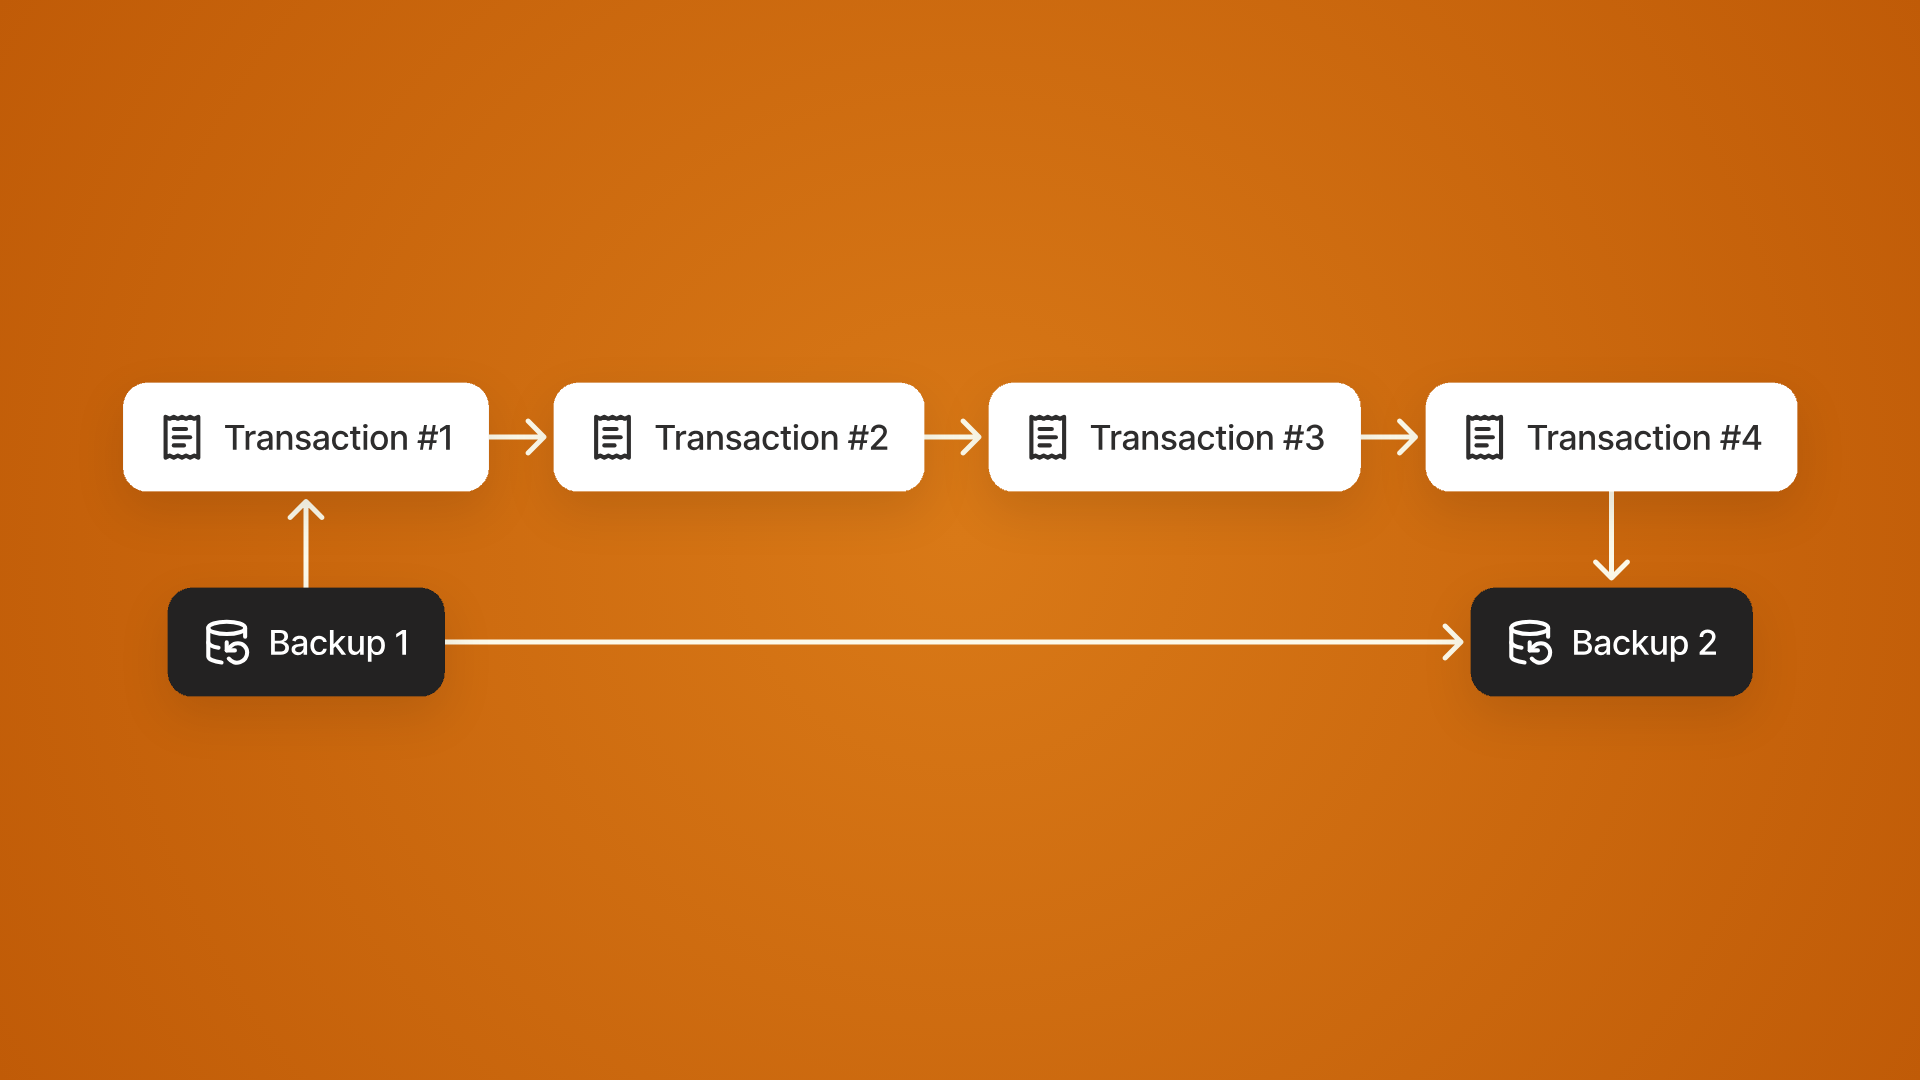
이 복구 경로는 두 차례 예상과 다르게 멈췄다. 한 트랜잭션이 이미 커밋한 데이터가 뒤의 트랜잭션에는 보이지 않았다. 오류도 없었다. 손상 여부를 검사하는 것만으로는 잡기 어려운 증상이었지만, 재실행 가능한 변경 이력이 있어야 이 모순을 구체적인 데이터 흐름으로 확인할 수 있었다.
WAL 체크포인트에서 빠진 페이지는 어디로 갔나
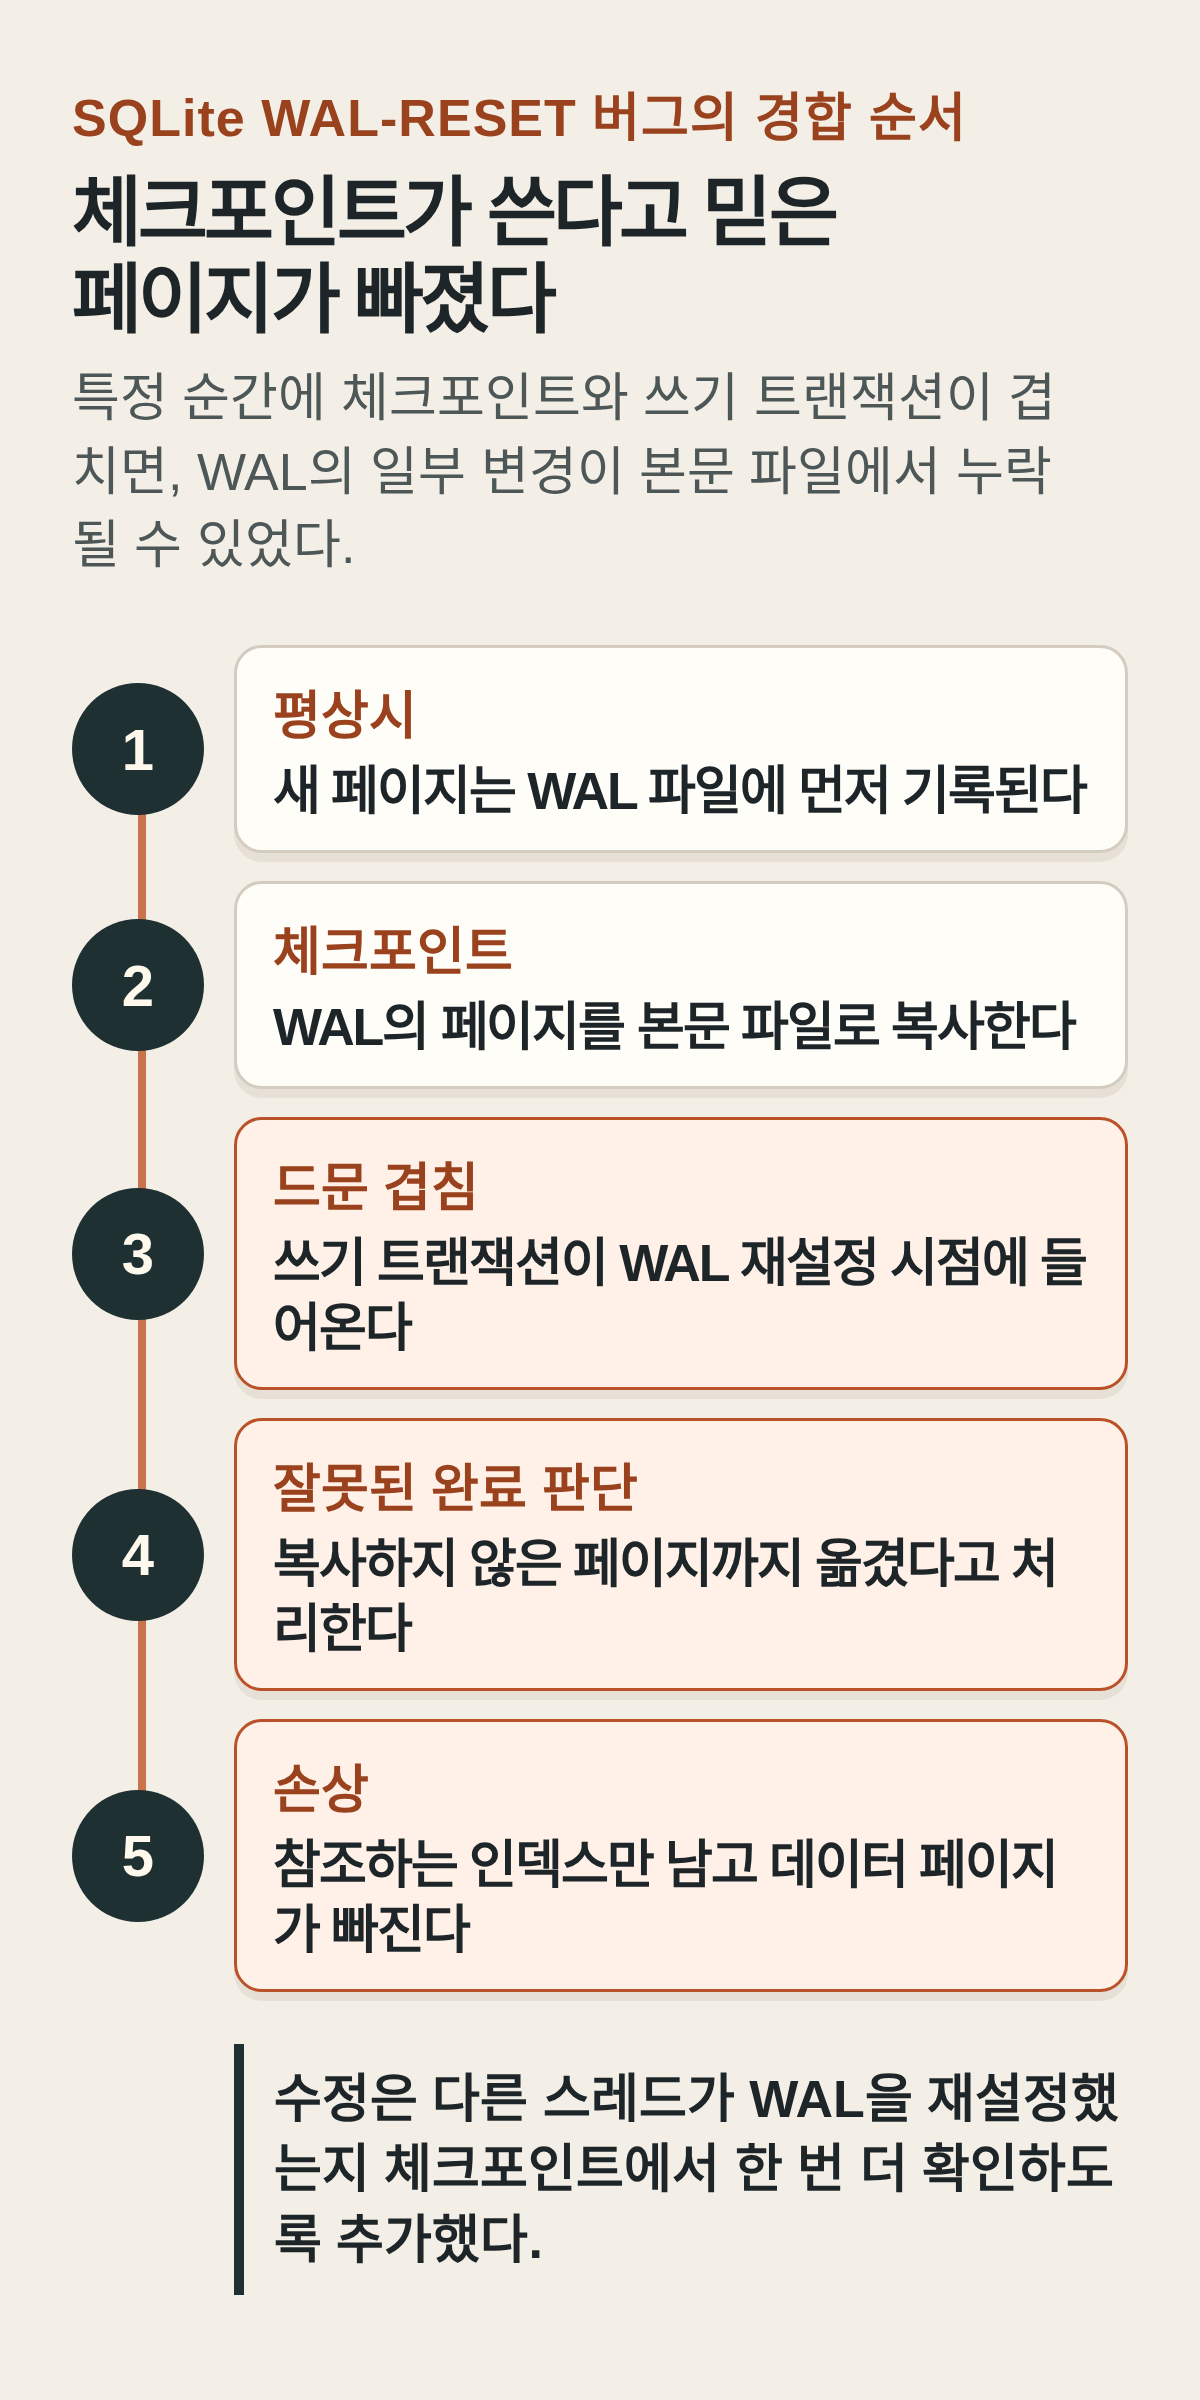
WAL 모드에서 SQLite는 변경된 페이지를 데이터베이스 본문 파일에 곧바로 쓰지 않고 WAL 파일에 먼저 기록한다. 시간이 지나면 체크포인트가 WAL의 페이지를 본문 파일로 옮긴다. Tailscale은 빠르고 일정한 백업을 위해 이 체크포인트를 직접, 자주 실행했다. 일반적인 배포에서는 SQLite가 이 시점을 관리한다.
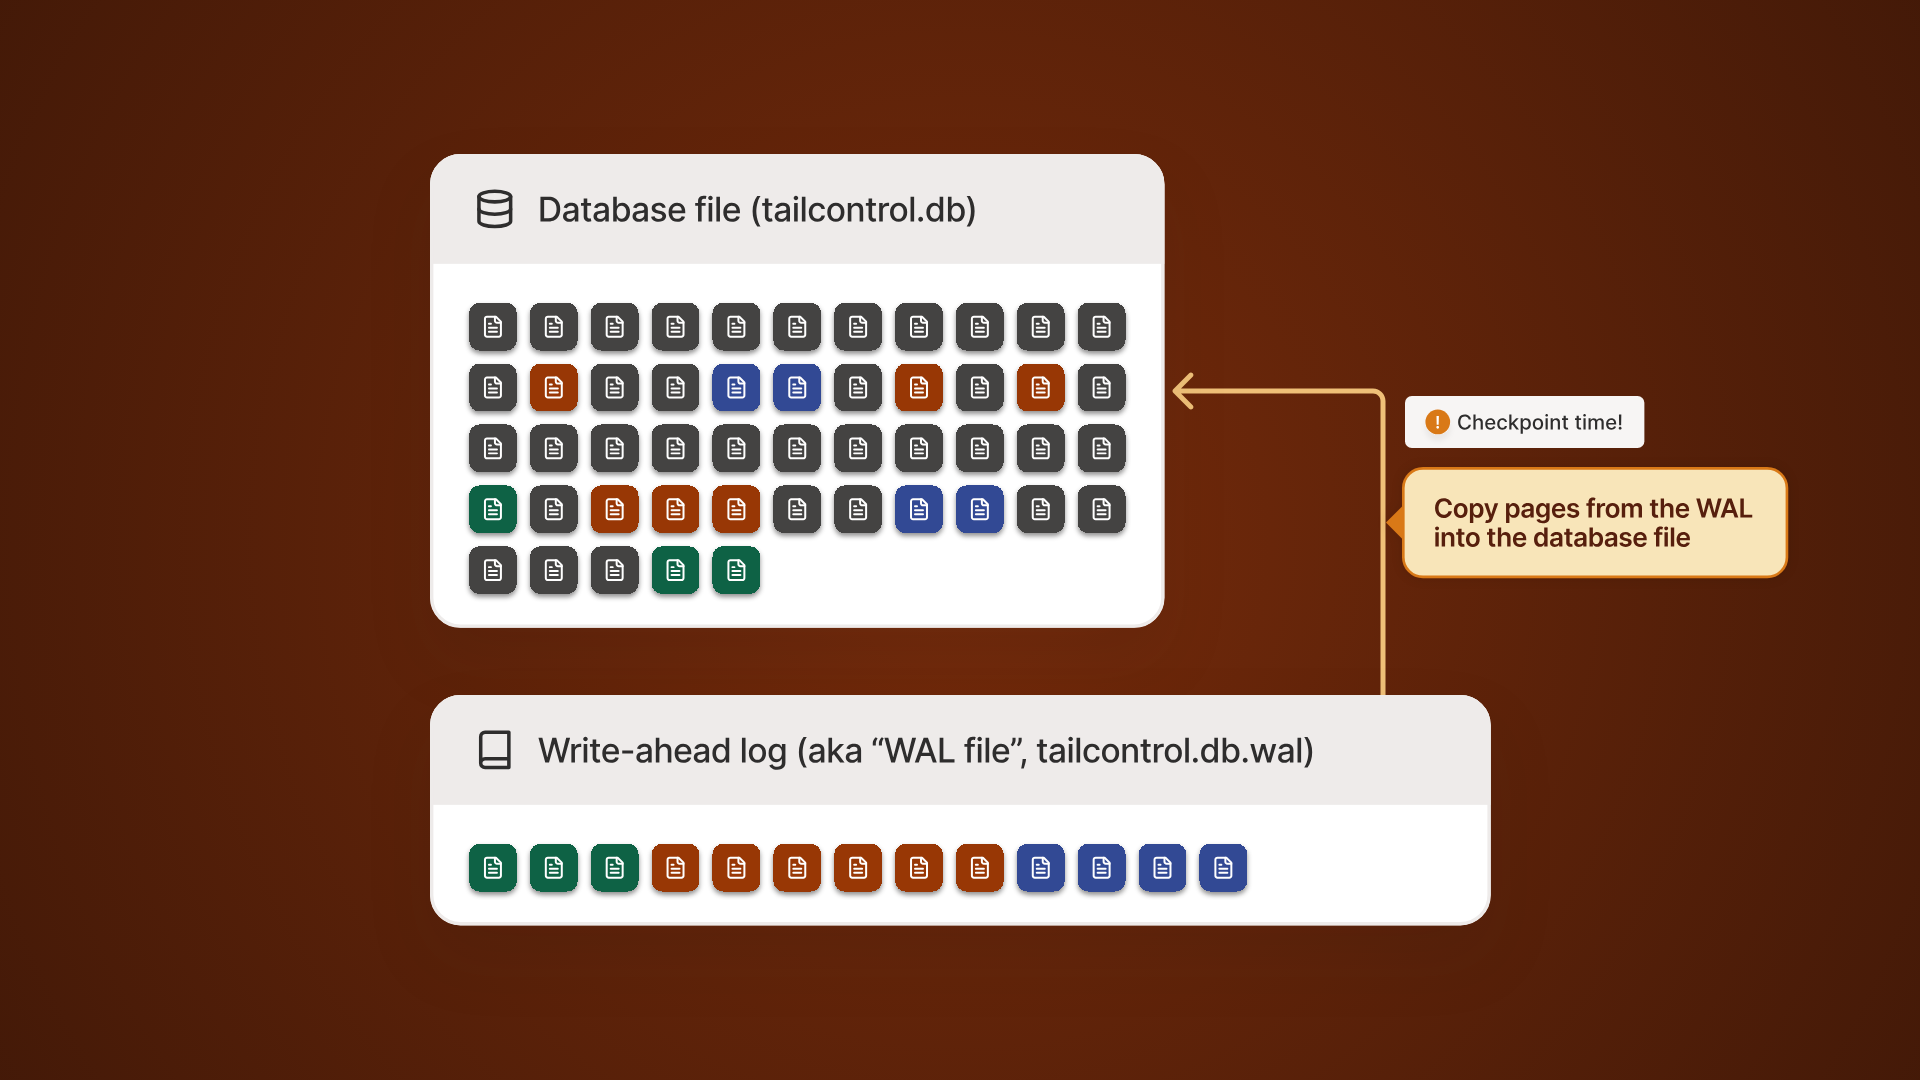
문제가 발생한 체크포인트에서는 WAL에 있는 양보다 많은 페이지를 복사했다는 수치가 관측됐다. SQLite 개발진은 가상 파일시스템 계층에 추적 정보를 남기는 tmstmpvfs 래퍼를 만들었고, 다음 손상 때 수집한 로그에서 경합을 찾았다. 쓰기가 특정 시점에 들어오면 체크포인트가 일부 페이지를 이미 옮겼다고 오인했다. 실제로는 그 페이지가 본문 파일에 기록되지 않아 데이터가 사라지고, 그 페이지를 가리키는 인덱스 같은 다른 구조만 남아 파일 일관성이 깨졌다.
수정 뒤에도 배포 검증은 한 번 더 필요했다
WAL-Reset 수정이 담긴 초기 SQLite 3.52.0 배포 뒤에는 다른 문제가 나타났다. Tailscale의 고정밀 타임스탬프 텍스트를 부동소수점으로 바꾸는 과정에서 반올림 동작이 달라졌고, 생성 열의 표현식 인덱스가 오래된 값으로 남아 PRAGMA integrity_check가 손상으로 보고했다. 실제 파일 손상은 아니었다. SQLite는 3.52.0을 철회하고 WAL-Reset 수정만 담은 3.51.3을 내놓았다.
Tailscale은 쓰기와 WAL 재설정이 겹칠 때 경고를 남기도록 드라이버도 바꿨다. 수정 후 두 달이 지나 이 경고가 한 번 발생했지만 데이터베이스는 손상되지 않았다. 이후 원문 작성 시점까지 넉 달 동안 같은 유형의 데이터베이스 사고는 없었다. 이 사례에서 남는 운영상의 요지는 단순하다. 드문 오류를 없애는 일은 패치 하나로 끝나지 않는다. 장애를 격리하는 구조, 변경을 되짚을 기록, 그리고 수정이 실제 경합을 막았다는 관측이 함께 있어야 서비스 장애의 고리가 끊어진다.
출처: Tailscale, How we tracked down a 16-year-old SQLite bug 및 SQLite 3.51.3 릴리스 노트 (2026-08-13 확인)