
코드가 빨리 나오면 만들고 싶은 것의 목록부터 길어진다. 검색 도구가 느리면 검색 엔진을 고치고, 컴파일이 답답하면 빌드 도구까지 손댈 수 있다. 개발자 댄 루(Dan Luu)는 최근 에세이에서 이런 일이 개인의 여가 시간에도 가능해졌다고 썼다. 동시에 자신이 다루는 작업에서는 모델이 구현할 수 있는 범위와 큰 도움 없이 검증할 수 있는 범위의 간격이 오히려 벌어지고 있다고 지적했다.
이 두 관찰은 충돌하지 않는다. 전에는 시도할 엄두가 나지 않던 것을 만들 수 있게 됐지만, 그 결과를 어디까지 믿어도 되는지는 여전히 따로 판단해야 한다. 작은 팀이 새 기능이나 내부 도구의 범위를 정할 때에도 유용한 구분이다.
내 도구를 고치는 일이 언제부터 현실적인 선택이 됐나
루는 자신의 작업에 맞춘 정규식 엔진과 텍스트 검색 도구 ripgrep의 수정판, Rust 빌드 시간을 줄이는 작업을 예로 들었다. 예전 같으면 자신에게 쓸 만한 수준까지 만드는 데만 1년 이상 걸렸으리라 본 일을, 이제는 자기 시간 몇 시간으로 시도했다는 설명이다. 여기서 말하는 완성도는 ‘내 환경에서 쓸 수 있다’는 수준이다. 다른 사람이 설치하고 계속 사용할 공개 도구로 만들려면 훨씬 많은 일이 남는다고도 썼다.
그렇다고 모든 팀이 컴파일러를 새로 만들어야 한다는 뜻은 아니다. 이미 있는 도구를 쓰는 편이 싼지, 특정한 불편을 직접 고치는 편이 싼지 다시 계산할 여지가 생겼다는 이야기다. 루 자신도 검색 성능을 다루면서 텍스트 인덱스가 더 나은 해법임을 인정하고, 해당 수정은 재미로 진행한 프로젝트라고 구분했다. 이 개선은 특정 작업에서 얻은 결과이지 범용 성능의 비교는 아니다.
데이터베이스 재작성에서 볼 것은 코드량보다 비교 방식이다
대표적인 사례가 PostgreSQL을 Rust로 다시 구현하는 pgrust다. 루가 이 프로젝트를 주목한 근거에는 테스트 과정에서 기존 PostgreSQL의 버그까지 찾아 신고했다는 사실이 있다. 단순히 새 구현이 실행된다는 데서 멈추지 않고, 기존 구현과 같은 입력에서 같은 동작을 하는지 대조하다가 기준으로 삼은 쪽의 문제도 발견한 것이다.
pgrust 공식 저장소는 이런 차등 퍼징을 검증 방법으로 소개한다. 여러 입력을 만들어 두 구현에 넣고 결과 차이를 찾는 방식이다. 함수 단위의 형식검증과 시뮬레이션 테스트도 병행한다고 설명한다. 한편 공식 README는 아직 운영 환경 사용을 권하지 않으며, 잃어서는 안 되는 데이터의 기준 저장소는 PostgreSQL로 유지하라고 안내한다. 테스트를 많이 했다는 사실과 서비스의 주 데이터베이스로 맡길 준비가 됐다는 판단은 별개다.
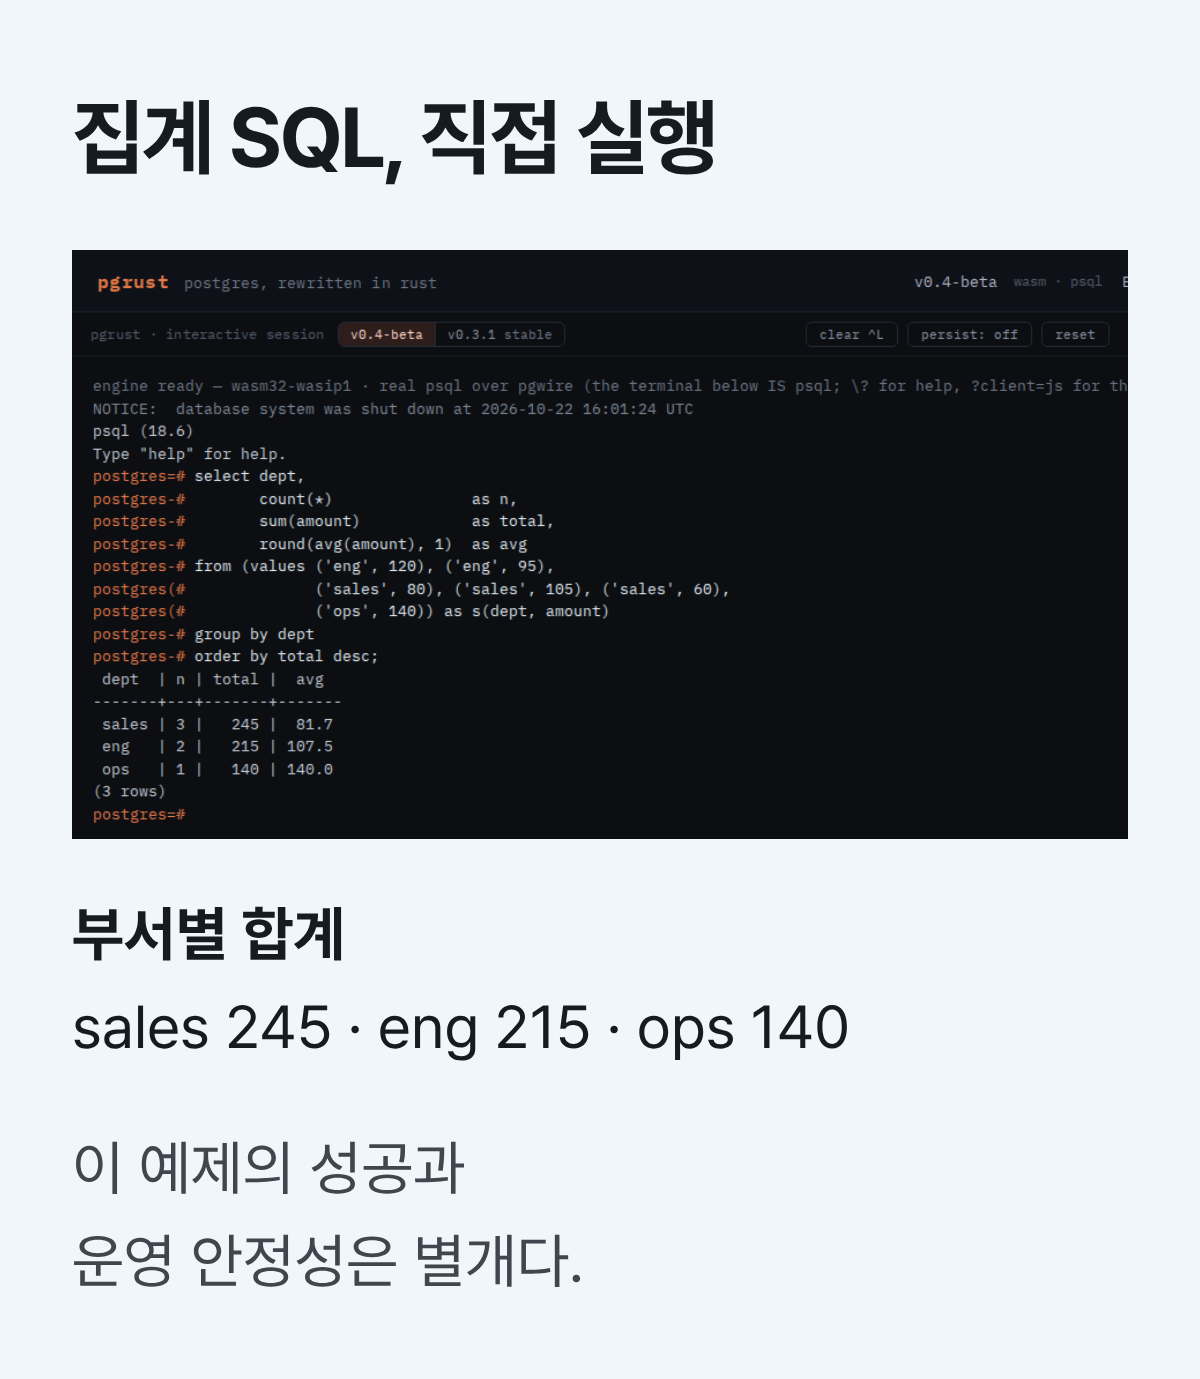
브라우저 체험판에서는 실제 SQL을 실행할 수 있다. 직접 기본 집계 예제를 실행하니 부서별 건수·합계·평균이 세 행으로 반환됐다. 이것으로 확인되는 것은 해당 브라우저 빌드가 그 예제를 처리한다는 사실이다. 장애 뒤 복구나 다양한 동시 접속 상황까지 한 번의 성공 화면에 담겨 있지는 않다.
한 번 통과한 테스트가 놓치는 것은 무엇인가
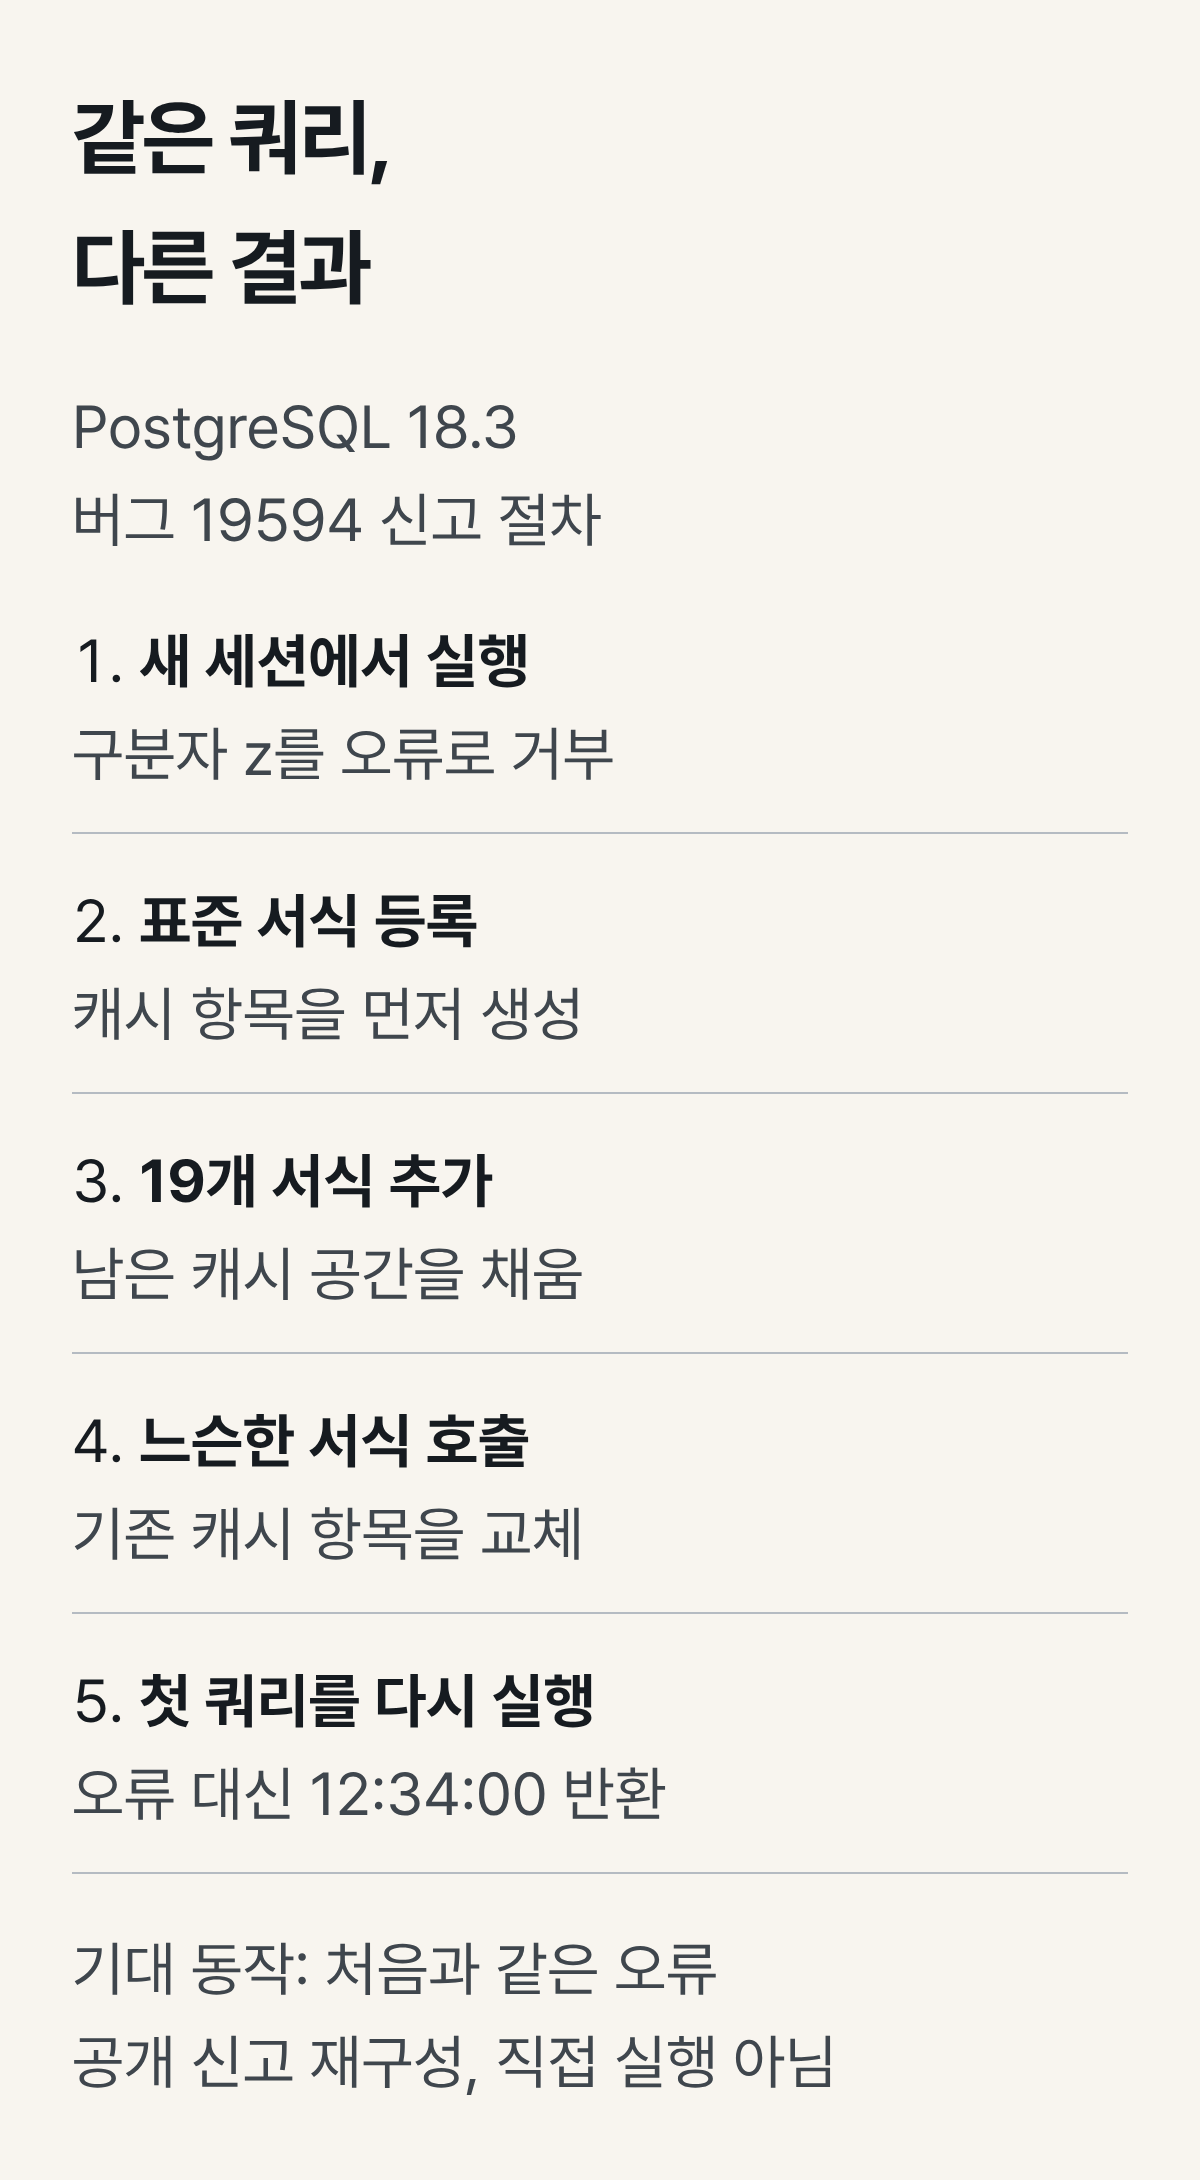
마이클 말리스가 PostgreSQL 공식 버그 게시판에 올린 19594번 신고는 검증 범위가 왜 중요한지 보여 준다. PostgreSQL 18.3의 같은 세션에서 같은 날짜·시간 변환 쿼리를 실행해도, 그전에 어떤 서식 변환을 했는지에 따라 답이 달라졌다. 처음에는 허용되지 않는 구분자 ‘z’를 오류로 거부하지만, 캐시를 채우고 교체하는 절차를 거치면 같은 쿼리가 값을 반환한다는 재현 사례다.
문제는 캐시 항목을 재사용할 때 엄격한 표준 모드 여부를 나타내는 값이 갱신되지 않는 데 있었다고 신고서는 설명한다. 새 세션에서 정상 입력 몇 개만 시험했다면 놓치기 쉬운 종류다. 입력뿐 아니라 앞선 실행 이력까지 조건에 넣어야 차이가 드러난다. 루의 에세이가 말하는 검증의 부담도 이런 데서 구체화된다. 구현할 수 있는 기능이 늘수록, 그 기능이 틀릴 수 있는 조건을 찾는 일도 넓어진다.
작업 범위는 성공을 판별할 방법과 함께 넓혀야 한다
원문 부록에는 요시 크레이닌(Yossi Kreinin)의 반론도 실려 있다. 많은 문제에는 분명한 통과·실패 기준이 없고, 기준을 줄 수 있어도 커다란 구현의 내부를 이해하며 관리하기가 어렵다는 지적이다. 특정 사용 사례에 맞춰 빨라진 코드가 다른 사례에서도 빠르거나 이후 변경에도 유지보수하기 좋으리라는 보장은 없다.
루는 자동으로 일부를 점검할 구조를 마련할 수 있는 문제도 생각보다 많다고 답한다. 퍼징이나 속성 기반 테스트처럼, 사람이 예제마다 정답을 적는 대신 지켜야 할 성질을 검사하는 방법이다. 테스트 자체가 잘못된 구현을 구별하는지도 함께 확인해야 한다. 이 주장을 업무에 적용하면 기능 목록을 늘리기 전에 ‘틀렸을 때 무엇으로 알아챌 것인가’를 설계하는 쪽에 가깝다. 기존 도구와 결과를 비교할 수 있는 변환 작업인지, 사람이 판단해야 하는 해석이 섞였는지에 따라 접근이 달라진다.
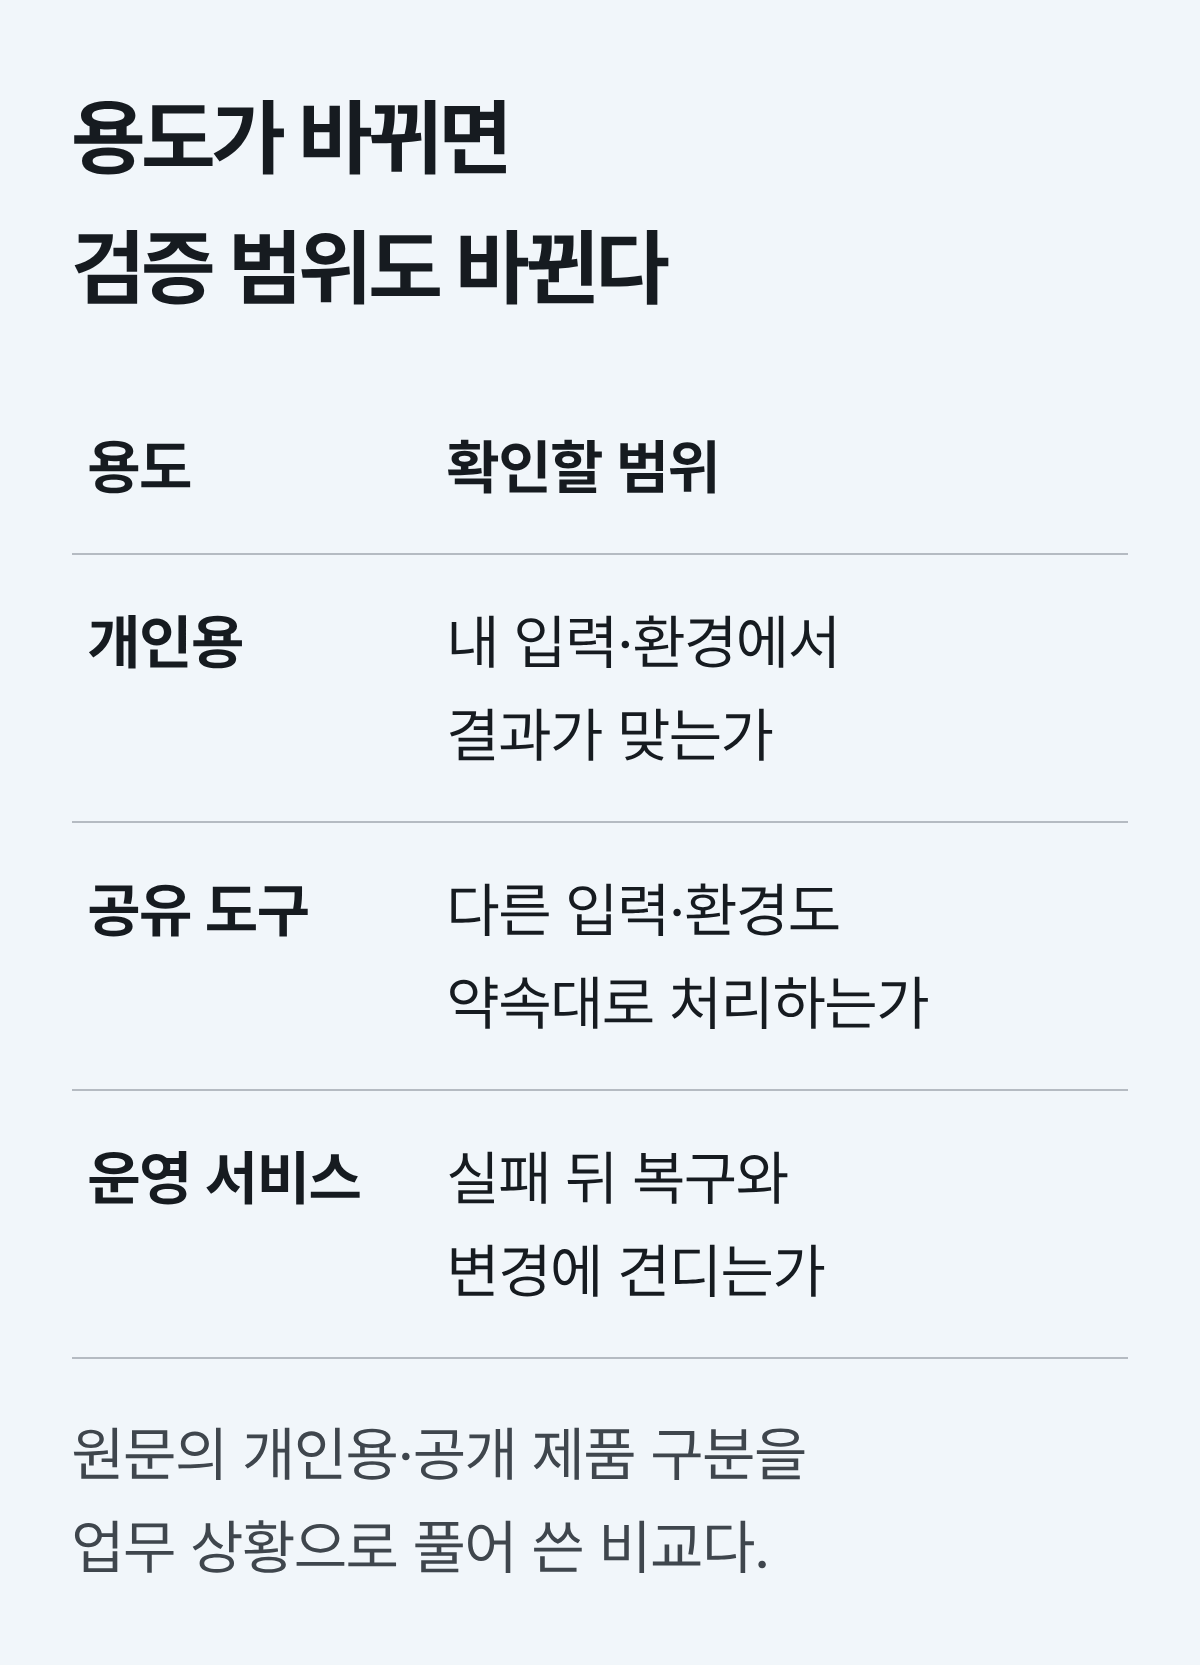
팀에서는 성공 화면 하나를 얻는 단계와 다른 사람의 데이터를 맡기는 단계를 일정에서 분리할 수 있다. 내부 파일 변환기라면 원본을 보존한 채 기존 결과와 대조하고, 낯선 입력은 별도로 남기는 식이다. 여러 사람이 쓰기 시작하면 지원할 입력 범위와 오류 처리, 변경 뒤 다시 확인할 사례를 더 정해야 한다. 이런 조건이 정리돼야 구현 비용이 낮아진 이점을 실제 배포 범위로 옮길 수 있다.
새 도구를 만들지 않기로 했던 과거의 판단은 다시 살펴볼 만하다. 다만 이번에 싸진 것이 코드 작성인지, 신뢰할 수 있는 도구를 유지하는 전체 비용인지는 구별해야 한다. 루의 사례에서도 개인용 실험과 공개 제품 사이에 남은 일은 사라지지 않았다.
출처: Dan Luu, “We should be more ambitious with the software we build” · pgrust 검증 방법 및 상태 안내 · PostgreSQL 버그 19594