
주문 관리 화면이 느릴 때 개발 언어부터 바꾸자는 제안이 나오곤 한다. 코드를 더 빨리 실행하는 언어로 옮기면 화면도 그만큼 빨라질 것이라는 기대다. 개발자 션 괴데케(Sean Goedecke)는 10월 23일 글에서 다른 순서를 권했다. 프로그램이 시간을 어디에 쓰는지 살피고, 하던 일을 줄이는 설계부터 찾자는 것이다.
사용자가 기다리는 시간에는 계산만 들어 있지 않다. 데이터베이스에서 정보를 받아 오거나 외부 서비스가 응답하기를 기다리는 시간도 포함된다. 처리 언어가 바뀌어도 같은 데이터를 같은 횟수로 요청한다면, 그 기다림은 남는다. 서비스 재작성에 예산과 일정을 쓰기 전에 구분해야 할 문제다.
계산을 빨리 해도 기다리는 시간은 남는다
괴데케는 요청 시간의 절반을 데이터베이스 조회에 쓰는 웹사이트를 예로 든다. 이 조건에서 나머지 계산 시간을 완전히 없애도 전체 속도의 개선 상한은 2배다. 이는 특정 서비스의 측정치가 아니라, 바꾸지 못하는 구간이 전체 개선 폭을 제한한다는 설명이다.
오래 걸리는 연산이 이미 빠른 라이브러리 안에서 실행되는 경우도 있다. 파이썬으로 작성한 프로그램이라도 행렬 연산은 최적화된 네이티브 코드나 GPU가 처리할 수 있다. 바깥의 파이썬 코드를 다른 언어로 옮기는 일과, 실제로 시간을 많이 쓰는 연산을 개선하는 일은 서로 다르다.
어떤 서비스가 대기를 많이 하는지는 실행 기록으로 가려야 한다. 괴데케도 글에 덧붙인 논쟁에서 브라우저의 화면 배치 엔진이나 3차원 렌더러처럼 계산 비중이 큰 작업이 있음을 인정한다. 모든 느린 프로그램의 원인을 데이터베이스로 돌리는 처방은 아니다.
주문 100건을 보여 주는 데 조회 101번이 필요한가
원문에서 제안하는 개선 중 하나는 N+1 조회를 없애는 것이다. 목록을 한 번 읽은 뒤 목록의 각 항목마다 부가 정보를 따로 읽는 패턴을 말한다. 주문을 가져오고, 주문마다 고객 이메일을 다시 요청하는 화면을 생각하면 쉽다. 개별 조회가 짧아도 요청 횟수가 목록 길이와 함께 늘어난다.
이 차이를 보기 위해 격리된 SQLite 메모리 데이터베이스에 예제 고객 100명과 각 고객의 주문 1건씩을 넣고 실행했다. 주문 목록을 읽은 뒤 고객을 건별 조회하자 SELECT가 101회 기록됐다. 두 테이블을 연결하는 JOIN으로 바꾸면 SELECT는 1회였다. 두 방식이 반환한 주문 ID와 이메일 100행도 모두 같았다.
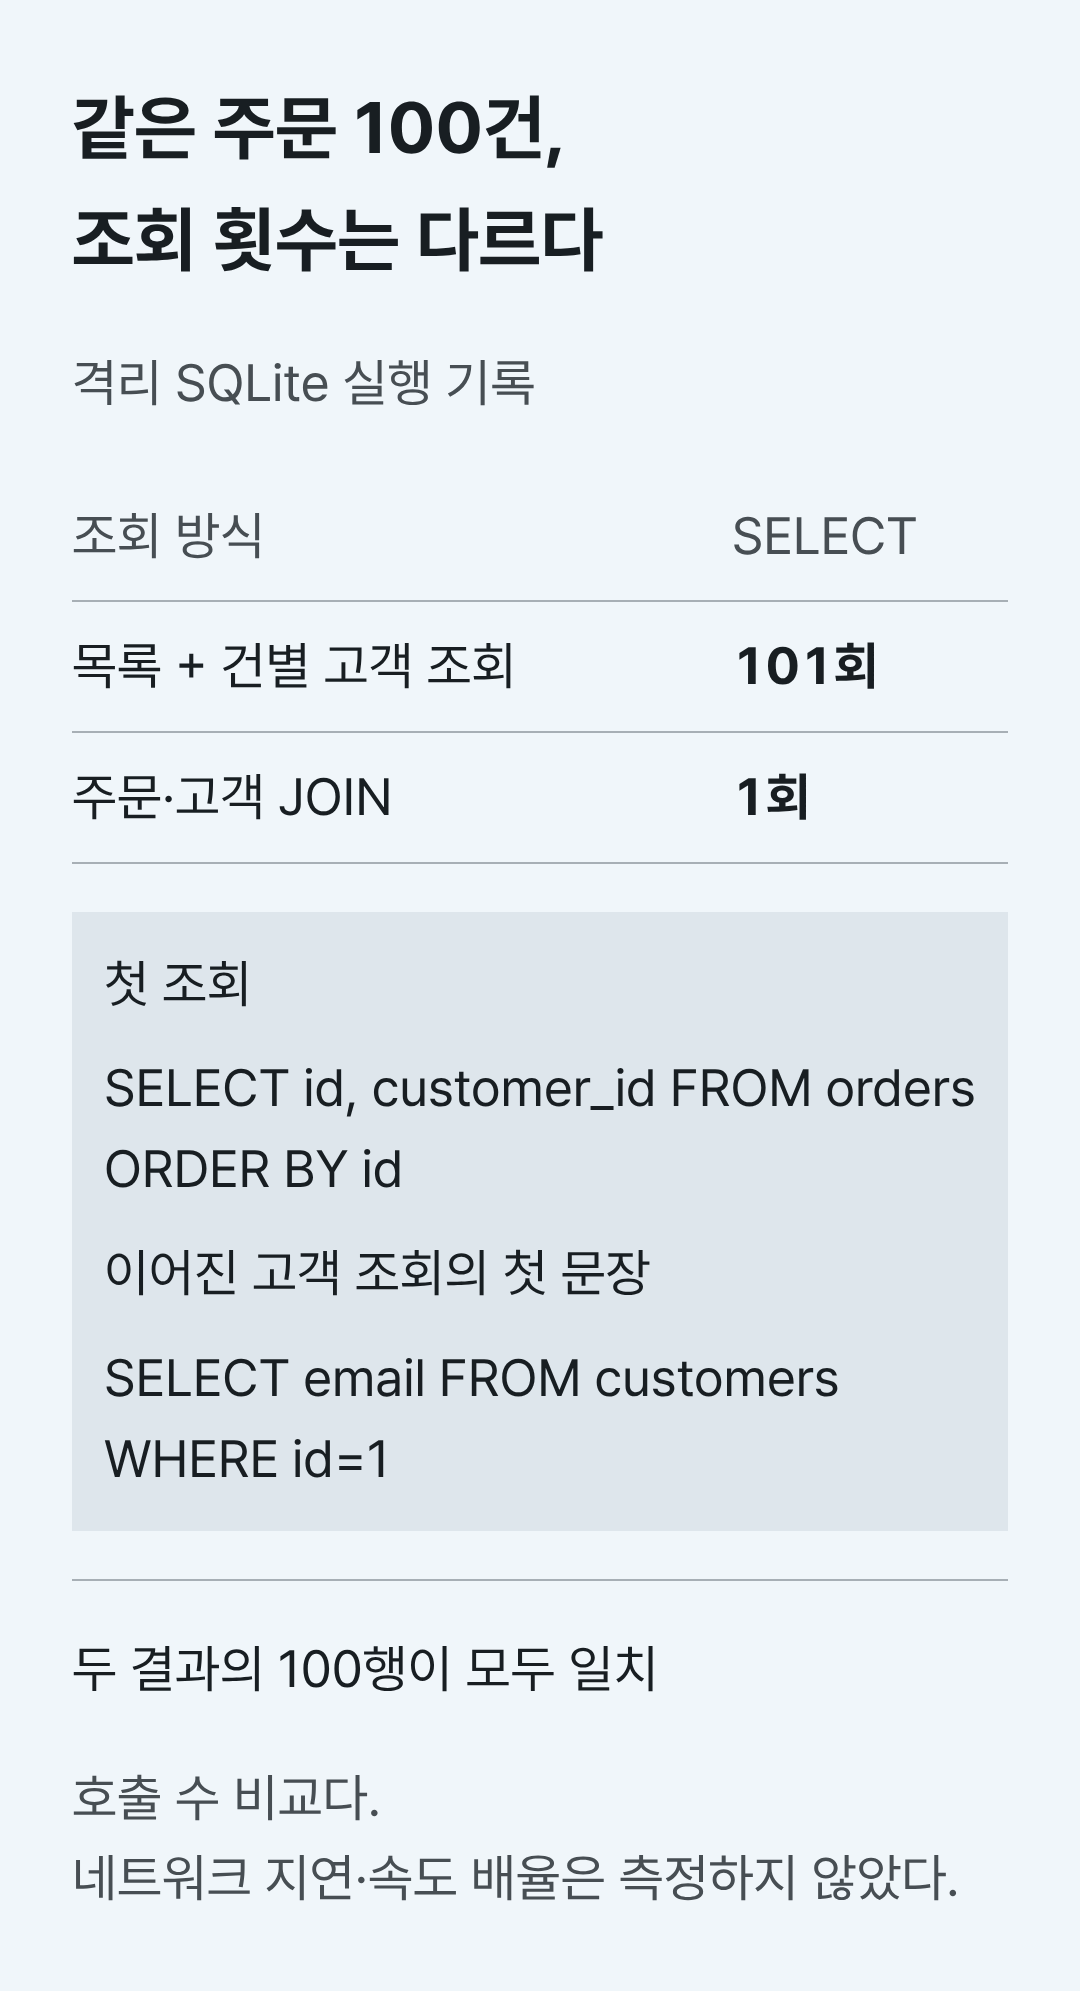
줄어든 것은 조회 호출 수다. SQLite는 프로그램과 같은 프로세스 안에서 동작하므로, 이 결과를 서버형 데이터베이스의 응답 속도 배율로 옮길 수는 없다. SQLite 공식 문서도 작은 조회를 여러 번 하는 방식이 SQLite에서는 효율적일 수 있다고 설명한다. 반면 별도 서버와 통신하는 데이터베이스에서는 건마다 메시지가 왕복한다. 같은 N+1 형태라도 배포 구조에 따라 비용이 달라진다.
운영 화면에서 확인할 것은 “우리도 무조건 JOIN을 써야 한다”가 아니다. 느린 요청 하나가 어떤 조회를 몇 번 내보내는지, 같은 고객 정보를 거듭 읽는지부터 보면 된다. 한 번에 묶은 조회가 너무 큰 결과를 만드는 경우에는 필요한 항목만 모아 가져오는 방식도 비교할 수 있다.
같은 조회문도 데이터를 찾는 방식이 달라진다
호출 수가 적어도 한 번의 조회가 많은 일을 할 수 있다. 고객 이메일로 ID를 찾는 같은 조건에서 인덱스를 추가해 실행 계획을 확인했다. 인덱스가 없을 때 기록은 SCAN customers였다. 이메일 인덱스를 만든 뒤에는 SEARCH customers USING COVERING INDEX customer_email (email=?)로 바뀌었다. 반환된 고객 ID는 양쪽 모두 73이었다.
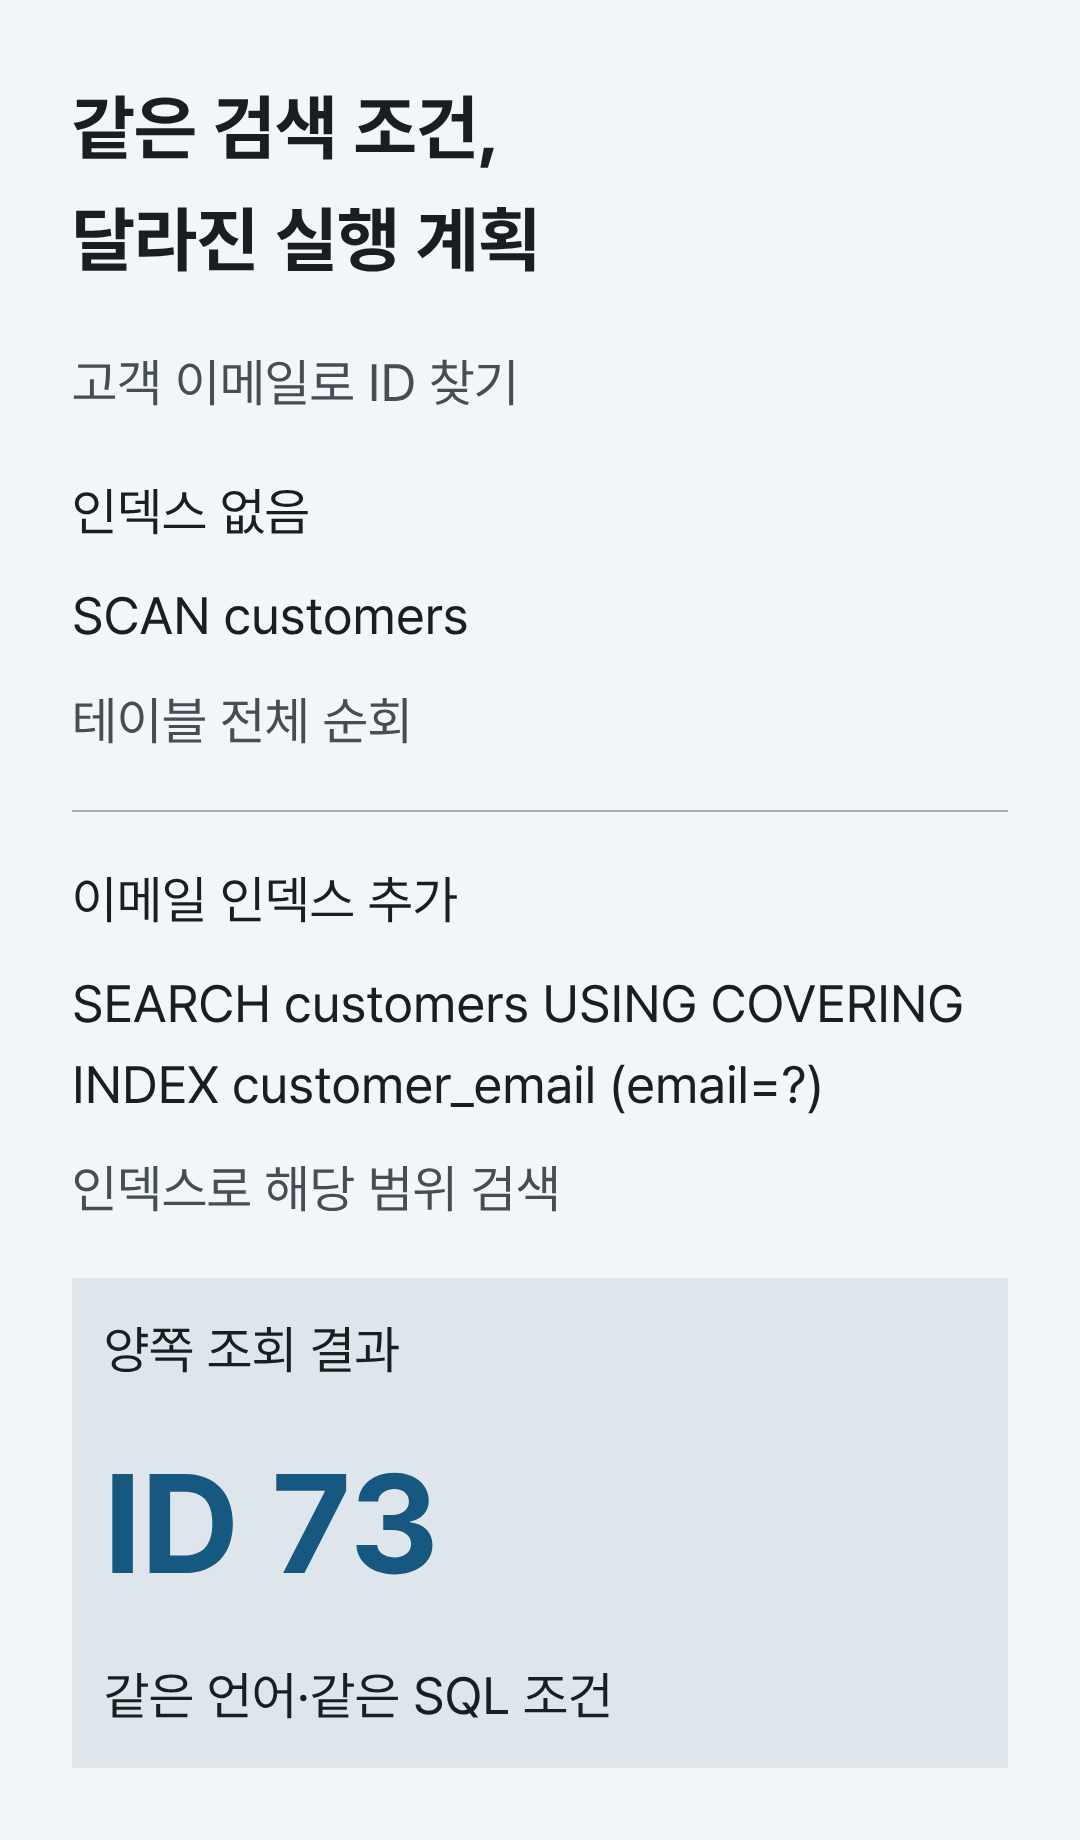
SCAN은 테이블 전체를 순회하는 계획이고 SEARCH는 일부 범위를 찾아가는 계획이다. 위 결과는 속도 측정 대신 데이터 접근 방식이 바뀌었음을 보여 준다. 작은 예제에서 인덱스를 만들었다고 운영 서비스에도 같은 효과가 나오는 것은 아니다. 실제 데이터 분포와 조회 조건을 놓고 계획을 확인해야 하며, 인덱스를 늘리면 저장 공간과 쓰기 작업의 비용도 생긴다.
보여 주지 않을 데이터는 처음부터 덜 가져온다
원문의 또 다른 제안은 페이지에 나오는 항목만 처리하는 것이다. 화면에는 주문 20건을 보여 주면서 전체 주문의 부가 정보를 먼저 읽는다면, 사용자가 보지 않는 부분에도 시간이 든다. 계산을 더 빠르게 하는 대신 계산할 대상을 줄일 수 있는 자리다.
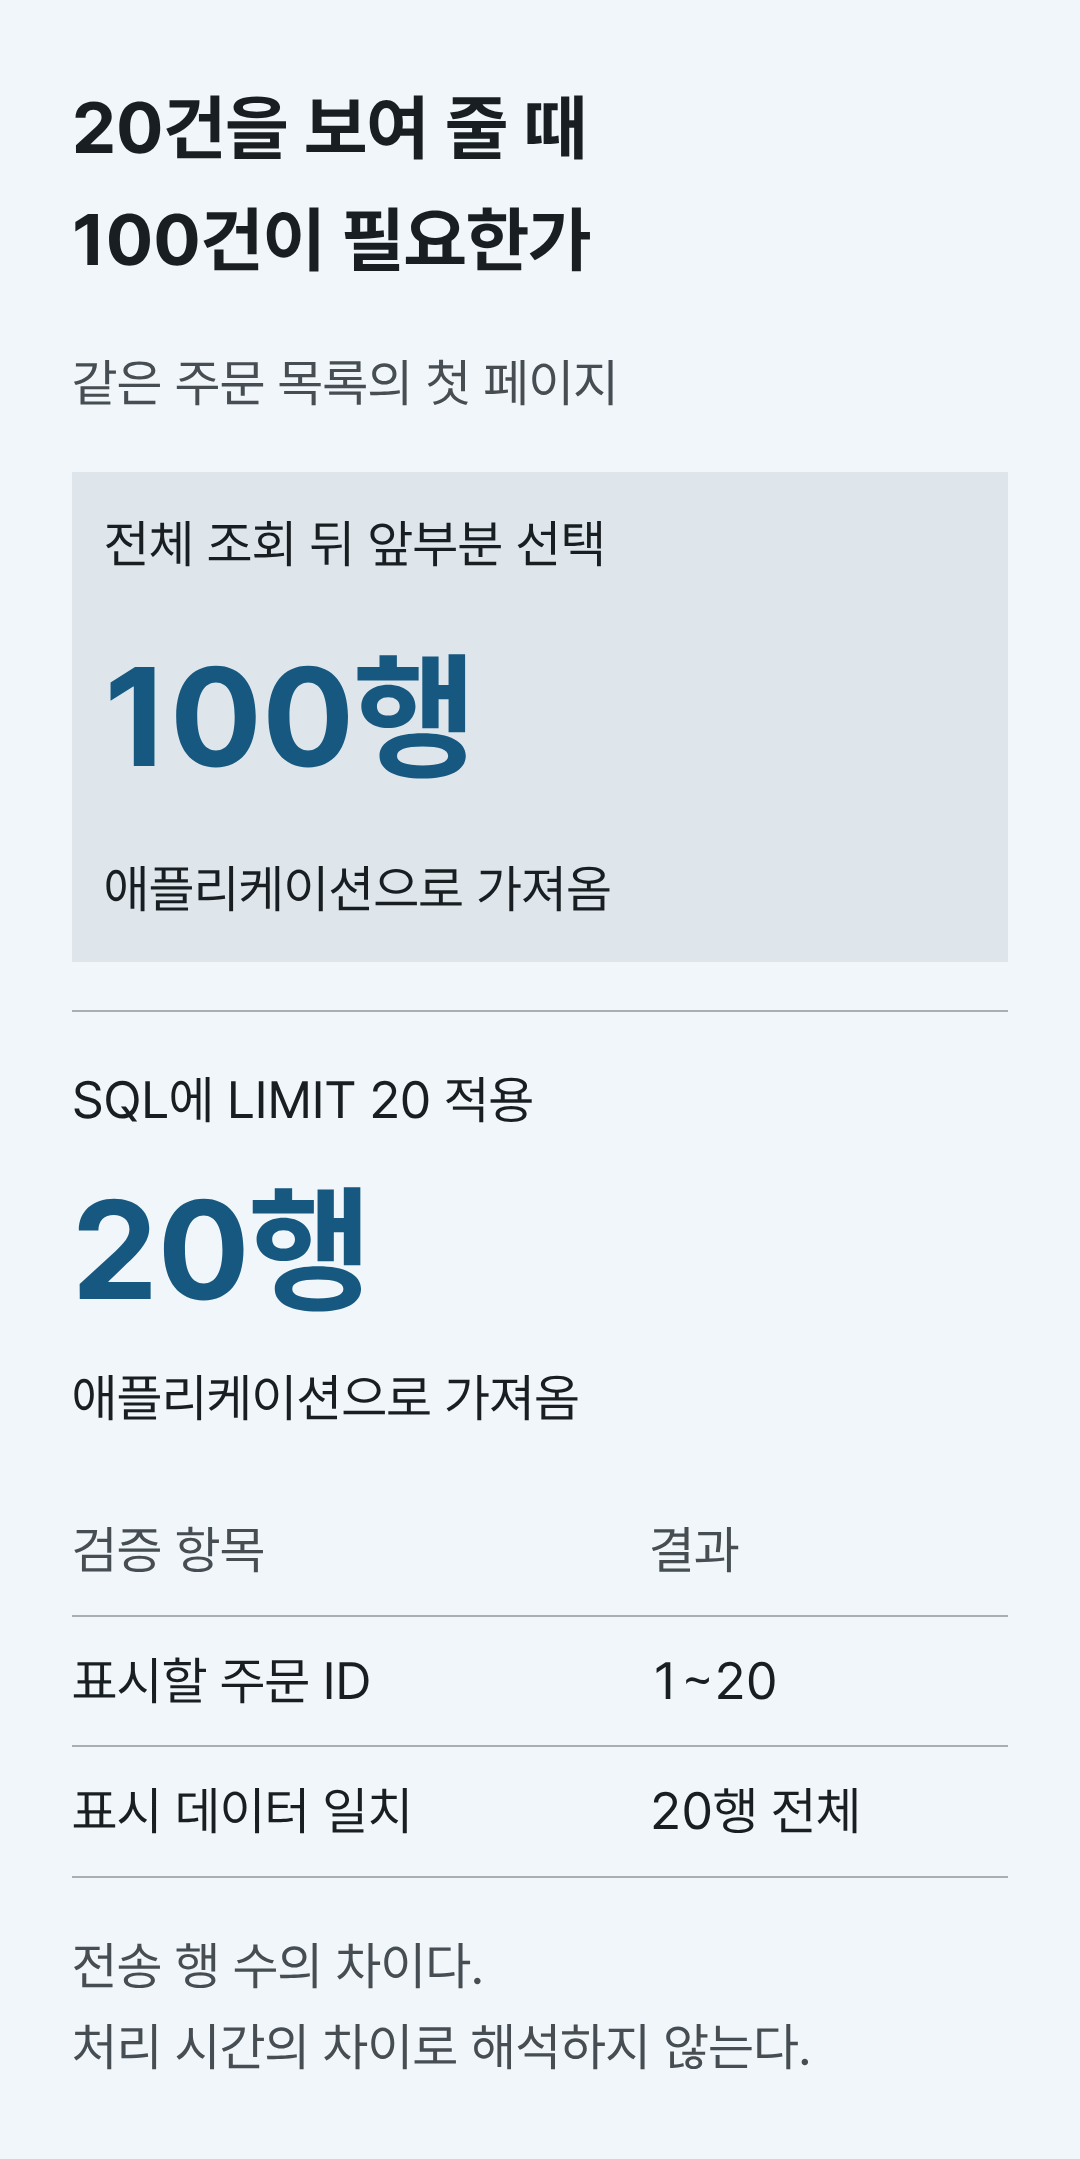
같은 예제에서 주문 100행을 모두 가져온 뒤 앞의 20행을 고르는 방식과, SQL에 LIMIT 20을 넣는 방식을 비교했다. 애플리케이션으로 가져온 행은 각각 100행과 20행이었다. 주문 ID 순으로 정렬했을 때 첫 화면에 쓸 20행은 전부 같았다. 여기서는 반환 행 수를 비교했으며, 뒤에 있는 페이지를 어떻게 찾는지는 별도의 조회 설계 문제다.
재작성 제안보다 먼저 받아야 할 실행 기록
팀이 성능 개선을 논의한다면, 느린 화면이나 요청을 하나 정해 전체 응답 시간에서 데이터 조회와 외부 호출, 계산이 차지하는 구간을 나누는 편이 낫다. 평균만 볼 것이 아니라 실제로 지연이 길어진 요청의 기록을 읽어야 한다. 반복 조회를 묶고 불필요한 데이터를 덜 가져오는 변경은 결과가 같은지도 함께 검사한다.
사용자가 응답을 받기 전에 끝날 필요가 없는 작업은 백그라운드로 옮길 수 있다. 자주 되풀이하는 외부 조회는 캐시를 검토할 수 있지만, 오래된 정보를 보여 줘도 되는 범위와 갱신 시점을 정해야 한다. 응답이 빨라졌다는 이유로 해야 할 일을 빠뜨리거나 다른 사용자에게 보여 줄 데이터를 재사용해서는 안 된다.
이렇게 줄여도 계산 구간이 계속 시간을 차지한다면, 그 구간을 빠른 라이브러리나 다른 언어로 옮길 근거가 생긴다. 재작성 계획에는 바꿀 코드의 양보다 어느 구간을 줄일지, 같은 결과를 어떻게 확인할지가 먼저 담겨야 한다. 기존 기능과 오류 처리를 다시 검증하는 비용까지 비교해야 언어 교체의 이득을 판단할 수 있다.
계산 중심 작업에서 호출과 중간 복사를 줄이는 사례는 분석 쿼리 실행기의 배치 처리와 연산자 융합 실험에서 볼 수 있다.
출처: Sean Goedecke, Software is slow because of bad design, not slow languages · SQLite: Many Small Queries Are Efficient In SQLite · SQLite: EXPLAIN QUERY PLAN