
에이전트에게 맡기면 코드 한 편을 통째로 새로 짜는 비용이 예전보다 크게 줄었다. 그런데도 회사 안에서 여러 팀이 공유하는 플랫폼·라이브러리에 계속 투자해야 하는 이유가 있을까. 미국 소프트웨어 엔지니어 에반 미거(Evan Meagher)는 7월 31일 자신의 뉴스레터에 올린 글에서, 동료가 사내에 재사용 가능한 플랫폼을 도입하다가 던진 질문을 소개한다. "코드를 공짜로 만들 수 있다면 재사용에 무슨 의미가 남아 있나."

토큰이 공짜가 아니라는 사실이 바뀐 것
미거는 "코드를 작성하는 비용이 0에 수렴한다"는 말을 이제 그만 쓰자고 적었다. 비용이 크게 낮아진 것은 맞지만 없어진 것은 아니다. 토큰에는 실제 돈이 들고, 돈은 여전히 유한한 자원이기 때문이다. 그는 오픈소스를 둘러싼 두 개의 상반된 주장이 동시에 나온다는 점을 예로 든다. 재사용에 찬성하는 쪽은 "유명한 오픈소스 프레임워크를 쓰자, 클로드가 그 프레임워크의 베스트 프랙티스를 다 알고 있으니까"라고 말하고, 반대하는 쪽은 "그 프레임워크를 붙잡고 씨름할 필요 없이 클로드한테 맞춤 코드를 짜게 하면 된다"고 말한다. 같은 AI 도구가 정반대 결론의 근거로 동시에 쓰이는 셈이다.
미거의 결론은 에이전트가 매번 스택 전체를 처음부터 생성하는 쪽보다, 이미 잘 만들어진 하단 구성 요소 위에 상위 계층만 얹어 짜게 하는 쪽이 언제나 더 싸다는 것이다. 이 레버리지는 소프트웨어 엔지니어링이라는 직업이 60년 동안 딛고 서 온 토대이며, 프로그래밍이 한 단계 높은 추상화로 올라갔다고 해서 사라질 이유가 없다고 그는 쓴다.
숫자로 확인된 재사용의 효과
같은 시기 마틴 파울러(Martin Fowler) 사이트에는 이 주장을 뒷받침하는 실측 데이터가 올라왔다. 소트웍스(Thoughtworks) 유럽·중동·인도 CTO 자일스 에드워즈-알렉산더(Giles Edwards-Alexander)는 7월 30일 공개한 글에서, 클로드 코드로 전부 생성한 약 15만 줄 규모 애플리케이션의 데이터 접근 계층 파일 하나가 17,155줄까지 불어난 사례를 분석했다. 중복 제거나 함수 추출이 거의 없는 상태였다. 그는 이 파일을 15단계에 걸쳐 리팩터링하면서, 매 단계마다 똑같은 대표 작업 하나를 새 에이전트에게 시키고 그때마다 소비된 입력 토큰 수를 기록했다.
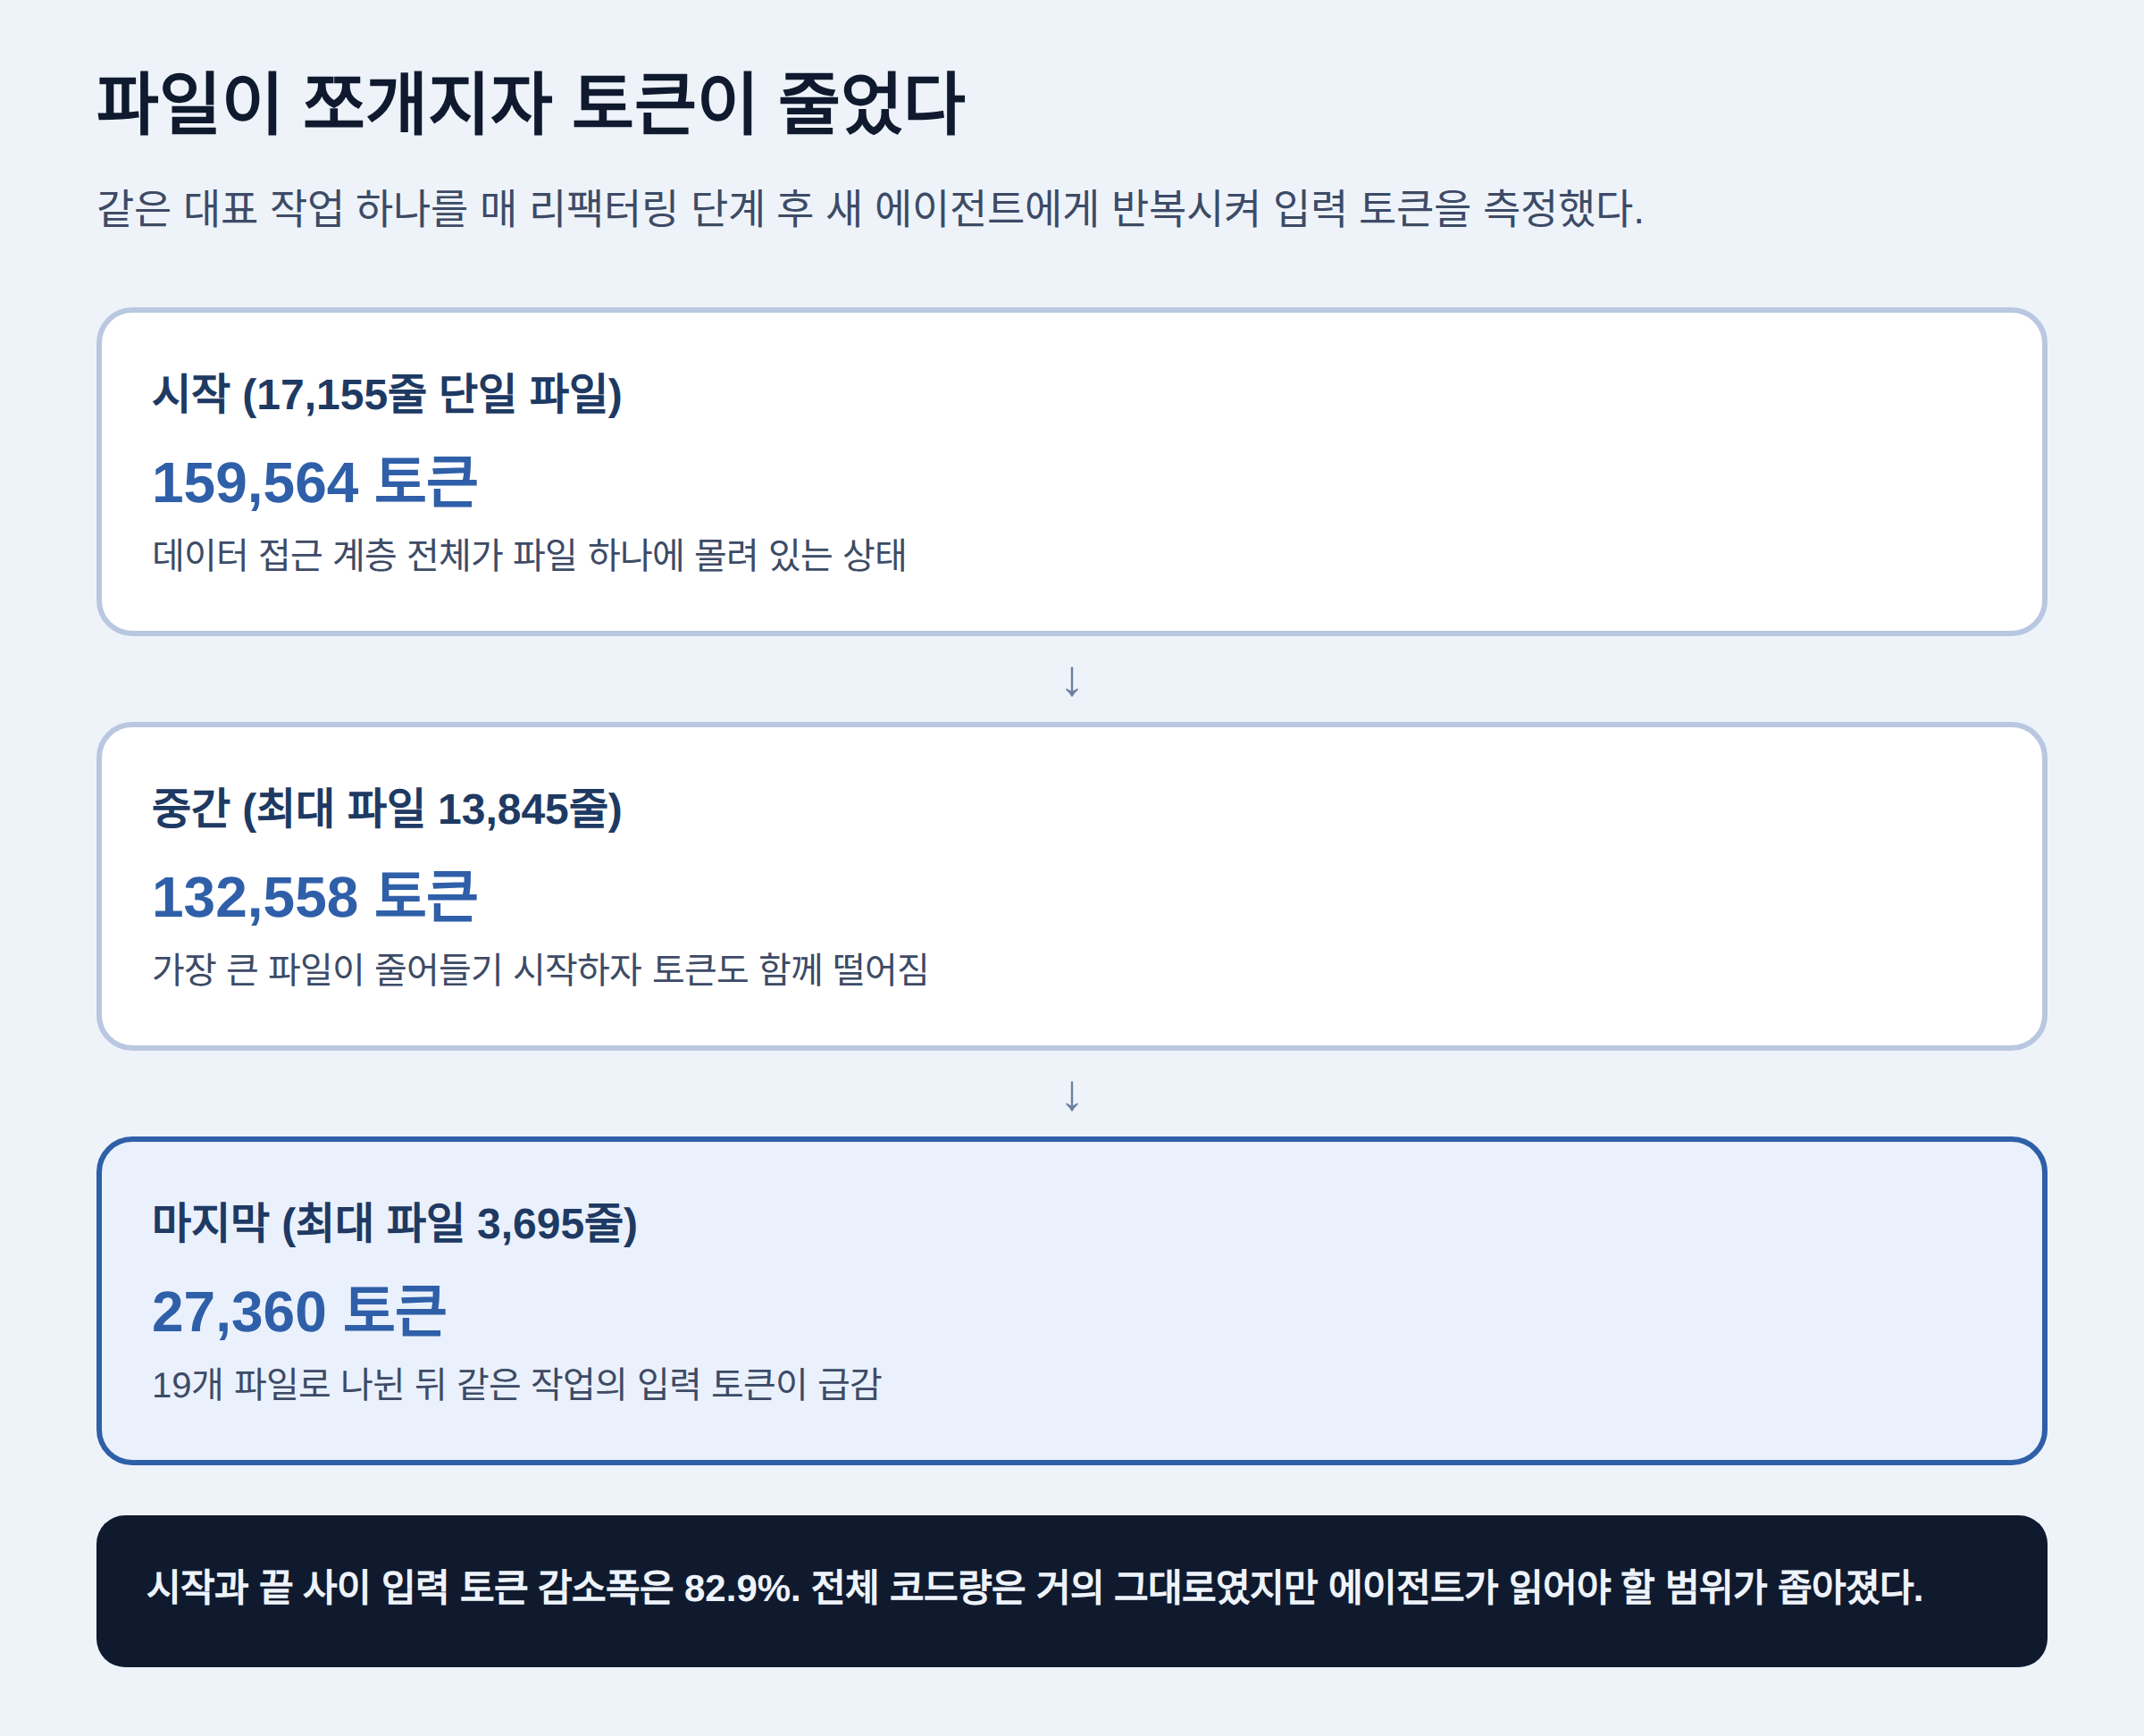
결과는 뚜렷했다. 리팩터링 전에는 같은 작업에 입력 토큰 159,564개가 들었는데, 마지막 15단계를 마친 뒤에는 27,360개로 줄었다. 82.9% 감소다. 흥미로운 지점은 이 감소가 파일을 잘게 쪼갠다고 곧바로 생기지 않았다는 것이다. 초반 몇 단계는 토큰 소비가 오히려 늘거나 제자리걸음이었고, 데이터 접근 계층에서 가장 큰 파일의 줄 수가 13,845줄 아래로 떨어지기 시작한 8단계 무렵부터 토큰이 눈에 띄게 줄기 시작했다. 전체 코드량 자체는 거의 그대로였다는 점도 중요하다. 에드워즈-알렉산더는 이 절감이 "읽을 코드가 줄어서가 아니라, 에이전트가 읽어야 할 최소한의 파일 범위를 실제로 더 잘 찾아낼 수 있게 됐기 때문"이라고 설명한다. 무작위로 파일을 쪼개는 것만으로는 이런 효과가 나지 않는다는 뜻이다.
파일 하나가 열아홉 개로 쪼개지기까지
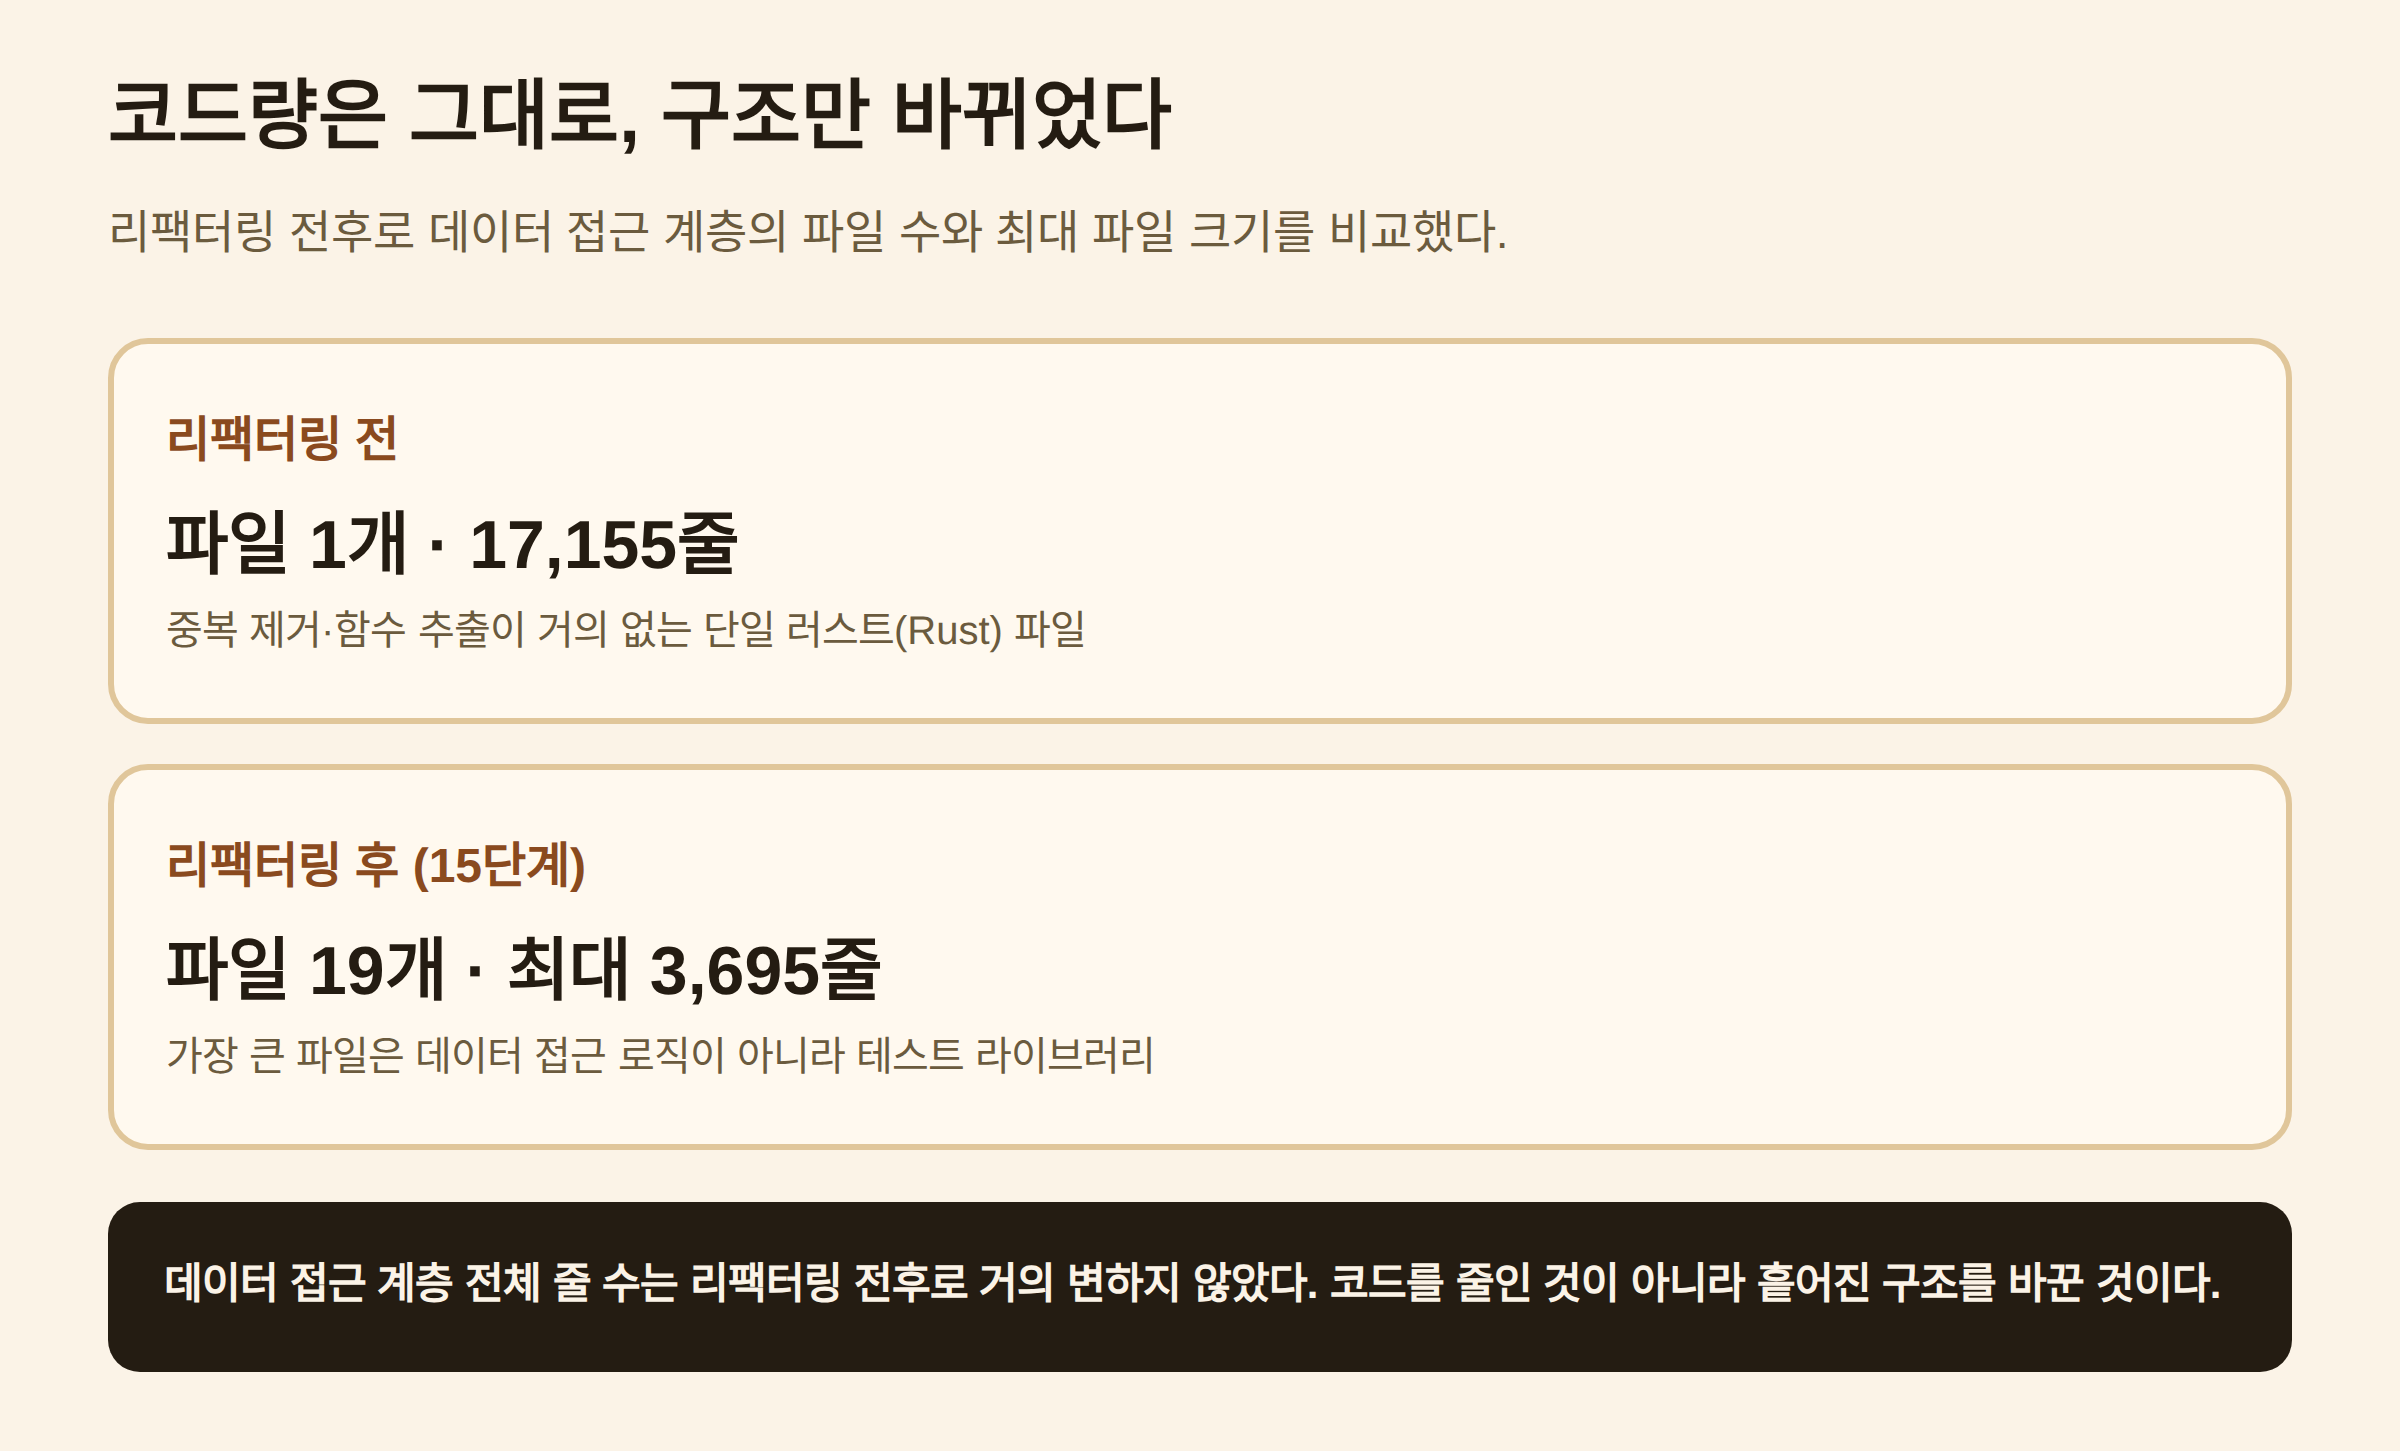
17,155줄이던 단일 파일은 리팩터링을 거치며 19개의 러스트(Rust) 파일로 나뉘었다. 마지막 단계에서 남은 가장 큰 파일은 데이터 접근 로직이 아니라 테스트 라이브러리였고 줄 수는 3,695줄이었다. 반면 데이터 접근 계층 전체의 총 줄 수는 리팩터링 전후로 크게 변하지 않았다. 코드를 줄인 것이 아니라 코드가 흩어진 구조를 바꾼 것이다.
이 절감액을 실제 돈으로 환산하면 크지 않다. 소넷(Sonnet) 5 가격을 입력 토큰 100만 개당 3달러로 잡으면, 이번 실험 한 건의 절감액은 39.7센트에 그친다. 에드워즈-알렉산더 본인도 "많은 금액은 아니다"라고 인정하면서, 이 절감이 디버깅이나 더 복잡한 기능 구현에서도 반복되고 누적되는지가 다음 질문이라고 남겼다.
리팩터링도 여전히 사람의 판단이 필요하다
이 실험은 클로드가 알아서 리팩터링 대상을 골라내지는 못한다는 점도 함께 드러냈다. 에드워즈-알렉산더는 클로드가 코드를 보고 스스로 어떤 리팩터링이 적합한지 판단하지 못하며, 사람이 적극적으로 방향을 짚어 줘야 한다고 적었다. 실제로 그가 만든 개발 하네스에는 리팩터링 단계가 명시적으로 들어 있었는데도, 그 단계만으로는 이 파일이 개선되지 않았다.
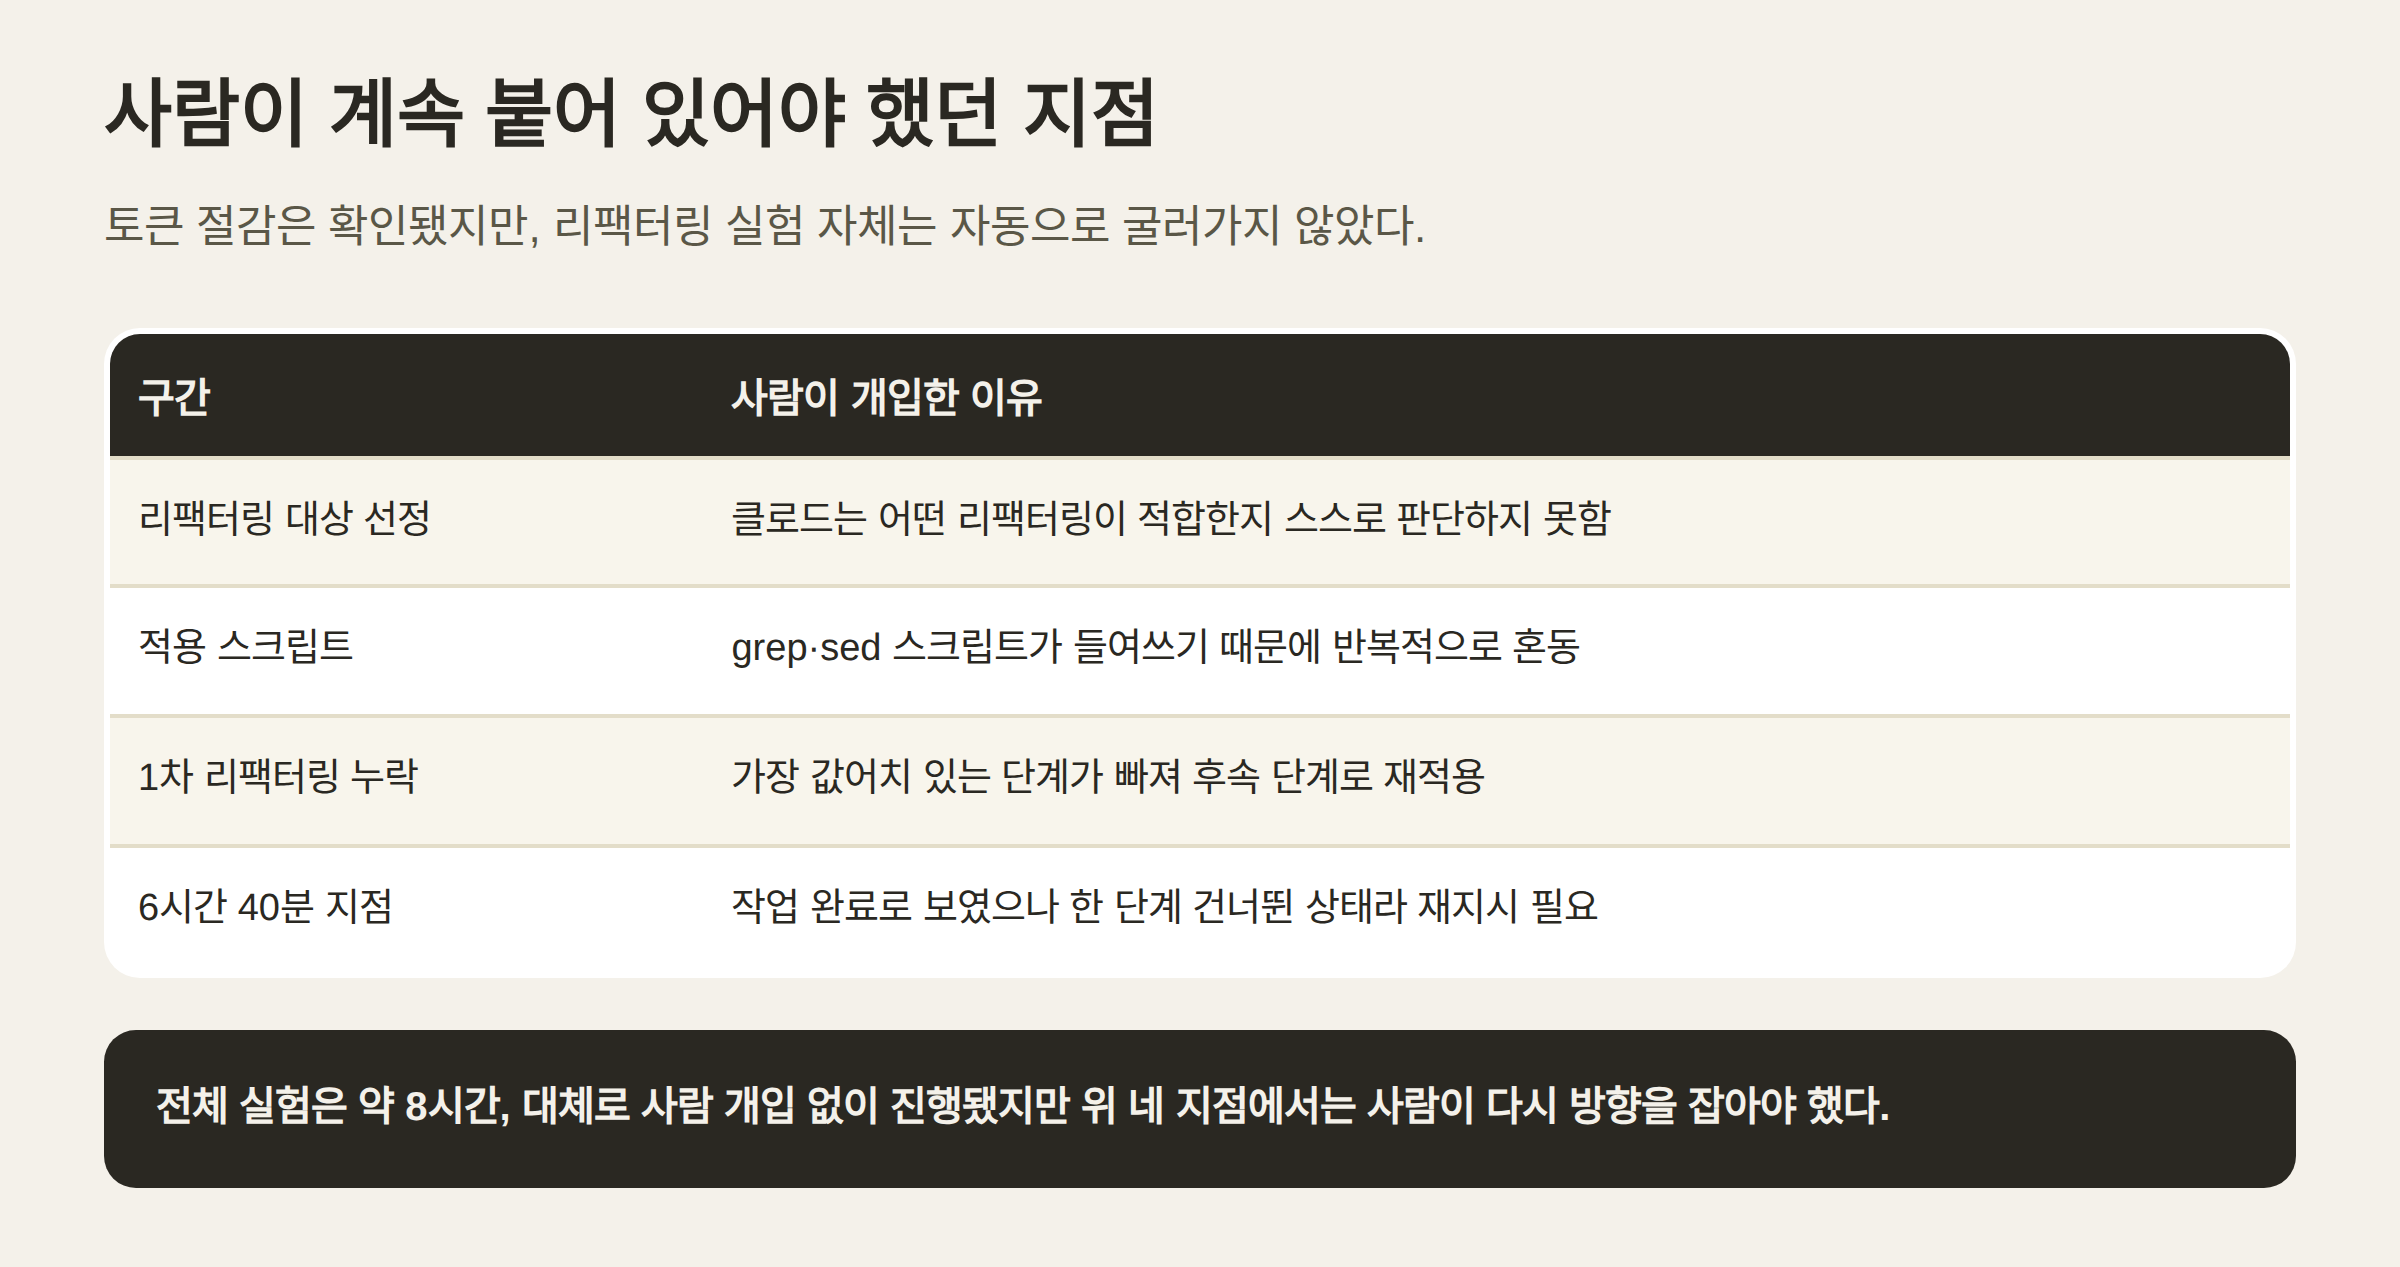
기계적으로 코드를 고치는 과정도 매끄럽지 않았다. 실제 리팩터링 적용은 grep과 sed를 쓰는 파이썬 스크립트로 수행했는데, 이 스크립트들이 들여쓰기 때문에 자주 혼동을 일으켰다. 가장 값어치 있는 리팩터링 하나는 첫 시도에서 아예 빠져 별도 후속 단계로 다시 적용해야 했다. 전체 실험은 약 8시간 걸렸고 대체로 사람 개입 없이 진행됐지만, 6시간 40분 지점에서는 작업이 끝난 것처럼 보였는데 실제로는 한 단계를 건너뛴 상태였고 사람이 다시 방향을 지시해야 했다. 토큰 소비량 계측도 완벽하지 않았다. 클로드는 세션당 소비 토큰이나 과금 내역은 보여주지만 실시간으로 신뢰할 만한 토큰 계수 방법을 제공하지 않아, 문자 수를 4로 나누는 tiktoken 근사치를 대신 썼다.
두 글이 가리키는 같은 지점
미거는 자신이 플랫폼 팀에서 오래 일해 온 만큼 재사용 쪽으로 기울어 있다는 점을 스스로 인정하면서도, 이 논리를 뒷받침하는 근거로 에드워즈-알렉산더의 글을 직접 언급한다. 두 글을 나란히 놓고 보면 겹치는 지점이 하나 있다. 에이전트가 코드를 짜는 비용은 낮아졌지만, 그 에이전트가 매번 무엇을 처음부터 다시 읽고 다시 짜야 하는지는 여전히 조직이 손볼 수 있는 부분이라는 것이다. 잘 정리된 사내 플랫폼과 재사용 가능한 컴포넌트는 에이전트가 뒤질 코드 범위를 줄여 주고, 에드워즈-알렉산더의 실험이 보여주듯 그 범위가 좁아질수록 같은 기능을 구현하는 데 드는 토큰도 함께 줄어든다.
출처: Evan Meagher, "Platform engineering still matters", Giles Edwards-Alexander, "The Economic Benefit of Refactoring", martinfowler.com (2026-08-17 확인)