
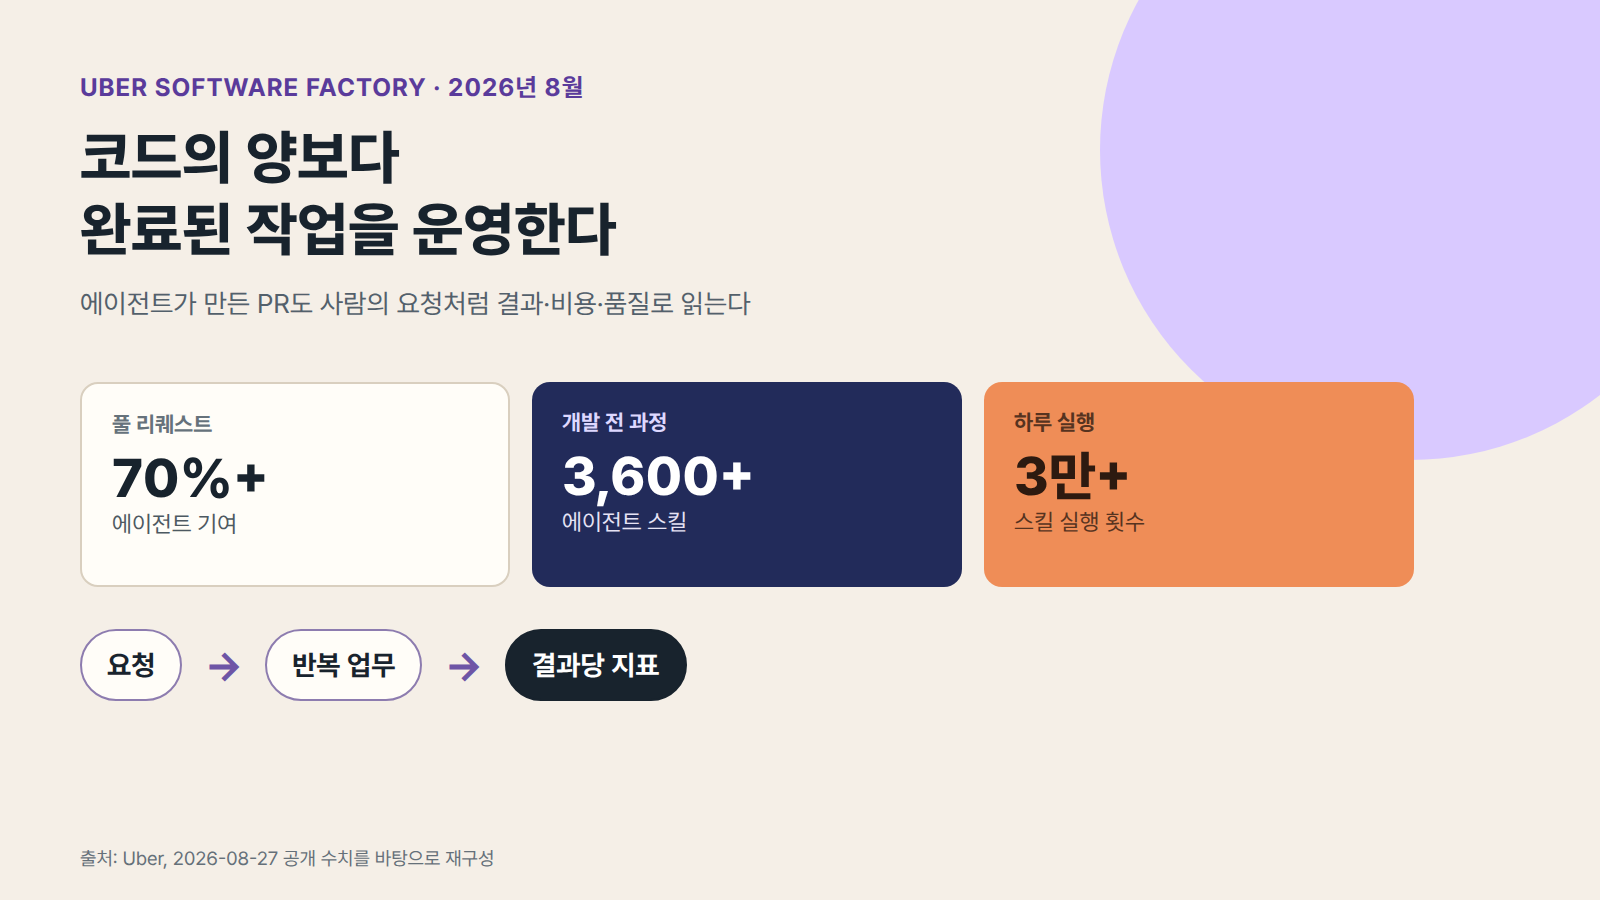
AI가 작성한 코드 비중이 커지면 개발 조직은 누가 어떤 작업을 맡고, 어떤 결과를 내며, 그 과정에 얼마가 드는지를 작업 단위로 운영해야 한다. Uber는 2026년 8월 27일 공개한 글에서 자사 풀 리퀘스트의 70% 이상이 로컬 또는 클라우드 에이전트에 귀속된다고 밝혔다. 개발 전 과정에서 만든 에이전트 스킬은 3,600개 이상이고, 하루 실행은 3만 회를 넘는다.
이 수치는 코딩 보조 도구의 보급률보다 운영 경계의 변화를 보여 준다. Uber에서 자동 관리 에이전트는 코드 리뷰, CI 실패 복구, 화면 검증을 포함한 E2E 풀 리퀘스트 처리, 온콜 경고 분류, 버그 분석, 유지보전 업무를 맡고 사람의 검토나 에스컬레이션으로 이어진다. 팀이 관리할 대상은 개발자 한 명의 프롬프트가 아니라, 반복 업무 하나를 끝내는 실행 경로가 된다.

개발자는 네 가지 실행 환경 중 어디에 에이전트를 둘까
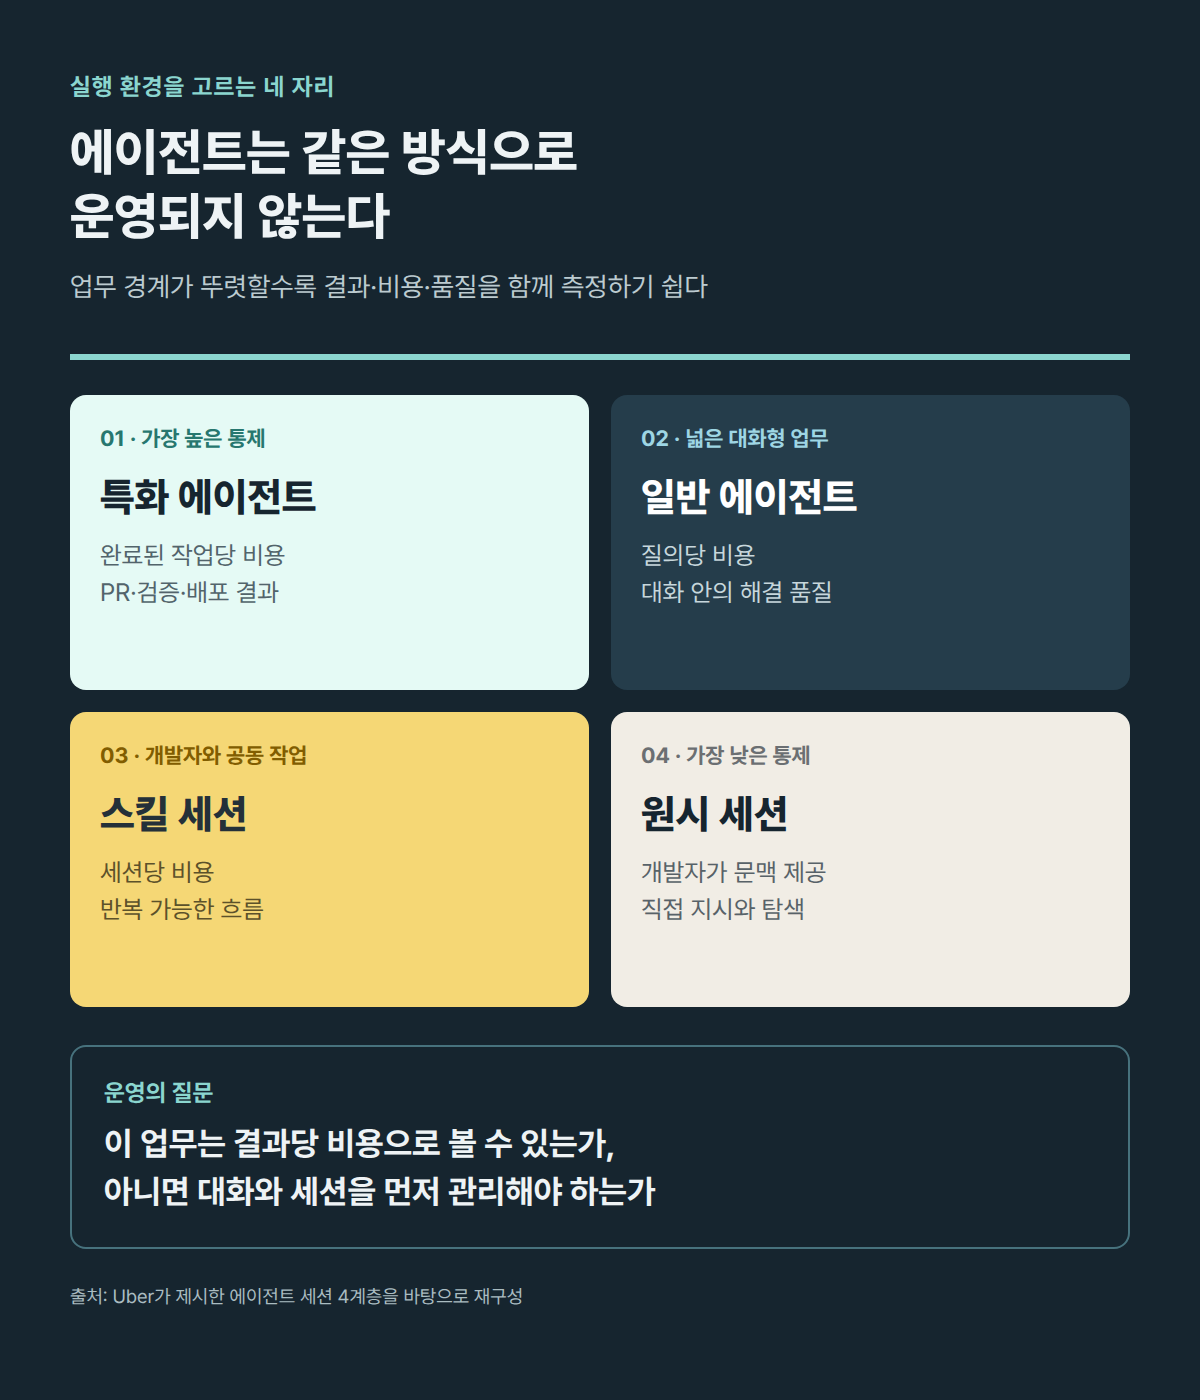
Uber는 에이전트 세션을 특화 에이전트, 일반 에이전트, 스킬을 쓰는 세션, 원시 세션의 네 층으로 나눈다. 특화 에이전트는 코드 생성, 검증, 배포, 관찰, 유지보전처럼 경계가 좁은 일을 맡는다. 이 층에서는 병합된 PR, 리뷰, 경고 처리처럼 완료된 결과를 기준으로 비용을 연결할 수 있다. 일반 에이전트와 개발자 노트북의 스킬 세션은 더 넓은 대화형 작업을 다루고, 원시 세션에서는 개발자가 문맥과 지시를 직접 제공한다.
위로 올라갈수록 비용, 품질, 모델 선택을 운영 측에서 더 많이 통제할 수 있다는 것이 Uber의 구분이다. 조직 설계에서는 반복 빈도가 높고 완료 기준을 정할 수 있는 작업부터 경계를 만들고, 사람에게 남길 승인과 예외 처리를 함께 정해야 한다.
AI 비용을 왜 여섯 항으로 쪼개야 하나
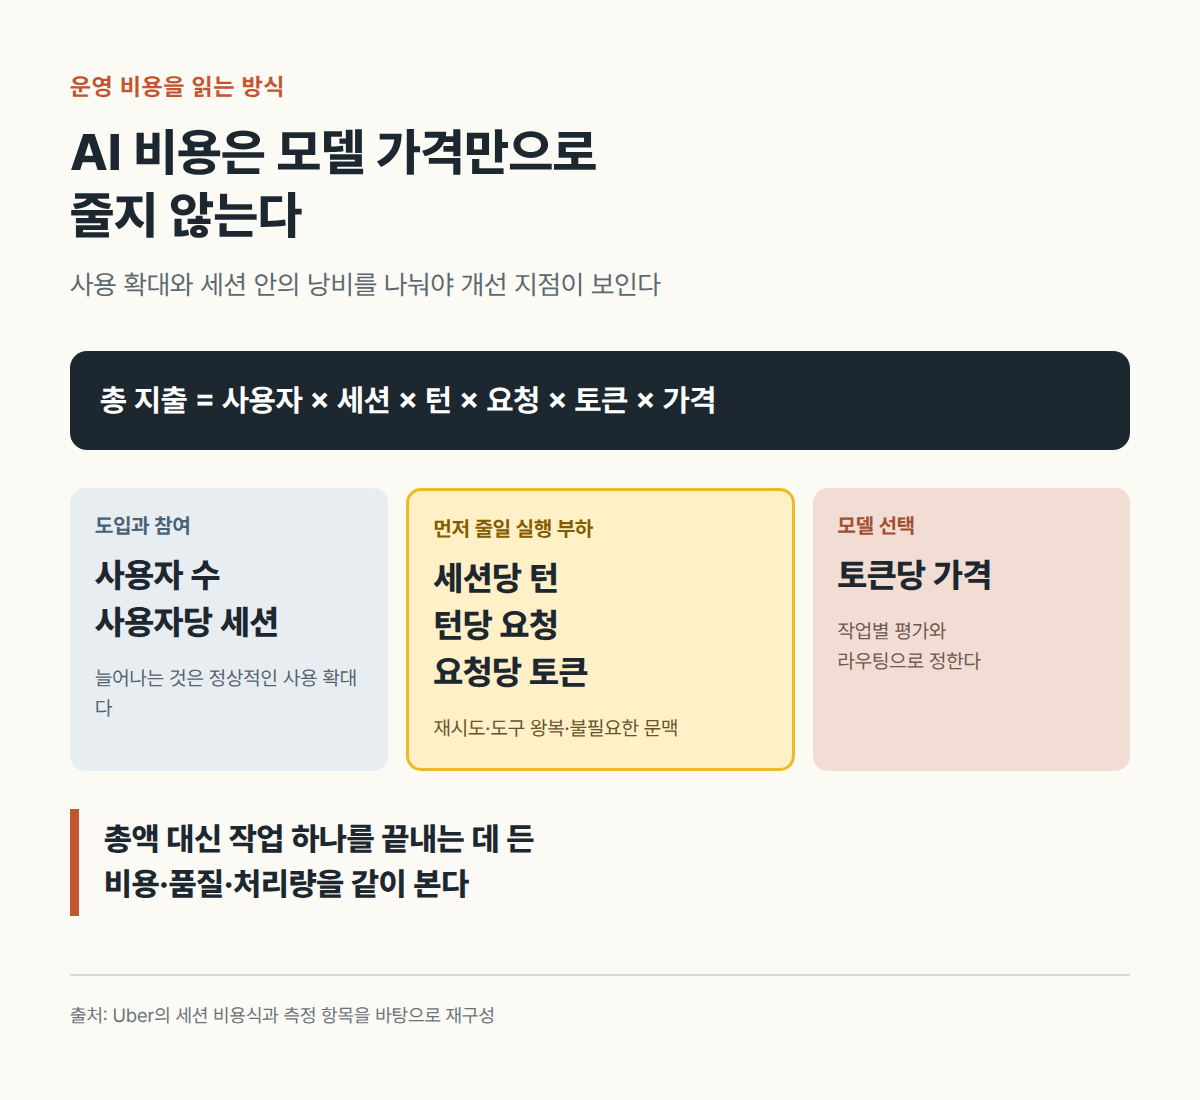
Uber는 총 지출을 사용자 수, 사용자당 세션 수, 세션당 턴 수, 턴당 요청 수, 요청당 토큰 수, 토큰당 가격의 곱으로 분해한다. 앞의 두 항은 사용 확대와 참여를 나타낸다. 운영팀이 먼저 줄일 곳은 대개 그 다음 세 항이다. 에이전트가 계획을 다시 세우거나 오류를 반복해 턴이 늘고, 도구 왕복이나 불필요한 문맥·도구 정의 재전송으로 요청당 토큰 수가 커지는 비용이다.
이 식은 비용 절감 논의를 모델 단가 협상에서 실행 설계로 옮긴다. Uber는 2026년 2월부터 7월까지 같은 모델을 고정해 비교했을 때 1,000회 모델 요청당 비용이 정점 대비 약 34% 낮아졌고, 세션당 비용은 6월 정점 대비 52% 낮아졌다고 썼다. 사용량과 모델 구성이 계속 바뀌는 환경에서는 총액만 보고 개선 여부를 판단하기 어렵기 때문이다.
모델 선택은 구매가 아니라 작업별 평가가 된다
특화 에이전트를 운영하려면 모델을 전사 기본값으로 한 번 정하고 끝낼 수 없다. Uber의 uReview 사례는 실제 풀 리퀘스트에서 발견된 버그를 쉬움, 보통, 어려움으로 나눈 벤치마크를 만들고, 정밀도·재현율·F1과 리뷰당 비용, 지연 시간, 타임아웃, 잡음을 함께 점수화한다. 목표는 완료된 작업당 비용, 결과 품질, 신뢰성을 함께 만족하는 모델을 계속 고르는 것이다.
플랫폼 쪽의 할 일도 구체적이다. Uber는 1,000개가 넘는 MCP 서버를 단일 게이트웨이로 통과시키고, 처음부터 도구 정의를 전부 싣는 대신 필요한 도구를 검색하거나 CLI로 실행하게 했다. 100개가 넘는 도구 정의를 미리 불러오면 최초 프롬프트에 약 5만~7만 토큰이 더해지고 이후 턴마다 다시 전송된다는 계산에서 나온 선택이다. 코딩 모드에서는 여러 도구 호출과 상태 확인을 스크립트 안에 묶고, 모델에는 중간 과정 대신 요약만 돌려준다.
개발 조직은 업무 경계를 작게 정한 뒤 실제 업무로 평가하고, 실행 환경에 맞춰 결과당 비용과 품질을 봐야 한다. 그 루프가 있어야 AI가 만든 코드의 양이 늘어도 리뷰, 배포, 장애 대응의 기준이 흐려지지 않는다.
출처: Uber, Running a Software Factory Efficiently at Uber Scale, 2026-08-27