
파손 신고에 사진이 붙어 왔을 때, 운영 시스템이 필요한 답은 긴 설명보다 "손상 여부"와 "어느 팀이 처리할지"인 경우가 많다. Cloudflare가 10월 1일 공개한 Clef와 Clef-flash는 이런 질문에 미리 정한 선택지와 확률을 반환하는 의사결정 모델이다. 문장을 생성한 뒤 분류값을 추출하는 단계를 줄이고, 사진까지 판단 입력으로 받는다.
기존 텍스트 분류 도구와 비교할 지점은 이미지 입력과 공개 가중치다. 텍스트를 분류하는 Jev와 달리 두 모델은 시각 인코더를 갖췄다. Hugging Face에 Apache 2.0 라이선스로 가중치와 실행 코드를 공개했으며, Cloudflare의 Workers AI에서 호출하거나 자체 환경에 내려받아 실행할 수 있다. 빠른 모델을 고르는 문제와 내 데이터가 어디에서 처리되는지를 함께 비교할 수 있게 됐다.
사진을 넣으면 어떤 답을 받을 수 있나
공개 모델 카드의 예시는 영수증 사진을 입력하고 "합계 금액을 읽을 수 있는가"를 예·아니오 질문으로 묻는다. 결과는 영수증에 대한 감상이나 설명문이 아니라 허용된 답의 확률이다. 텍스트·JSON으로 상황을 전달하는 state, 사진 목록인 images, 판단할 항목을 담는 questions를 함께 넣는다. 공개 코드에서는 PIL 이미지 객체를 전달하고 이미지 처리기를 인코딩 단계에 넘긴다.
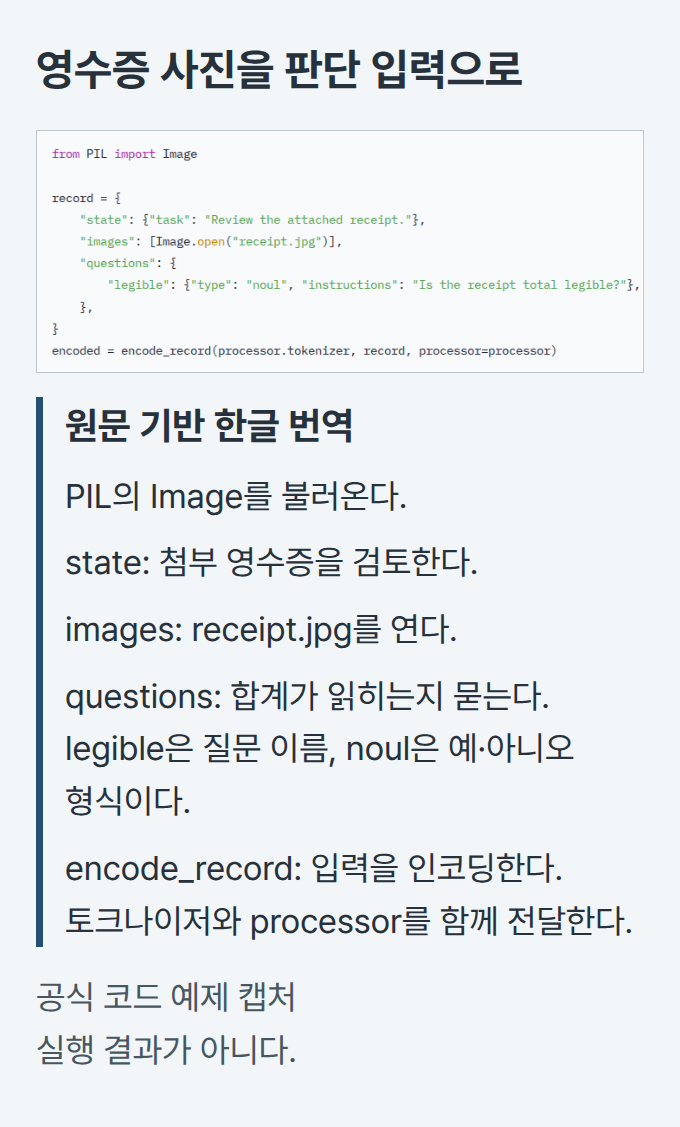
이 구조를 파손 접수에 적용한다면 사진과 고객 설명을 함께 보내고, 손상 여부와 담당 부서를 각각 묻는 방식으로 설계할 수 있다. 이는 운영 적용 예시이지 공개된 파손 판정 성능 시험은 아니다. 발표의 텍스트 분류 점수가 높다는 이유로 흐릿한 사진이나 여러 물건이 섞인 사진도 잘 판단한다고 간주해서는 안 된다. 실제 접수 사진으로 오판과 사람 검토 비율을 별도로 측정해야 한다.
질문 형식은 예·아니오인 noul, 이름 붙인 선택지에서 고르는 choice, 순서가 있는 등급을 평가하는 score다. 선택형 응답에는 선택값, 신뢰도, 선택지별 확률이 들어간다. 이 값을 받아 담당 부서에 보내거나 검토 대기열에 넣는 일은 운영 코드가 맡는다. 모델이 답을 골랐다는 사실과 실제 환불·차단을 실행할 권한은 분리해야 한다.
Clef-flash가 빠르면 큰 Clef는 왜 필요한가
Clef는 Qwen3.8-27B, Clef-flash는 Qwen3.5-9B를 바탕으로 학습했다. Cloudflare는 Clef의 문맥 길이를 64k로 소개하며 Jev의 32k와 비교한다. 공개 실행 코드의 인코딩 함수는 기본 최대 길이가 16,384토큰이므로, 모델의 문맥 용량과 실제 실행 설정을 같은 숫자로 취급하면 안 된다. 긴 상담 이력을 넣는다면 입력 제한과 잘리는 구간부터 확인해야 한다.
Cloudflare가 발표에 실은 평가에서 BANKING77의 macro-F1은 Clef 94.20, Clef-flash 90.93, Jev 79.74였다. 은행 문의 의도를 분류하는 과제에서는 두 Clef가 앞섰다. 범위 밖 문의도 포함하는 CLINC150+OOS에서는 Clef 97.43에 비해 Clef-flash가 66.77, Jev가 89.27이었다. 빠른 변형의 손실이 모든 과제에서 작지는 않다.
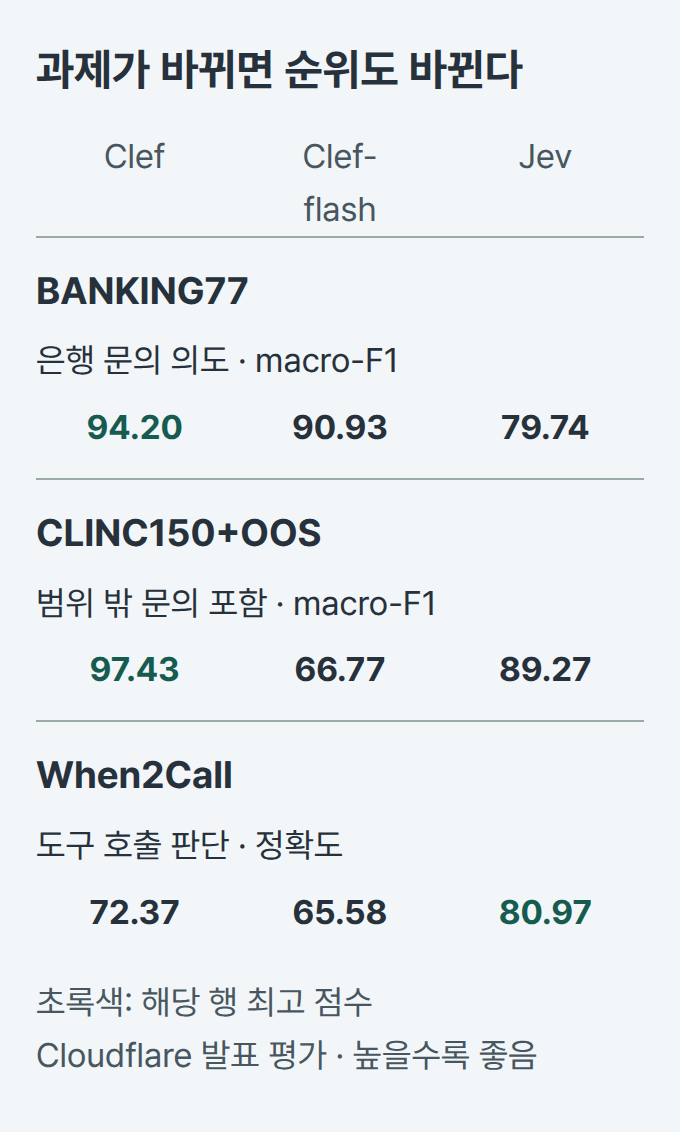
도구를 호출할지 판단하는 When2Call 정확도는 Jev 80.97, Clef 72.37, Clef-flash 65.58로 순서가 바뀐다. 따라서 "Clef가 Jev보다 똑똑하다"는 한 문장으로 모델을 교체하기는 어렵다. 기존 글에서 살펴본 추론을 거쳐 답을 고르는 Jeeves의 품질·대기시간 비교와도 구분할 필요가 있다. 이번 Clef 비교표의 상대는 Jev이며, Jeeves의 점수를 가져와 같은 시험인 것처럼 나란히 놓을 수는 없다.
여러 판단을 묶은 업무 평가에서는 차이가 더 작기도 하다. 고객 서비스의 정확한 행동 조합 점수는 Clef 76.3, Clef-flash 77.0, Jev 76.0이다. 송장 처리의 같은 지표는 각각 64.7, 57.1, 61.8로 큰 Clef가 앞선다. 문의 문장 하나의 분류와 후속 행동 전체가 맞는지는 다른 평가다. 공개 모델 카드는 동일 데이터셋 리비전과 사례 집합에서 비교했다고 명시한다.
38.8ms와 실제 문의 처리 시간은 어떻게 다른가
Cloudflare의 평가 지연시간 중앙값은 Clef 209.3ms, Clef-flash 38.8ms, Jev 524.1ms다. 느린 쪽 응답을 보는 p95는 각각 238.6ms, 122.4ms, 536.0ms였다. 중앙값만 보면 Clef-flash가 매우 빠르지만, 지연 한도를 정할 때는 p95도 같이 봐야 한다. 이 수치는 발표 평가의 요청 지연시간이며 사진 업로드부터 상담 시스템 반영까지 걸리는 시간은 아니다.
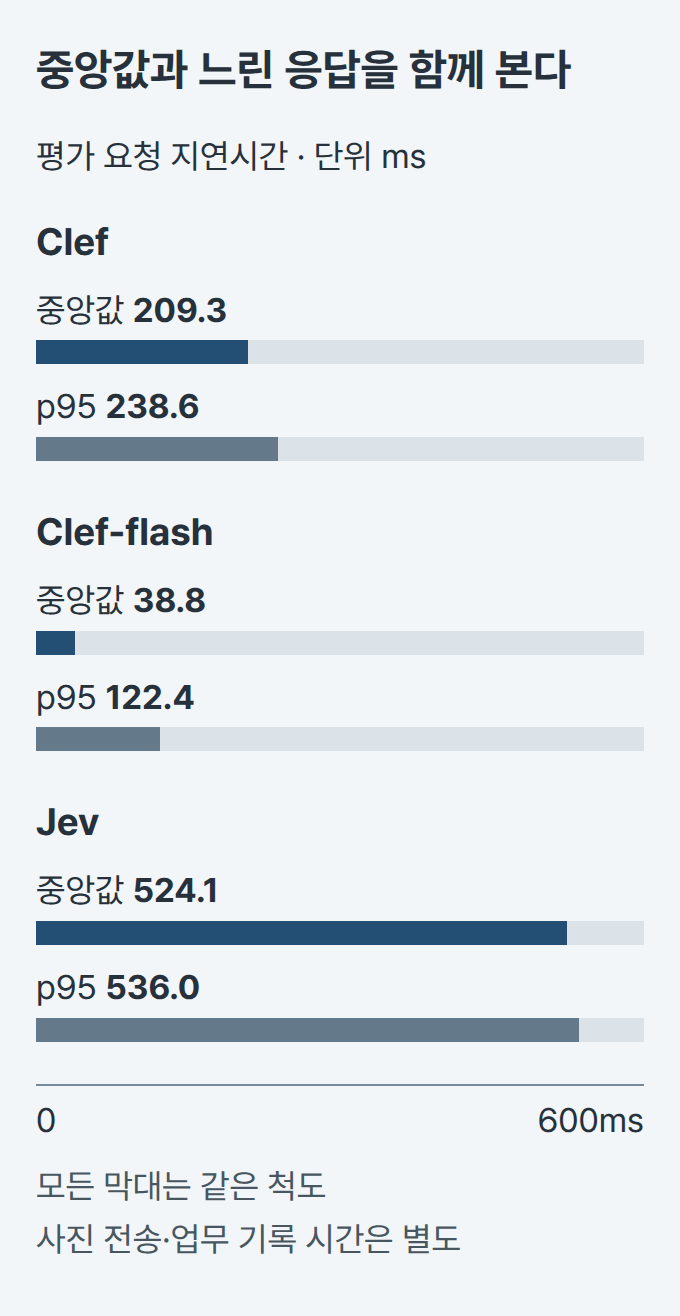
Cloudflare의 도메인 분류 사례는 이 구분을 보여준다. Browser Run으로 웹사이트를 가져오고 렌더링한 뒤 분류하는 전체 흐름은 Clef 2.2초, gpt-oss-120b 4.7초였다. 이 사례의 초 단위 시간과 평가표의 밀리초 단위 시간을 섞어 읽으면 서비스의 응답 속도를 과대평가하게 된다. 사진 접수 서비스도 파일 전송, 전처리, 모델 호출, 업무 시스템 기록까지 재야 한다.
빠른 이유는 설명문을 토큰마다 이어 쓰지 않는 구조에 있다. Clef는 입력을 한 번 처리한 뒤, 허용된 선택지들을 병렬로 점수화한다. 학습에서는 확률 보정을 위한 Brier 손실도 사용했다. 확률이 나온다는 것만으로 "0.9면 언제나 90%가 맞는다"고 볼 수는 없다. 운영자는 실제 문의에서 그 확률 구간의 정답률을 확인한 뒤 자동 처리 경계를 정해야 한다.
공개 가중치를 받은 뒤에도 운영자가 정해야 하는 것
공개 가중치는 자체 배포와 업무별 튜닝을 비교할 수 있게 한다. 작은 쪽도 9B 모델이며, 공식 실행 예시는 단일 H200에서 시험한 환경을 제시한다. 내려받을 수 있다는 말이 일반 노트북에서 같은 지연시간을 낸다는 뜻은 아니다. API를 쓸 때와 자체 GPU로 돌릴 때의 비용, 데이터 보관 정책, 지연시간을 따로 비교해야 한다.
먼저 담당 부서와 예외 선택지를 명확히 정하는 편이 좋다. 가장 높은 확률이 나왔어도 선택지 사이의 차이가 작거나 사진이 판독 불가이면 사람에게 넘기는 흐름을 둘 수 있다. 환불 승인처럼 오판 비용이 큰 판단은 단순 부서 분류보다 엄격하게 검토한다. 특정 확률을 모든 업무의 공통 임계값으로 쓰기보다, 보류한 문의까지 포함한 운영 결과를 보고 경계를 조정해야 한다.
Cloudflare의 업무별 미세조정 서비스는 우선 엔지니어 팀이 함께 작업하는 형태로 제공된다. 요청 데이터 수집, 학습, 재배포를 직접 하는 셀프서비스 플랫폼은 이후 계획이다. 지금 비교할 대상은 공개 모델과 호스팅 호출, 그리고 협업형 튜닝이다. 이미 완성된 셀프서비스 기능을 전제로 자동화 일정을 잡을 단계는 아니다.