
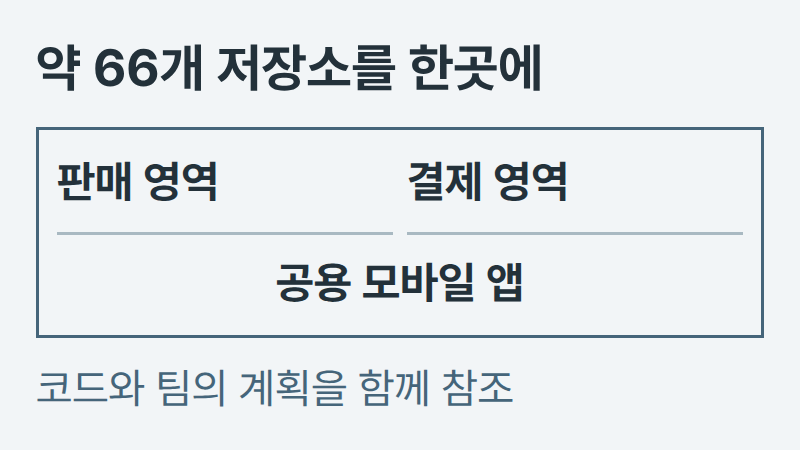
여러 부서의 시스템이 어떻게 연결되는지 물을 때마다 엔지니어 서너 명을 한 방에 모아야 했다. 결제 기업 SumUp에서 일하는 엔지니어링 매니저 Candost가 겪던 문제다. 각 팀은 자기 서비스를 알았지만, 전체 흐름을 혼자 설명할 사람은 없었다. 그는 관련 코드 저장소 약 66개를 하나의 조사 공간에 연결하고, 팀의 계획과 운영 원칙도 함께 읽게 하는 시스템을 만들었다.
그는 시스템의 작동 방식을 묻기 전에 사람부터 모으던 흐름을 바꾸려 했다. 코드만 검색해서는 서비스 사이의 관계나 팀이 앞으로 없애려는 흐름까지 알기 어렵다. 이 사례에서는 저장소별 조사 결과를 정해진 형식으로 모으고, 상위 에이전트가 부서 간 연결을 설명한다. 조직 정보는 매주 갱신하되 사람이 보고서와 수정안을 읽은 뒤 반영한다.
자료를 더 연결했는데 왜 답이 나빠졌을까
첫 시도는 Notion의 맞춤형 에이전트였다. GitHub와 다른 도구를 연결하고, 큰 문서 공간과 저장소를 찾아다니는 방법을 지시했다. 한 팀의 업무 범위에서는 쓸 만했다. 그러나 여러 부서로 넓히자 필요한 정보를 놓치기 시작했다. 읽으라고 지정한 문서를 건너뛰고, 도구 호출이 시간 초과로 끝나거나 이유를 알기 어려운 실패가 생겼다.
두 번째 시도에서는 범위부터 줄였다. 회사 전체의 수천 개 저장소를 담으려 하지 않고, 두 업무 영역과 하나의 공용 모바일 앱을 중심으로 구성했다. OpenCode라는 오픈소스 코딩 에이전트 도구를 조사 실행의 중심에 두고, 관련 저장소를 Git 서브모듈로 연결했다. 서브모듈은 각각의 독립 저장소를 유지하면서 상위 저장소에서 함께 참조하는 방식이다. 원문 작성 시 연결된 저장소는 약 66개였다.
코드 옆에는 팀이 아는 사정도 놓았다
폴더는 Go나 Kotlin 같은 개발 언어가 아니라 제품과 팀의 구조를 따라 나눴다. 판매와 결제를 각각 domains/sales, domains/payments 아래에 두고, 큰 영역은 하위 업무로 다시 나눴다. 판매 API를 호출하는 클라이언트와 플랫폼 인프라도 따로 묶었다.
각 영역의 AGENTS.md에는 그 영역의 정의, 원칙과 구조, 진행 중인 큰 프로젝트를 적었다. 아직 실제 폐기 작업을 시작하지 않았더라도 없앨 계획이 있는 서비스라면 그 사정도 넣었다. 개별 저장소에도 맥락을 설명하는 파일을 뒀다. 같은 코드라도 앞으로 유지할 서비스인지, 다른 흐름으로 옮길 예정인지에 따라 제안할 해법이 달라지기 때문이다.
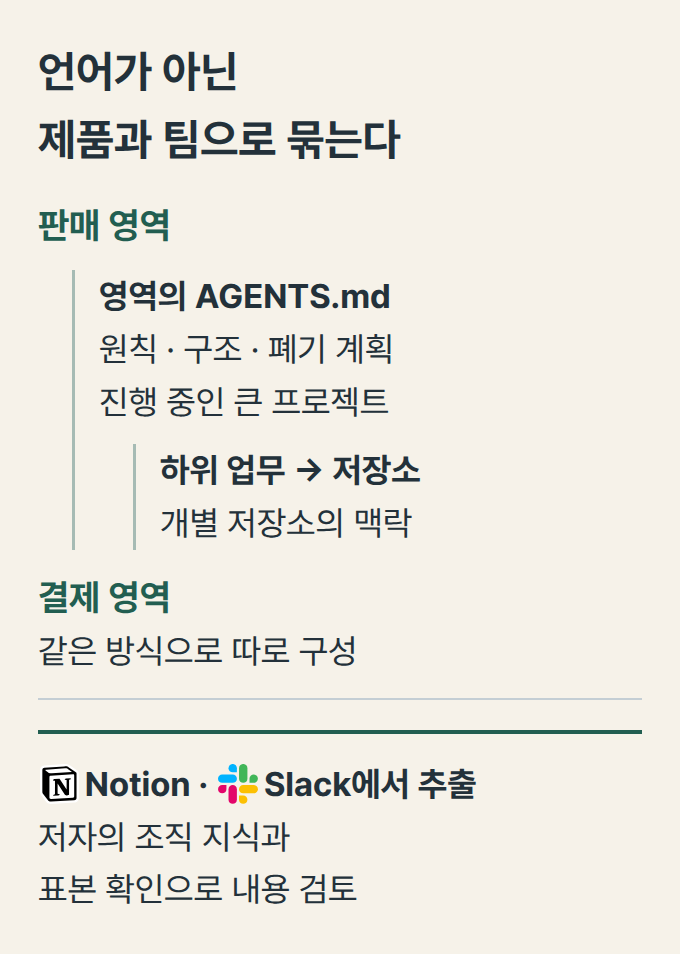
이 파일들은 문서를 자동 요약한 채로 끝내지 않았다. Candost는 Notion과 Slack에서 정보를 추출한 뒤 자신의 조직 지식과 표본 확인으로 내용을 검토했다. 여러 부서에 걸친 질문에 좋은 답을 얻을 때까지 파일을 반복해서 고쳤고, 이 작업에 가장 많은 시간을 썼다고 설명한다. 처음부터 모든 저장소를 붙이지 않고 몇 개로 시작해 질문을 던져 본 것도 이 과정에 포함된다.
조사는 나누고, 시스템의 연결은 따로 설명한다
저장소가 약 열 개에 이르자 그의 설정에서 모델은 일을 직접 조사하기도 하고 하위 에이전트에 넘기기도 했다. 서로 다른 업무 영역의 저장소를 같은 범위로 취급하는 혼선도 생겼다. 그는 조사 범위를 명시한 맞춤형 에이전트와 구조화된 전달 지시로 이를 다뤘다.
원문 구조도는 사용자가 상대하는 에이전트와 뒤에서 조사하는 에이전트를 구분한다. 일반 동반자 역할은 상위 조사·브레인스토밍 에이전트를 호출하고, 두 상위 에이전트는 저장소 검사와 업무 영역 조사 역할에 일을 넘긴다. 아래 도식은 원문의 다섯 역할과 호출 관계를 한글로 옮겼다.
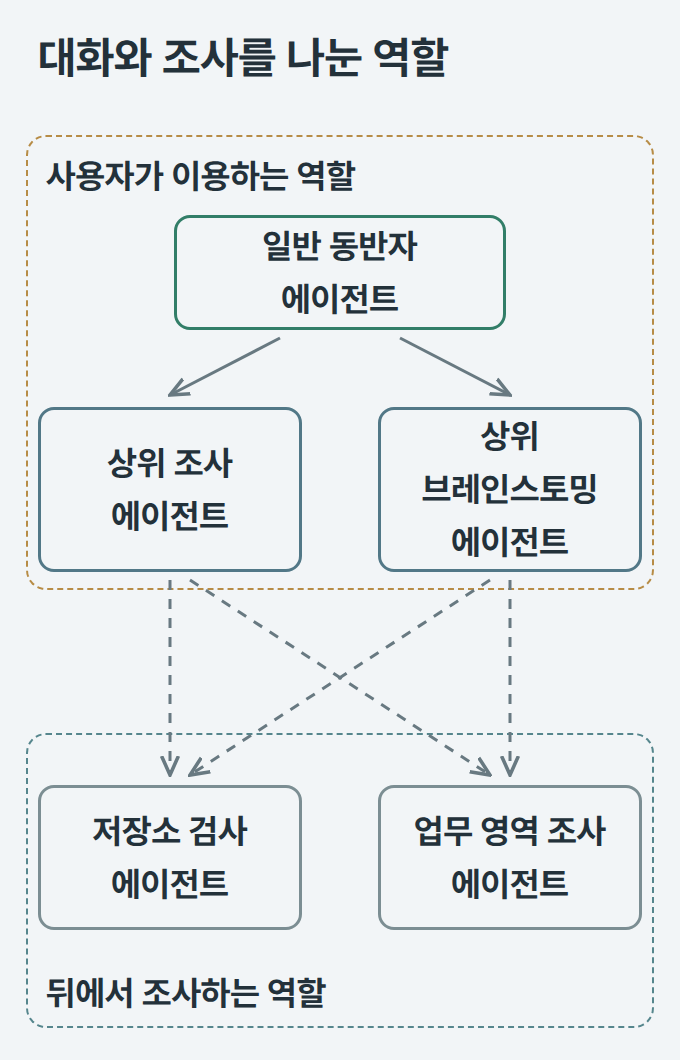
상위 조사 에이전트는 먼저 질문과 관련 있을 법한 영역과 저장소를 찾는다. 필요한 저장소가 로컬에 없으면 내려받고, 조사 계획을 세운 뒤 하위 에이전트에 범위를 정해 맡긴다. 하위 에이전트는 맡은 저장소의 관행과 목표를 고려해 보고서를 남긴다. 상위 에이전트는 이 결과들을 읽어 시스템 사이의 연결을 설명하고, 필요하면 순서도나 시스템 관계도를 만든다.
보고서 형식은 Zod 스키마로 정의한 JSON으로 맞췄다. 에이전트마다 제각각인 인수인계를 피하고, 상위 에이전트가 필요한 항목을 찾아 읽도록 하기 위해서다. 최종 산출물은 하나의 HTML 파일이다. 요약과 영역별 상세 결과에 더해 사용자의 질문, 상위 에이전트가 하위 에이전트에 내린 지시까지 담아 다른 사람에게 파일로 전달할 수 있게 했다.
브레인스토밍도 비슷하게 나눴다. 각 영역에서 가능한 해법과 장단점, 권장안을 먼저 검토하고, 상위 에이전트가 이를 비교해 전체 시스템에 맞는 접근을 제안했다. 조직 구조와 엔지니어링 전략을 고려하는 별도 역할도 뒀다. Candost가 OpenCode를 택한 이유 중 하나는 작업에 따라 모델과 공급자를 바꿀 수 있다는 점이었다. 비개발자인 자신의 PM도 쓸 수 있는 데스크톱 앱이 있다는 점을 함께 들었다.
매주 바뀐 조직 정보는 누가 확인하는가
조사 공간을 만들어도 정보가 오래되면 답이 어긋난다. 그가 모으려던 정보에는 팀 사이에 주고받는 데이터, 폐기하려는 흐름, 새로 시작할 흐름, 꼭 필요하지 않으면 바꾸고 싶지 않은 흐름이 들어 있었다. 이런 사정은 회의나 Slack 대화에 흩어져 있었다. 그는 문서 전체를 검색하는 RAG 시스템을 만드는 대신, 초기 정보를 정리하고 지난 일주일의 변화를 갱신하는 방식을 택했다.
주간 수집 에이전트는 지정한 Notion 공간과 Slack 채널에서 지난주의 변경을 조사한다. 보고서를 첨부한 GitHub 이슈를 만들고 Cursor Cloud Agent에 갱신을 맡긴다. Cursor는 이슈와 보고서, 관련 맥락 파일을 읽고 수정 제안인 풀 리퀘스트(PR)를 만든다. 마지막에는 Candost가 보고서와 PR을 모두 읽어 오류나 불필요한 내용을 고친 뒤 병합하고 이슈를 닫는다.
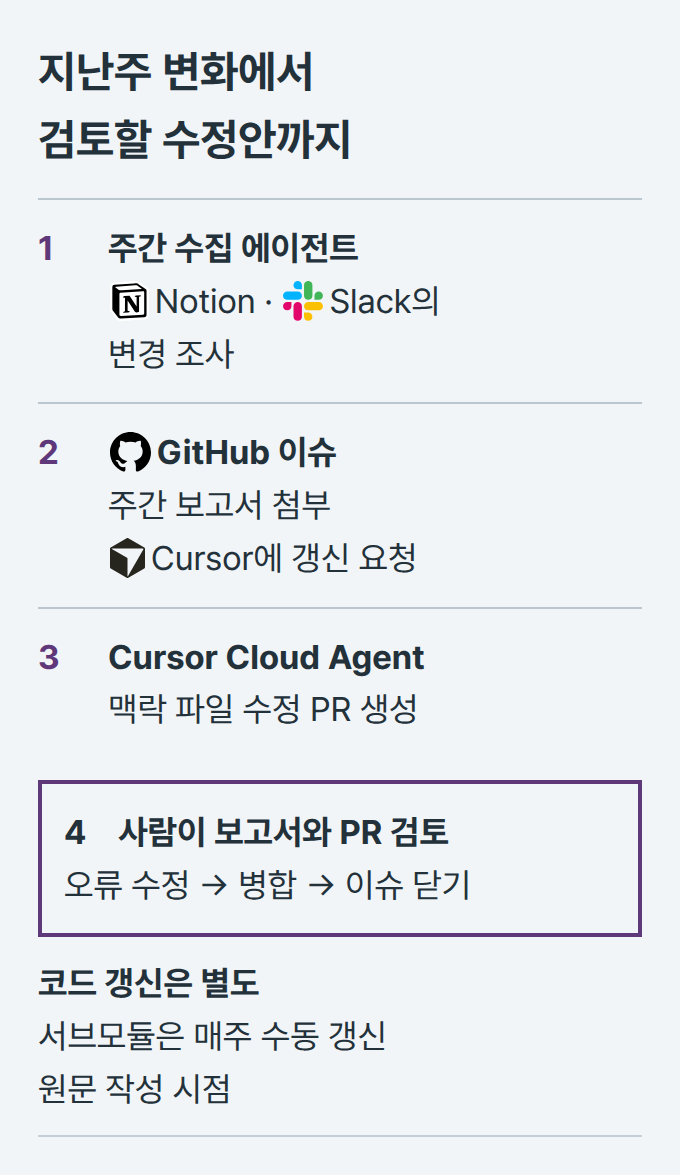
주간 수집에는 100만 토큰 맥락 창을 가진 모델을 썼고, 더 작은 맥락 창으로는 실패했다고 적었다. 코드 서브모듈을 최신 상태로 맞추는 일은 글을 쓴 시점에도 매주 직접 했다. 조직 맥락 수정은 자동으로 제안하되 사람이 병합하고, 코드 갱신까지 모두 자동화된 상태는 아니었다.
Candost는 이 구성으로 여러 영역에 걸친 질문을 조사하고 해법을 검토할 수 있었다고 설명한다. 결과를 공유할 때는 대화를 다시 요약하는 대신 HTML 보고서를 보냈다. 회의 시간이나 인력 비용이 얼마나 줄었는지는 수치로 제시하지 않았다. PM과 기술 조직 운영자에게 참고가 되는 것은 그가 실제로 거친 순서다. 저장소 몇 개로 질문을 시험하고, 팀의 계획을 담은 파일을 고쳤으며, 매주 갱신 보고서와 PR을 직접 읽었다.
출처: Candost, Building an AI Hive Mind to Understand Systems as a Manager