
2026년 8월 17일 GitHub 장애는 7시간 47분 동안 개발팀의 기본 작업 경로를 끊었다. github.com, 인증, API, Pull Request, Issues, GitHub Actions, Copilot이 함께 영향을 받았다. 배포를 멈추는 데서 끝나지 않았다. 코드 확인, 자동화 실행, 권한 확인, AI 보조까지 한 플랫폼의 여러 기능에 묶여 있던 업무가 같은 시간대에 막혔다.
GitHub의 사후 보고서는 이번 일을 단순한 서버 증설 부족으로 설명하지 않는다. Central US 데이터센터에서 새 트래픽 최고치가 발생했을 때, 서비스 메시의 Istio 사이드카가 동시 처리 한계에 닿았고 자동 확장 정책은 호스트 서비스만 보고 사이드카 한계를 보지 못했다. 뒤이어 네 대의 HAProxy 노드가 흐름 한계를 소진하면서 게이트웨이 인증 경로가 느려지고 실패했다. 용량 지표가 있어도 실제 병목을 이루는 구성요소를 지표가 따라가지 못하면 장애는 인증처럼 공유도가 높은 경로로 번진다.
7시간 47분 동안 어떤 작업이 멈췄나
장애 구간은 13:28~21:15 UTC였다. 웹과 API의 최고 오류율은 약 20%, 아카이브와 원시 저장소 콘텐츠 다운로드는 약 50%까지 올랐다. SAML·OIDC 인증, SCIM, Team Sync도 영향을 받았다. 특히 public GitHub.com에 있는 워크플로 단계 정의에 의존하는 GHEC Data Residency의 Actions 워크플로까지 영향을 받았다. 사내 CI가 별도 계정이나 별도 리전에 있어도, 빌드 정의·패키지·인증·웹훅 중 한 경로가 외부 플랫폼에 연결돼 있으면 실제 장애 범위는 훨씬 넓어진다.
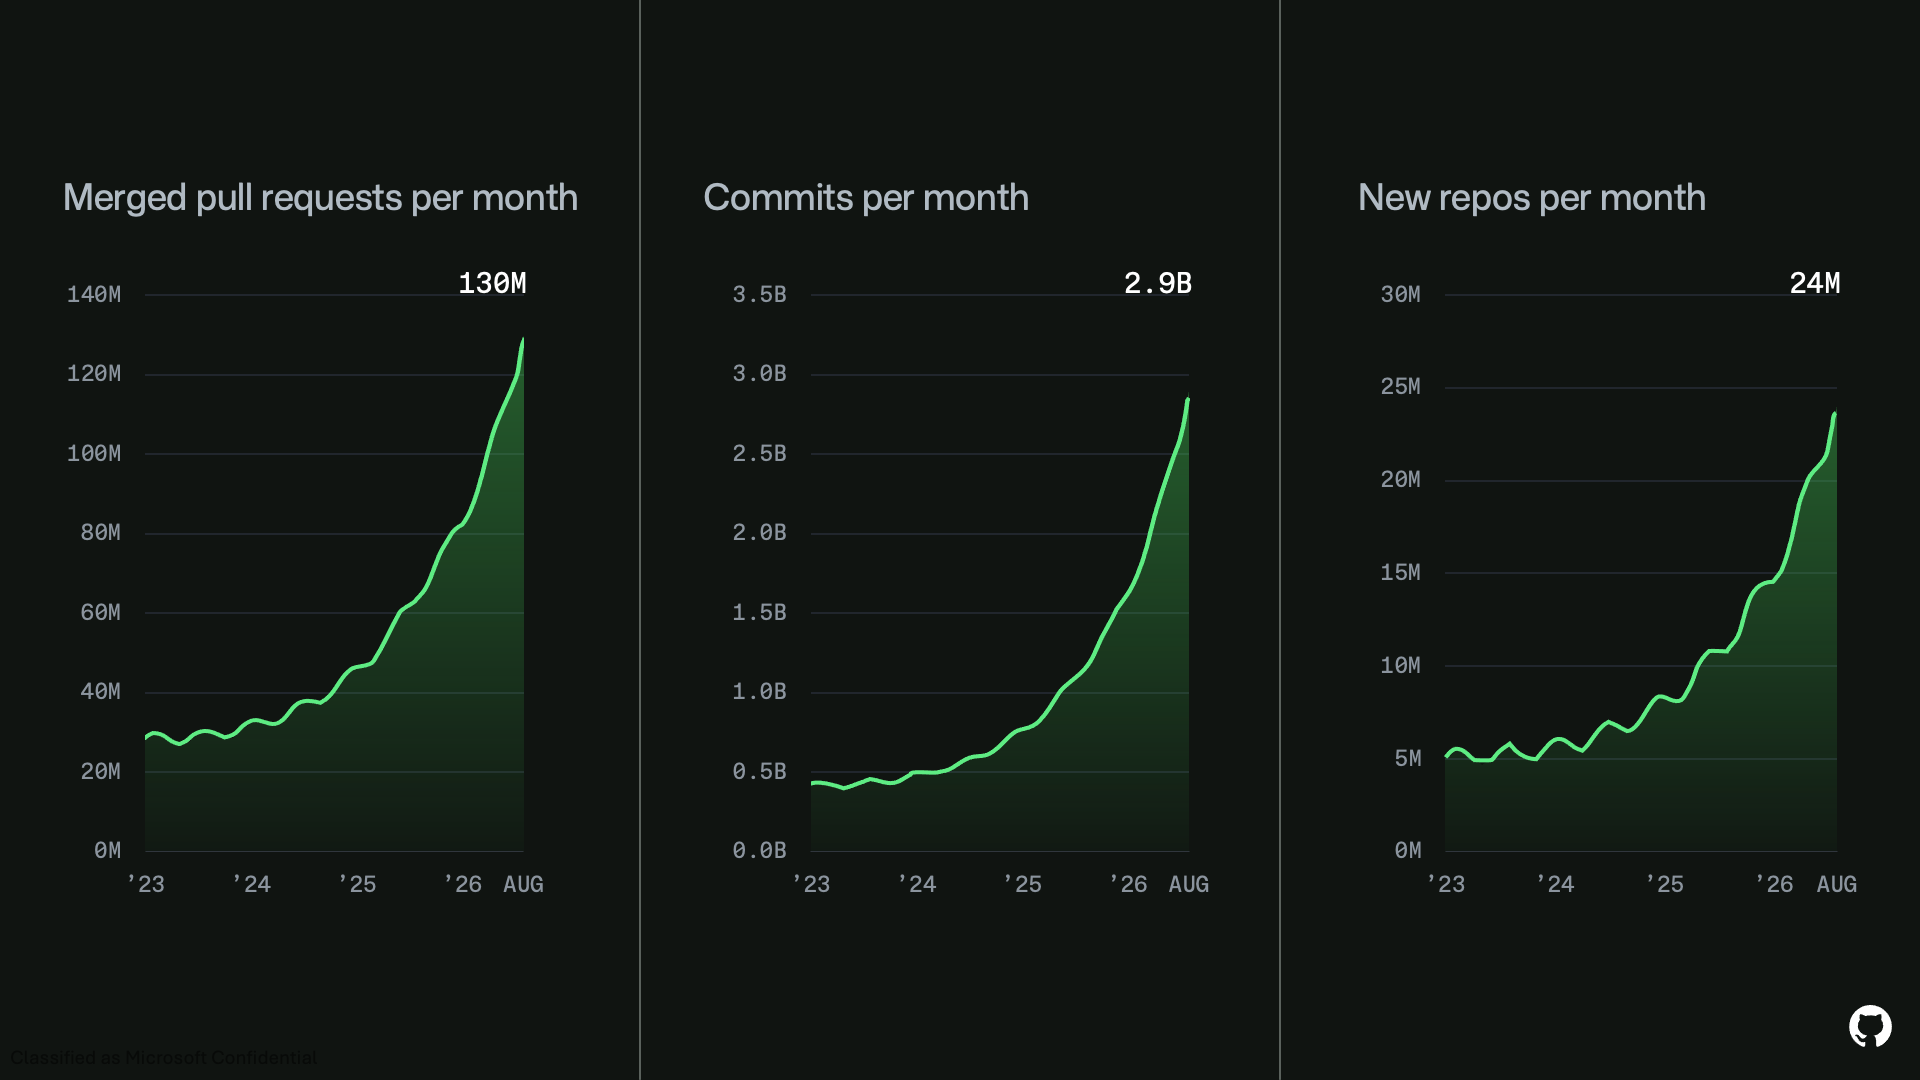
GitHub는 4월 이후 월간 커밋이 14억 건에서 29억 건으로 늘었다고 밝혔다. 아래 공식 차트는 Pull Request 병합, 커밋, 새 저장소가 함께 가팔라진 흐름을 보여 준다. 운영 점검은 평균 사용량만 보는 일이 아니다. 최고 부하가 들어올 때 인증·로드밸런서·사이드카처럼 요청을 통과시키는 좁은 구간이 어느 지표에서 먼저 포화되는지 따로 확인해야 한다.

복구를 늦춘 것은 재시도였다
초기 복구에서는 Central US의 일부 트래픽을 Northern Virginia로 옮겼다. 하지만 내부 엔드포인트의 지연 응답이 VS Code의 잠복 재시도 버그를 건드렸고, Copilot Token Service 요청은 평소 초당 7천~9천 건에서 7만~10만 건으로 약 10배 늘었다. 이미 불안정한 서비스에 호출자가 다시 보내는 요청이 겹치면, 원래 실패보다 복구 과정의 부하가 더 위험해진다.
이 사례에서 재시도는 호출자 한 곳의 옵션이 아니다. 게이트웨이, 서비스 간 호출, 클라이언트가 각자 성공률을 높이려 재시도하면 전체 요청량은 합산된다. GitHub는 즉시 조치로 게이트웨이 재시도를 줄이고, 토큰 요청을 로드밸런서에서 403으로 차단한 뒤 사이트별로 트래픽을 천천히 올렸다. 이후에는 서비스 간 통신에 일관된 재시도 한도·재시도 예산·가변 타임아웃을 적용하겠다고 했다.
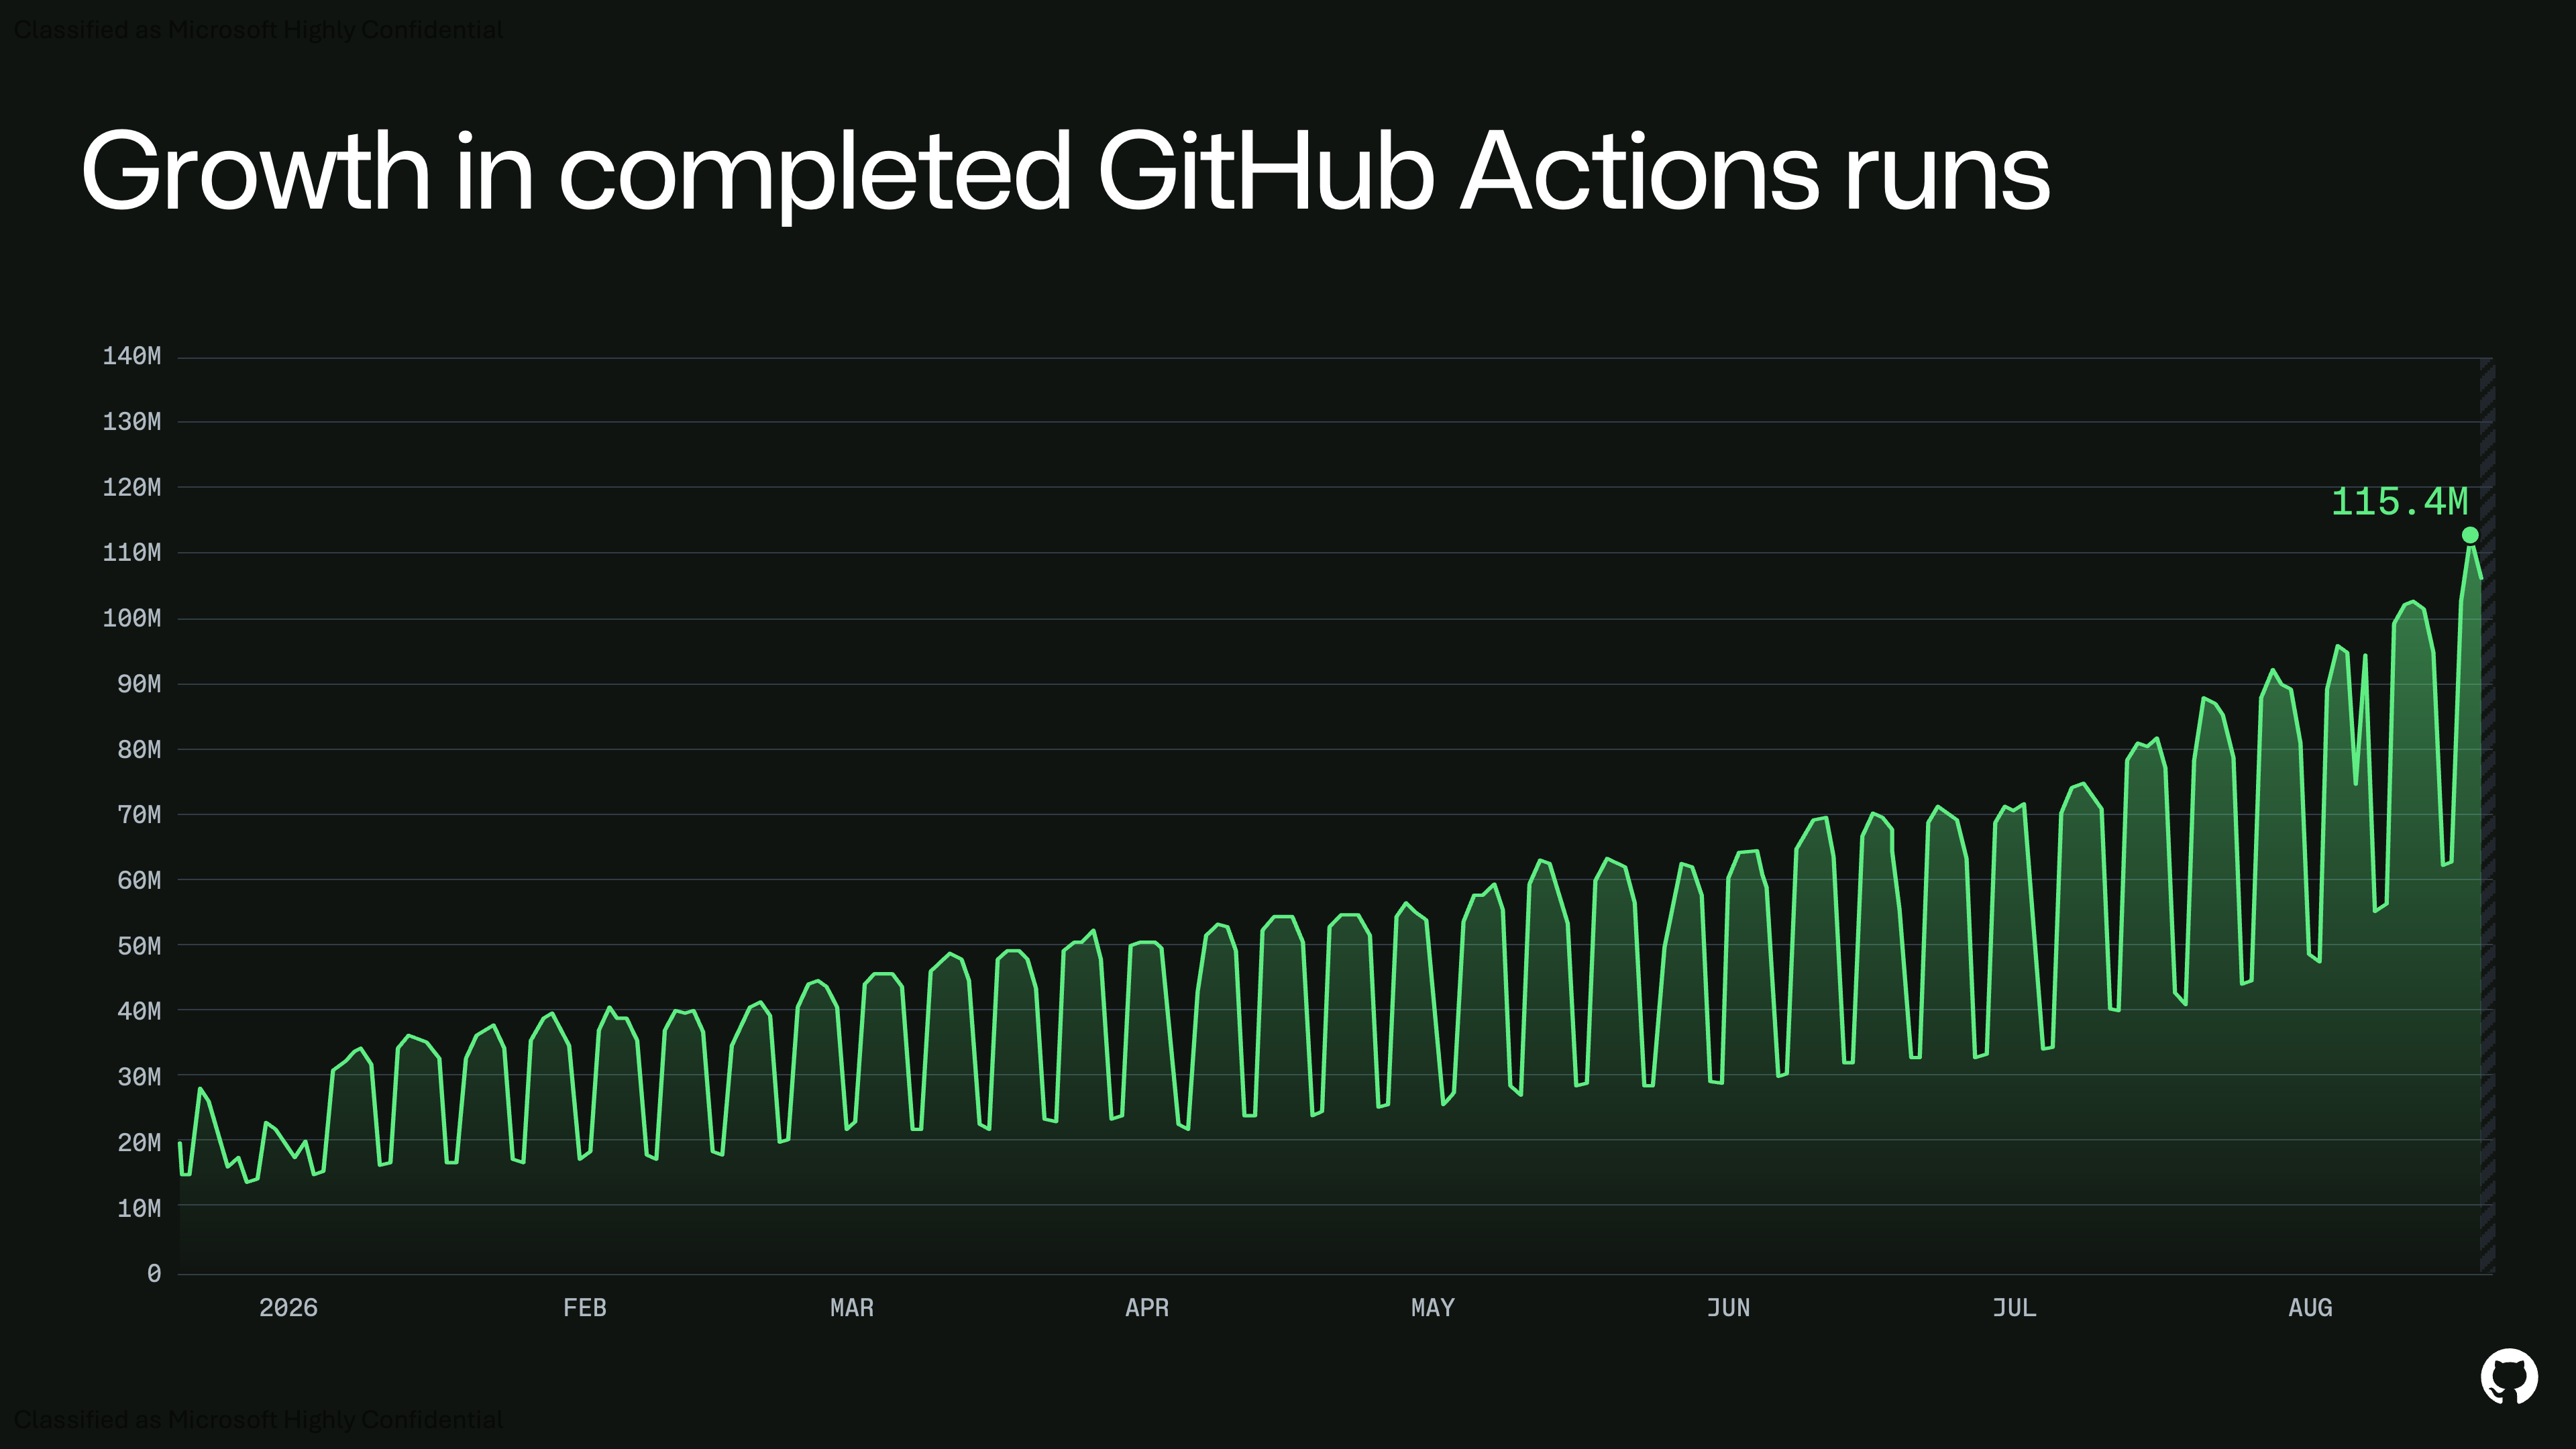
Actions 완료 실행 수가 증가한 차트도 같은 운영 조건을 보여 준다. 처리량 성장은 성공한 작업 수만큼만 읽을 수 없다. 실패 시 재시도된 작업, 큐 대기, 인증 요청, 원격 의존성 호출이 함께 늘어나는 순간을 분리해 관찰해야 한다.
다음 장애 전에 운영 점검표에 넣을 항목은 무엇인가
첫째, 자동 확장 규칙의 관측 대상과 실제 포화 지점을 한 쌍으로 점검한다. 서비스 CPU만 보지 말고 프록시·사이드카의 동시성, 로드밸런서의 연결·흐름 한계, 인증 경로의 대기 시간을 같은 부하 시험에서 확인한다. 둘째, 알림 등급이 낮은 CPU·메모리 신호도 트래픽 급증 때 실패하는 구성요소와 연결해 재검토한다. GitHub도 이번 뒤에 이 항목을 검토 대상으로 넣었다.
셋째, 호출 경계마다 최대 재시도 횟수와 전체 재시도 예산을 적고, 타임아웃 만료 뒤 실제로 몇 개의 추가 요청이 만들어지는지 계측한다. 클라이언트·SDK·게이트웨이의 설정이 따로 관리되면 한쪽의 안전한 한도가 다른 쪽에서 무력화된다. 넷째, 배포와 장애 대응 절차에 외부 의존성 목록을 넣는다. 소스 호스팅, 인증, 워크플로 정의, 패키지 내려받기, 웹훅 가운데 하나가 멈췄을 때 어떤 작업을 멈추고 어떤 작업을 계속할지 정해 둬야 한다.
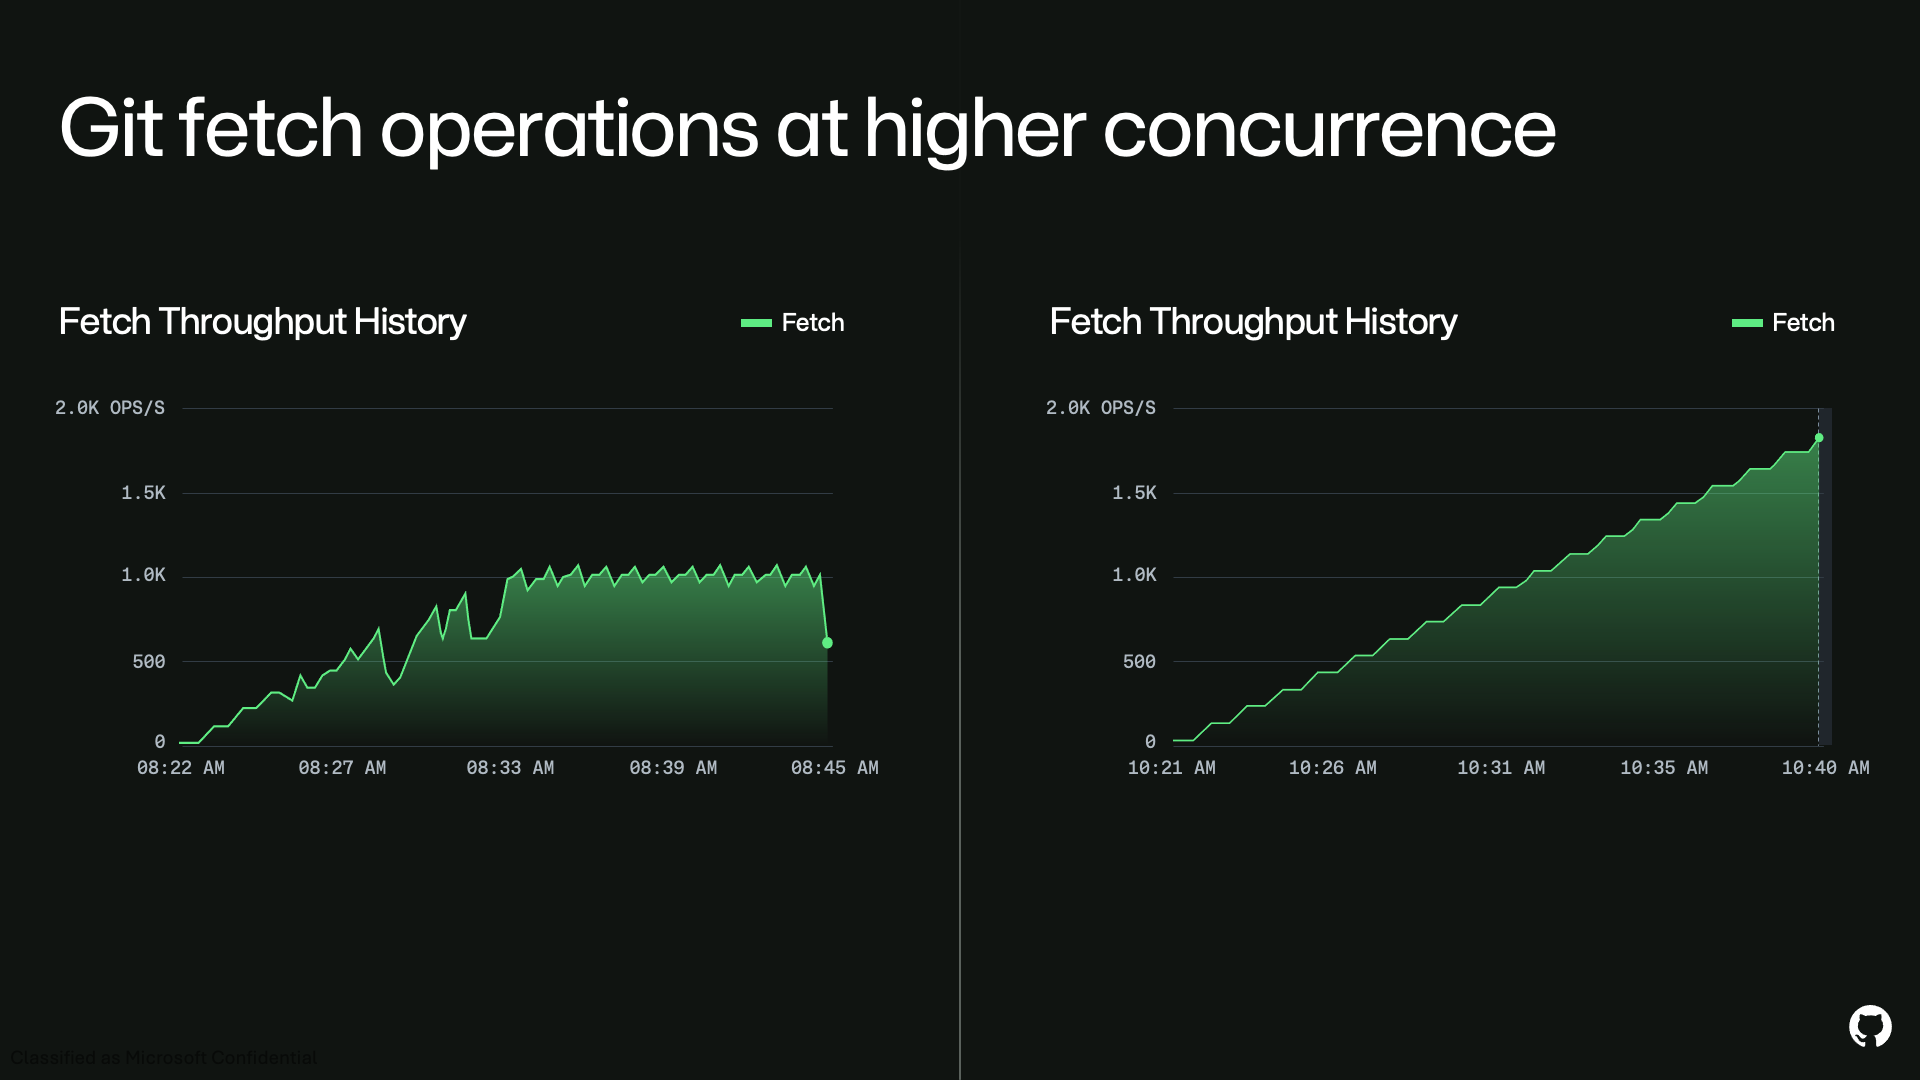
마지막으로 복구 판정은 오류율 하락 하나로 끝내지 않는다. 지역별 트래픽을 단계적으로 올리는 동안 기본 요청과 재시도 요청을 나눠 보고, 인증·CI·API처럼 공유 경로가 모두 돌아왔는지 확인한다. GitHub의 fetch 처리량 차트에서 오른쪽 그래프가 읽기 요청을 단계적으로 끌어올리는 모습처럼, 복구는 전량 복귀보다 안전한 증가 폭을 찾는 과정에 가깝다. 장애 점검표에는 서비스 목록과 함께 부하가 걸리는 병목, 재시도 증가, 외부 의존성의 영향을 연결해 적어야 한다.
출처: GitHub Blog, 「The August 17 outage, and the work ahead」 · GitHub Status incident report