
AI 비서가 매번 처음 보는 사람처럼 대하는 이유
챗봇이나 코딩 에이전트를 며칠씩 쓰다 보면 같은 불편을 반복해서 느낀다. 지난주에 설명한 선호나 프로젝트 맥락을 새 대화창을 열 때마다 다시 설명해야 한다. 대부분의 AI 서비스는 대화가 끝나면 그 안의 정보를 그냥 버리거나, 잘해야 과거 대화 텍스트를 검색 가능한 조각으로 저장해 두었다가 비슷한 질문이 오면 그 조각을 다시 끄집어내는 방식(RAG, 검색 증강 생성)을 쓴다. 이 방식은 "전에 이런 말을 한 적이 있다"는 사실은 찾아주지만, 그 정보들을 종합해 하나의 이해로 만들어 두지는 않는다. 사용자가 이사를 갔다고 세 번 다른 대화에서 언급했다면, RAG는 세 개의 조각을 따로 들고 있을 뿐 "이 사용자는 최근에 이사했다"는 하나의 결론을 만들지 않는다.
바이브코딩 스타트업 벡터라이즈(Vectorize.io)가 만든 오픈소스 프로젝트 힌드사이트(Hindsight)는 이 지점을 정면으로 다룬다. 지난주 깃허브 트렌딩 일간·주간 목록에 동시에 올랐고, 별 2만 8000개를 넘겼다. 기존 RAG나 지식 그래프 방식의 한계를 없애고 장기 기억 과제에서 가장 높은 성능을 낸다고 주장하며, 벤치마크에서 그 근거를 공개하고 있다.
기억을 저장이 아니라 세 가지 동작으로 나눈다
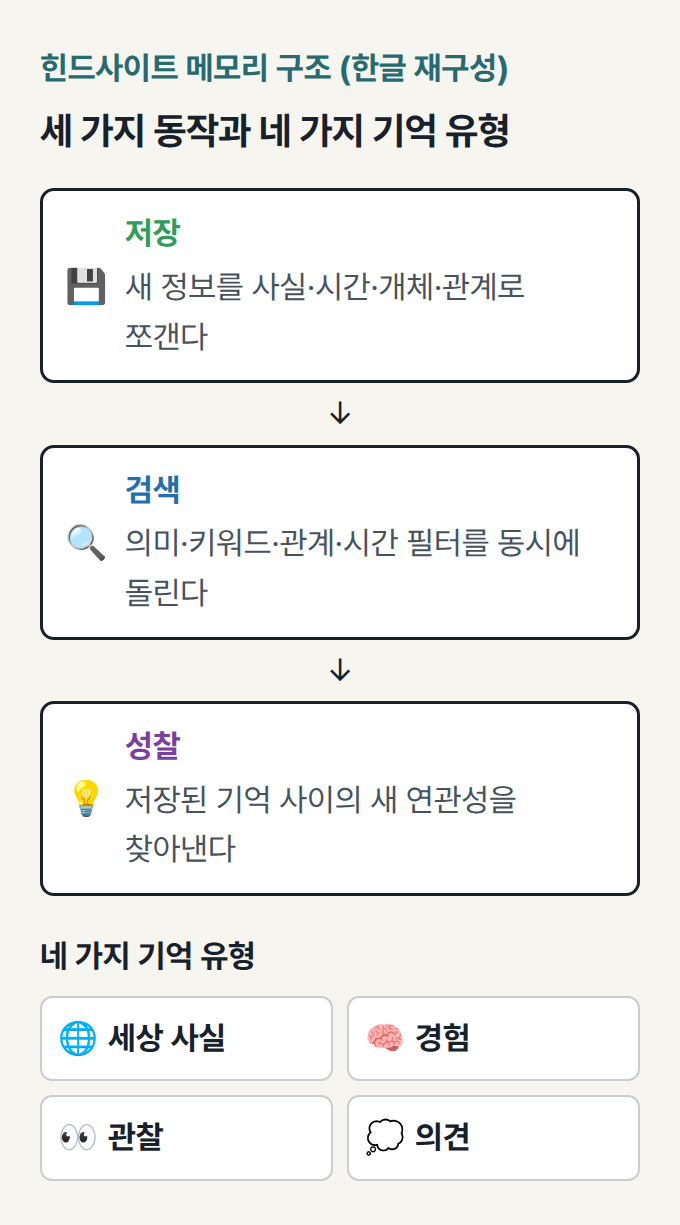
힌드사이트는 기억을 하나의 저장소가 아니라 retain(저장), recall(검색), reflect(성찰) 세 가지 동작으로 나눈다. retain은 새 정보를 LLM으로 분석해 핵심 사실, 시간 정보, 개체, 관계로 쪼갠 뒤 정형화된 형태로 저장한다. recall은 의미 유사도, 키워드, 개체·시간·인과관계 그래프, 시간 범위 필터라는 네 가지 검색을 동시에 돌려 결과를 합친다. reflect는 단순 검색이 아니라 저장된 기억들 사이의 연관성을 새로 찾아내는 동작으로, 예를 들어 영업 에이전트가 "어떤 메시지에는 답장이 왔고 어떤 메시지에는 안 왔는지"를 스스로 되짚어보는 데 쓰인다.
세 동작이 다루는 기억도 한 종류가 아니다. 힌드사이트는 세상에 대한 사실(world facts), 에이전트 자신의 경험(experiences), 여러 기억을 통합해 만든 관찰(observations), 관찰과 사실을 종합한 정신 모델(mental models)로 나눠 저장한다. 이 구조는 사람의 기억이 일화 기억과 의미 기억으로 나뉘는 방식을 본뜬 것이다.
반복해서 말해도 덮어쓰지 않고 다시 판단한다
같은 주제로 반복해서 들어오는 정보를 처리하는 방식이 이 프로젝트의 핵심 차별점이다. 새 기억이 들어와도 기존 관찰을 그냥 지우고 새로 쓰지 않는다. 대신 기존 관찰이 강화되거나, 약해지거나, 확장되도록 다시 판단한다. 각 관찰은 근거가 된 원문 인용과 증거 개수를 함께 들고 있어서, "이 사용자는 매운 음식을 못 먹는다"는 관찰이 왜 그렇게 정리됐는지 추적할 수 있다.
정신 모델은 한 단계 더 나가서, "이 사용자의 선호는 무엇인가" 같은 질문 자체를 미리 등록해 두면 힌드사이트가 답을 미리 써 두고 새 기억이 쌓일 때마다 백그라운드에서 그 답을 다시 쓴다. 에이전트가 세션을 시작할 때 이 답을 읽는 것은 그냥 데이터베이스 조회라서 LLM 호출도, 검색도 필요 없다. 이 정신 모델을 폴더 구조의 위키처럼 쌓아 둔 것이 지식 페이지(knowledge pages)로, 코딩 에이전트가 한 저장소의 아키텍처나 진행 중인 작업을 기억하는 용도로 쓰인다.
벤치마크 수치와 실제로 쓰이는 곳
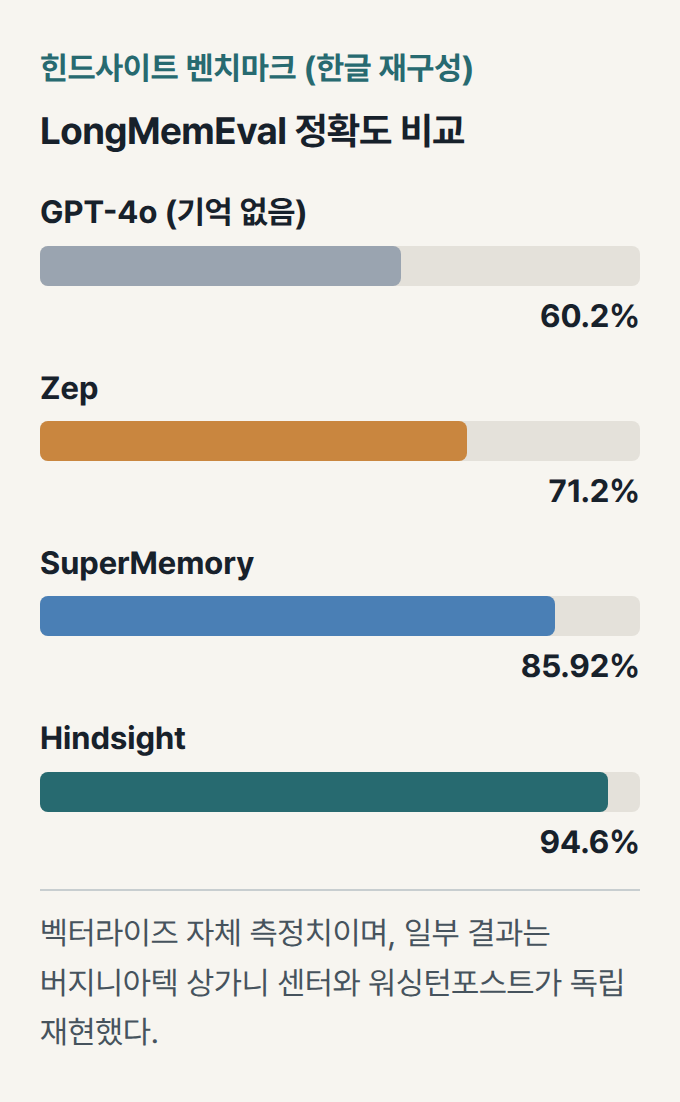
힌드사이트는 대화형 AI의 장기 기억 성능을 재는 표준 벤치마크인 LongMemEval에서 94.6%를 기록했다고 공개했다. 같은 벤치마크에서 경쟁 제품 젭(Zep)은 71.2%, 슈퍼메모리(SuperMemory)는 85.92%, 별도 기억 시스템 없이 GPT-4o만 쓴 경우는 60.2%였다. 이 수치는 벡터라이즈가 자체 측정한 것이지만, 버지니아텍 상가니 인공지능·데이터 분석 센터와 워싱턴포스트가 독립적으로 재현했다는 점을 README에서 밝히고 있다.

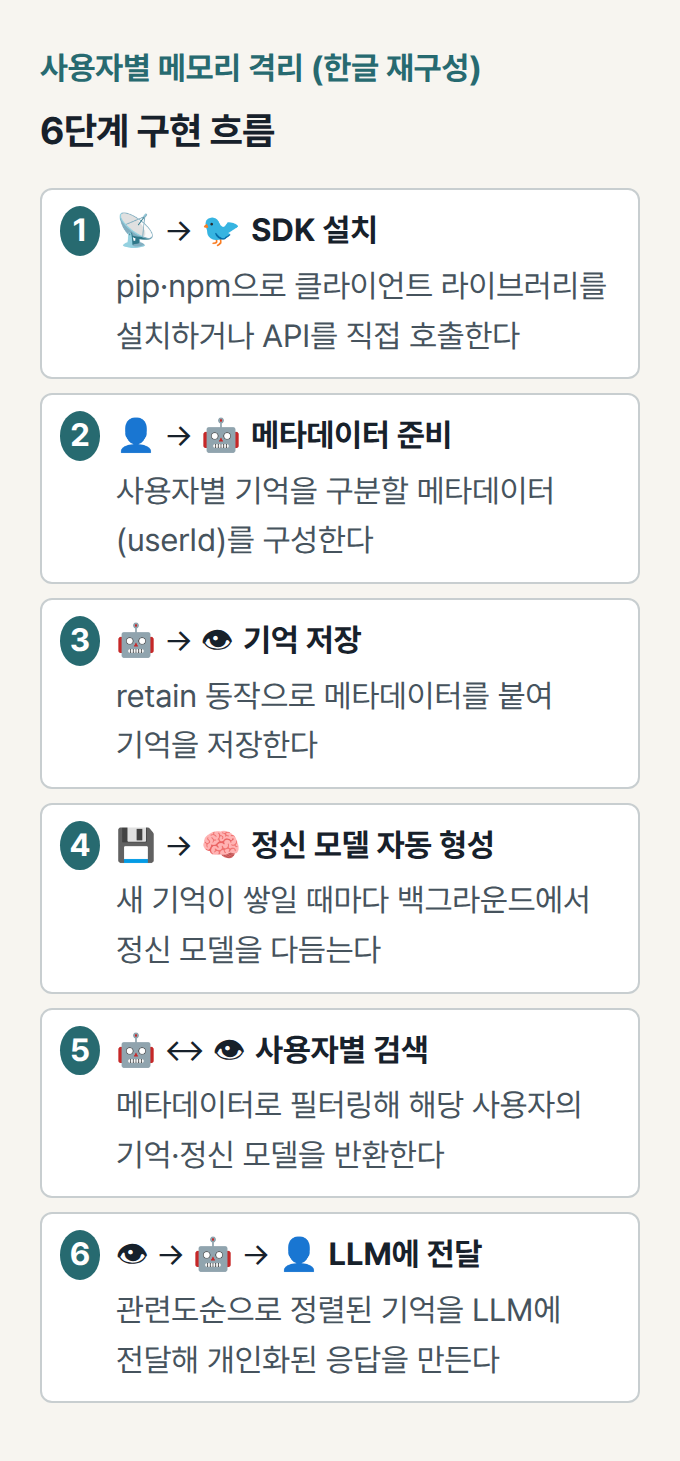
실제 쓰임은 크게 두 갈래다. 하나는 사용자별로 다른 맥락을 기억하는 개인화 챗봇이나 고객 지원 에이전트로, 대화나 도구 호출 데이터를 메타데이터와 함께 저장해 특정 사용자의 기억만 걸러 다시 불러온다. 다른 하나는 코딩 에이전트용 장기 프로젝트 메모리로, 깃 히스토리와 과거 작업 세션에서 저장소별 기억 저장소를 자동으로 만들어 클로드 코드, 코덱스 CLI, 커서 CLI 같은 60개 이상의 도구에 연결한다. 별도 설정 명령 없이 저장소를 열면 바로 주입되는 방식이라 별도 학습 곡선이 크지 않다.
도입 전에 따져볼 것
모든 에이전트에 이 구조가 필요한 것은 아니다. 벡터라이즈 스스로도 n8n처럼 단순한 워크플로에는 힌드사이트가 과할 수 있다고 문서에서 밝힌다. 또 self-hosted로 쓰려면 PostgreSQL과 pgvector, 혹은 Oracle AI Database가 필요하고, retain·reflect 각 동작마다 LLM을 호출하므로 기억이 쌓일수록 API 비용과 지연 시간이 늘어난다. 서버를 직접 운영하지 않으려면 사용량 기반 과금의 매니지드 클라우드를 택할 수 있지만, 이 경우 대화 내용이 외부 인프라에 저장된다는 점도 고려 대상이다. 세션 하나짜리 질의응답이나 짧은 자동화 작업에는 기존 RAG 검색만으로 충분하고, 힌드사이트가 값어치를 보이는 지점은 같은 사용자나 같은 프로젝트를 여러 세션에 걸쳐 다뤄야 하는 에이전트다.