
개별 부품은 누구나 이해할 만큼 단순한데, 전체는 인지범위를 초과한다. 이 글은 그 간극을 설명하는 대신, 직접 겪게 한다.
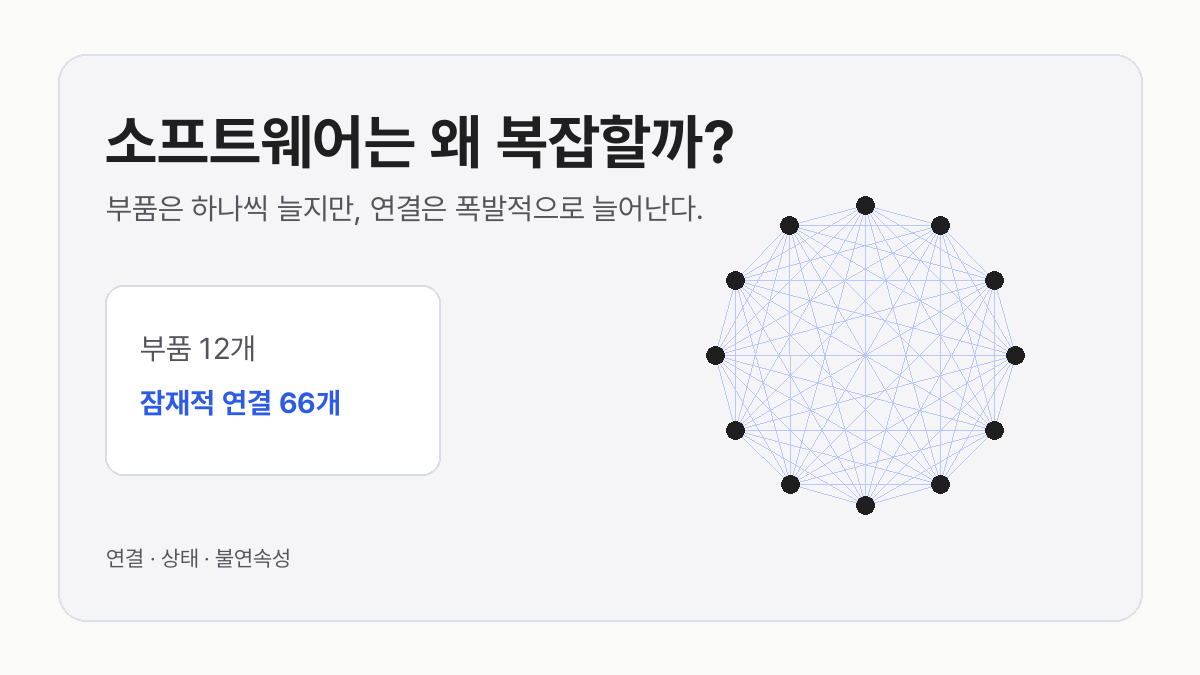
부품(점)은 하나씩 늘어나지만, 부품 사이의 잠재적 연결(선)은 폭발적으로 늘어난다. 이 글 전체가 이 그림 하나에 대한 설명이다.
01
물리 직관과 반대로 자라는 복잡도
물리 세계에서 규모가 커진다는 것은 대부분 반복이다. 큰 건물은 같은 벽돌이 더 많은 것이고, 큰 공장은 같은 라인이 더 많은 것이다. 그래서 인간의 직관은 "크다 = 같은 것의 반복"으로 훈련되어 있다. 그런데 소프트웨어에서 반복되는 것은 즉시 함수 하나로 압축된다. 같은 일을 두 번 쓰는 코드는 나쁜 코드이고, 곧바로 하나로 합쳐지기 때문이다. 그 결과 코드베이스에 남는 것은 전부 서로 다른 것들이다. "소프트웨어는 건축 같다"는 설명을 듣고도 실제 감각과 자꾸 어긋났다면, 어긋난 지점이 바로 여기다. 그런 설명이 옮겨주는 것은 구성요소인데, 정작 복잡도는 자라나는 방식에 있기 때문이다.
물리 세계의 큰 것
같은 부품의 반복. 하나를 이해하면 전체를 이해한 것이다.
소프트웨어의 큰 것
전부 다른 부품의 연결. 반복은 이미 압축되어 사라졌다.
02
복잡도를 이루는 네 가지 성질
소프트웨어 복잡도의 구조는 네 가지 성질로 이루어져 있다.
초선형성. 상호작용의 수가 부품 수보다 훨씬 빨리 자란다. 부품이 10배가 되면 잠재적 상호작용은 100배 이상이 된다.
비반복성. 남아있는 부품이 전부 서로 다르다. 하나를 이해했다고 다음 것을 이해한 게 아니다.
상태 의존성. 시스템의 행동이 눈에 보이지 않는 누적 이력에 의존한다. 같은 입력이 어제와 오늘 다른 결과를 낸다.
불연속성. 정확도와 작동 사이에 연속성이 없다. 99.9% 맞는 시스템이 0% 작동할 수 있다.
물리 세계에는 이 네 가지를 동시에 가진 대상이 없다. 우리가 아는 어떤 사물과도 닮지 않았다는 뜻이다.
03
초선형성은 산수다
네 가지 중 초선형성은 설명조차 필요 없다. 초등 산수만으로 정확히 볼 수 있고, 근사가 아니라 사실 그 자체다.
부품이 n개면 부품 쌍은 n(n−1)/2개다. 부품 10개면 가능한 쌍이 45개, 부품 100개면 4,950개. 부품은 10배가 됐는데 잠재적 상호작용은 110배가 됐다. 아래 슬라이더를 직접 움직여보자. 점이 하나씩 늘어날 때 선이 얼마나 빨리 늘어나는지가 이 성질의 전부다.
부품 6개 · 잠재적 상호작용 15개
04
비유 대신 동형체
나머지 성질들은 산수만으로는 잡히지 않는다. 그래서 이 글은 지금부터 비유(analogy) 대신 동형체(isomorph)를 쓴다. 비유는 표면 특징을 공유하고, 동형체는 구조 자체를 공유한다. 건축은 비유지만, 스프레드시트는 비유가 아니다. 셀이 셀을 참조하는 순간 그것은 진짜 프로그램, 즉 데이터플로우 그래프이기 때문이다.
축소 모형은 직관을 왜곡하지 않는다. 실물의 작은 버전이기 때문이다. 아래 그림들은 소프트웨어에 대한 그림이 아니라, 작은 소프트웨어 그 자체다.
그리고 여기에는 서술로는 넘을 수 없는 벽이 하나 있다. 복잡도는 대상의 성질이 아니라 대상과 인지 사이의 관계다. "인지범위를 초과한다"는 문장은 인지범위 안에 들어온다. 그래서 이 문장을 이해하는 것과 초과를 직접 겪는 것은 다른 사건이다. 다음 그림에서 겪어보자.
05
인지가 깨지는 지점
아래는 작은 스프레드시트다. 동그라미 하나가 셀 하나(숫자 하나가 들어 있는 칸)이고, 선은 "왼쪽 셀의 값이 오른쪽 셀의 계산에 쓰인다"는 뜻이다. 처음 8개짜리는 누구나 아는 계산이다. 단가와 수량으로 소계를 구하고, 할인을 빼서 공급가를 만들고, 부가세를 붙여 합계를 낸다.
셀을 클릭하면, 그 셀의 숫자를 바꿨을 때 다시 계산되는 셀 전부가 표시된다. 먼저 "단가"를 눌러 머릿속 예측과 맞는지 확인해보자. 맞을 것이다. 그다음 셀 20개, 48개로 늘려 같은 것을 해보자. 이름만 뗐을 뿐 똑같은 셀들이다. 어느 순간부터 예측이 불가능해지는데, 예측이 무너지는 그 순간이 복잡도가 처음으로 몸에 닿는 순간이다.
"단가"를 눌러보자. 몇 개의 셀이 다시 계산될까?
06
상태는 보이지 않는 이력이다
마지막으로 상태 의존성이다. 물리 기계는 보면 지금 무슨 상태인지 대체로 보인다. 소프트웨어는 지금까지 일어난 입력의 누적 이력이 보이지 않는 곳에 쌓여서 다음 동작을 결정한다. "같은 버튼을 눌렀는데 어제는 됐고 오늘은 안 되는" 경험의 정체가 이것이다.
아래 두 버튼은 겉보기에 완전히 같다. 둘 다 눌러보자.
버튼 A
누를 때마다 켜짐과 꺼짐을 오간다.
누른 횟수: 0
버튼 B
언제 켜질지 예측해보자.
누른 횟수: 0
07
실물의 스케일
여기까지 왔다면 이제 우리 손에는 네 개의 축소 모형이 쥐어져 있다. 실물을 볼 차례다. Gource 같은 도구는 실제 코드베이스의 의존성 그래프가 커밋을 따라 자라나는 과정을 영상으로 보여준다.
이 영상을 처음부터 봤다면 막연한 경외로 끝났을 것이다. 하지만 방금 셀 48개에서 인지가 무너지는 것을 겪었다면, 수만 노드짜리 그래프를 보면서 정확히 알게 된다. 저 점 하나하나가 아까 그 셀이고, 저 선 하나하나가 아까 그 참조라는 것을. 압도가 경외가 아니라 구조에 대한 정확한 감각이 된다.
이 글은 비유를 한 번도 쓰지 않았다. 쓴 것은 산수 하나와 축소 모형 세 개뿐이다. 복잡도의 각 성질을 실제로 가진 최소 시스템을 손에 쥐고, 인지가 깨지는 지점까지 직접 키워보는 것, 그것이 소프트웨어가 왜 복잡한지를 아는 가장 정확한 길이다.
AI 에이전트와 함께 무언가를 만들어본 비개발자라면 이 경로가 이미 익숙할 것이다. 복잡도는 좋은 설명을 들어서가 아니라 직접 부딪혀야 이해된다. 이 글은 그 부딪힘을 몇 분 안에 겪을 수 있게 압축했을 뿐이다.