
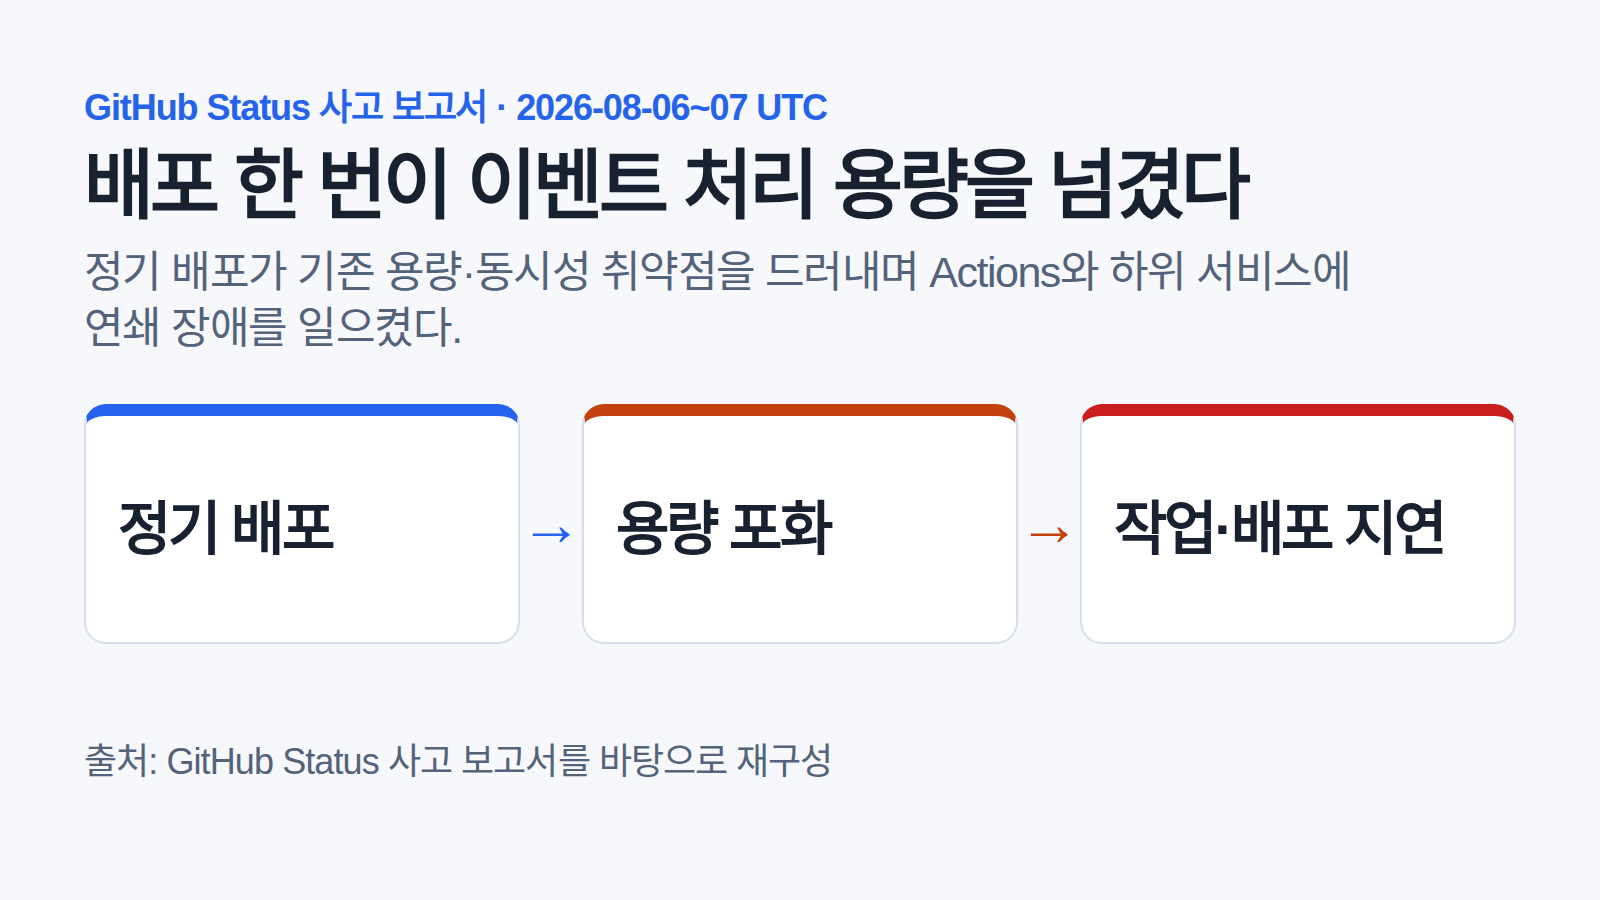
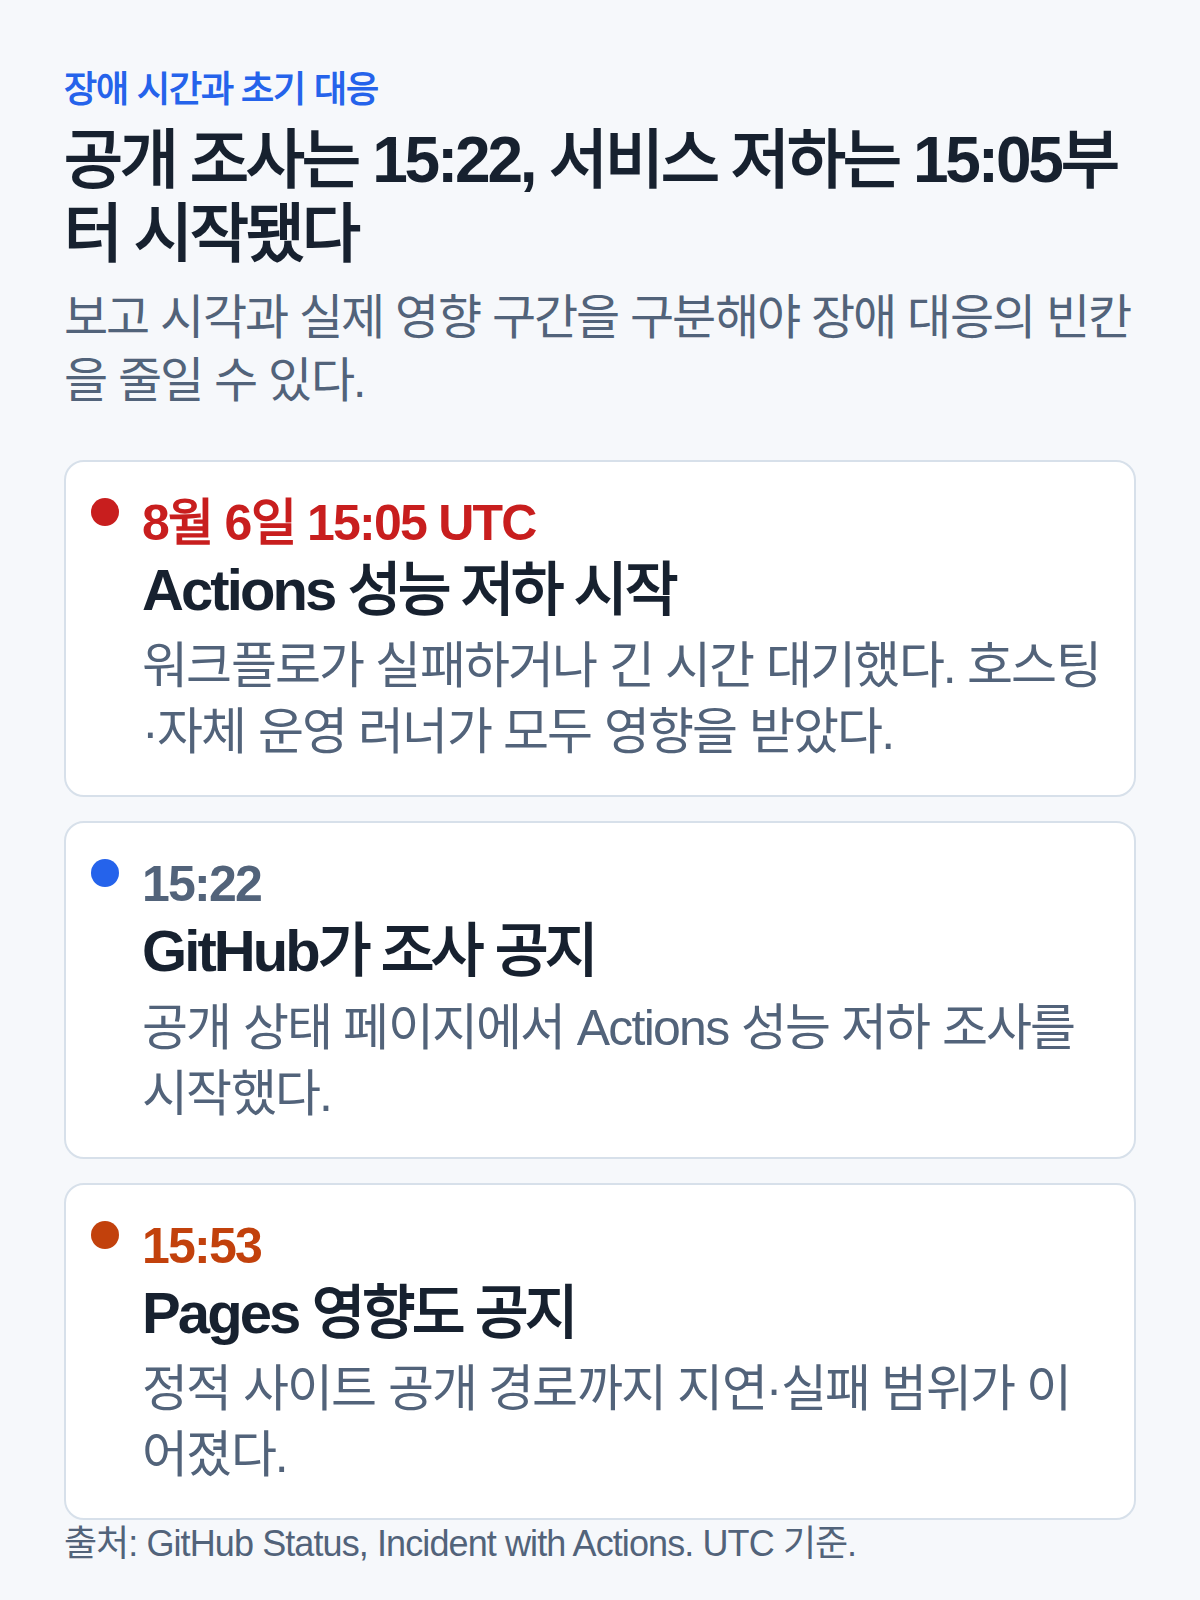
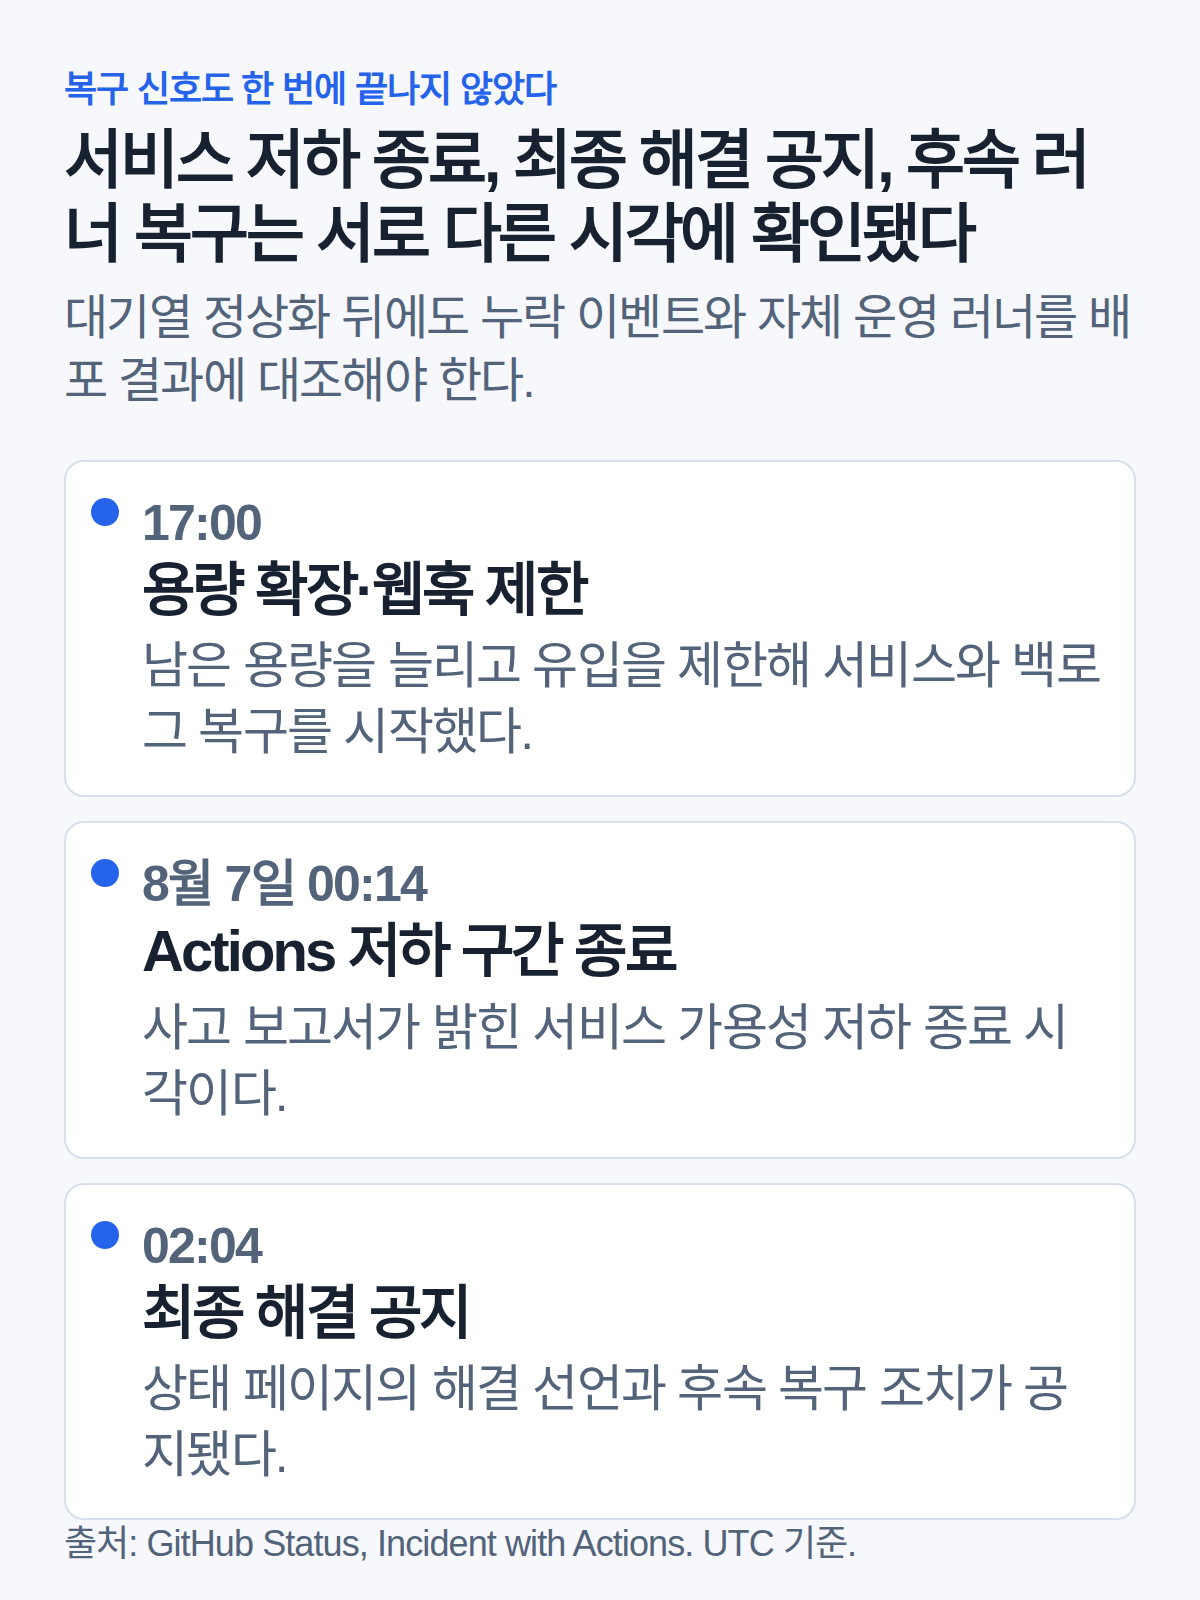
2026년 8월 6일 GitHub Actions의 가용성 저하는 UTC 15시 05분부터 이튿날 00시 14분까지 이어졌다. GitHub는 15시 22분 Actions 성능 저하 조사를, 15시 53분 Pages 성능 저하를 공지했고, 02시 04분 최종 해결을 선언했다. 이 구간에서 워크플로 시작·실행·웹훅 트리거·Pages가 연쇄적으로 영향을 받았다.
최종 사고 보고서는 내부 Actions 서비스의 정기 배포가 기존 용량·동시성 취약점을 드러냈다고 설명한다. 포드 교체 중 남은 용량이 포화되면서 서비스가 멈추고, 여러 클러스터와 하위 서비스로 영향이 번졌다. 이용자 조직의 관점에서는 더 분명한 사실이 남는다. 빌드, 배포 승인, 정적 사이트 공개가 Actions의 실행 가능 여부에만 기대고 있었다면, CI 장애는 곧 출시와 복구 판단의 장애가 된다.
코드 변경은 어느 지점에서 배포와 분리됐나
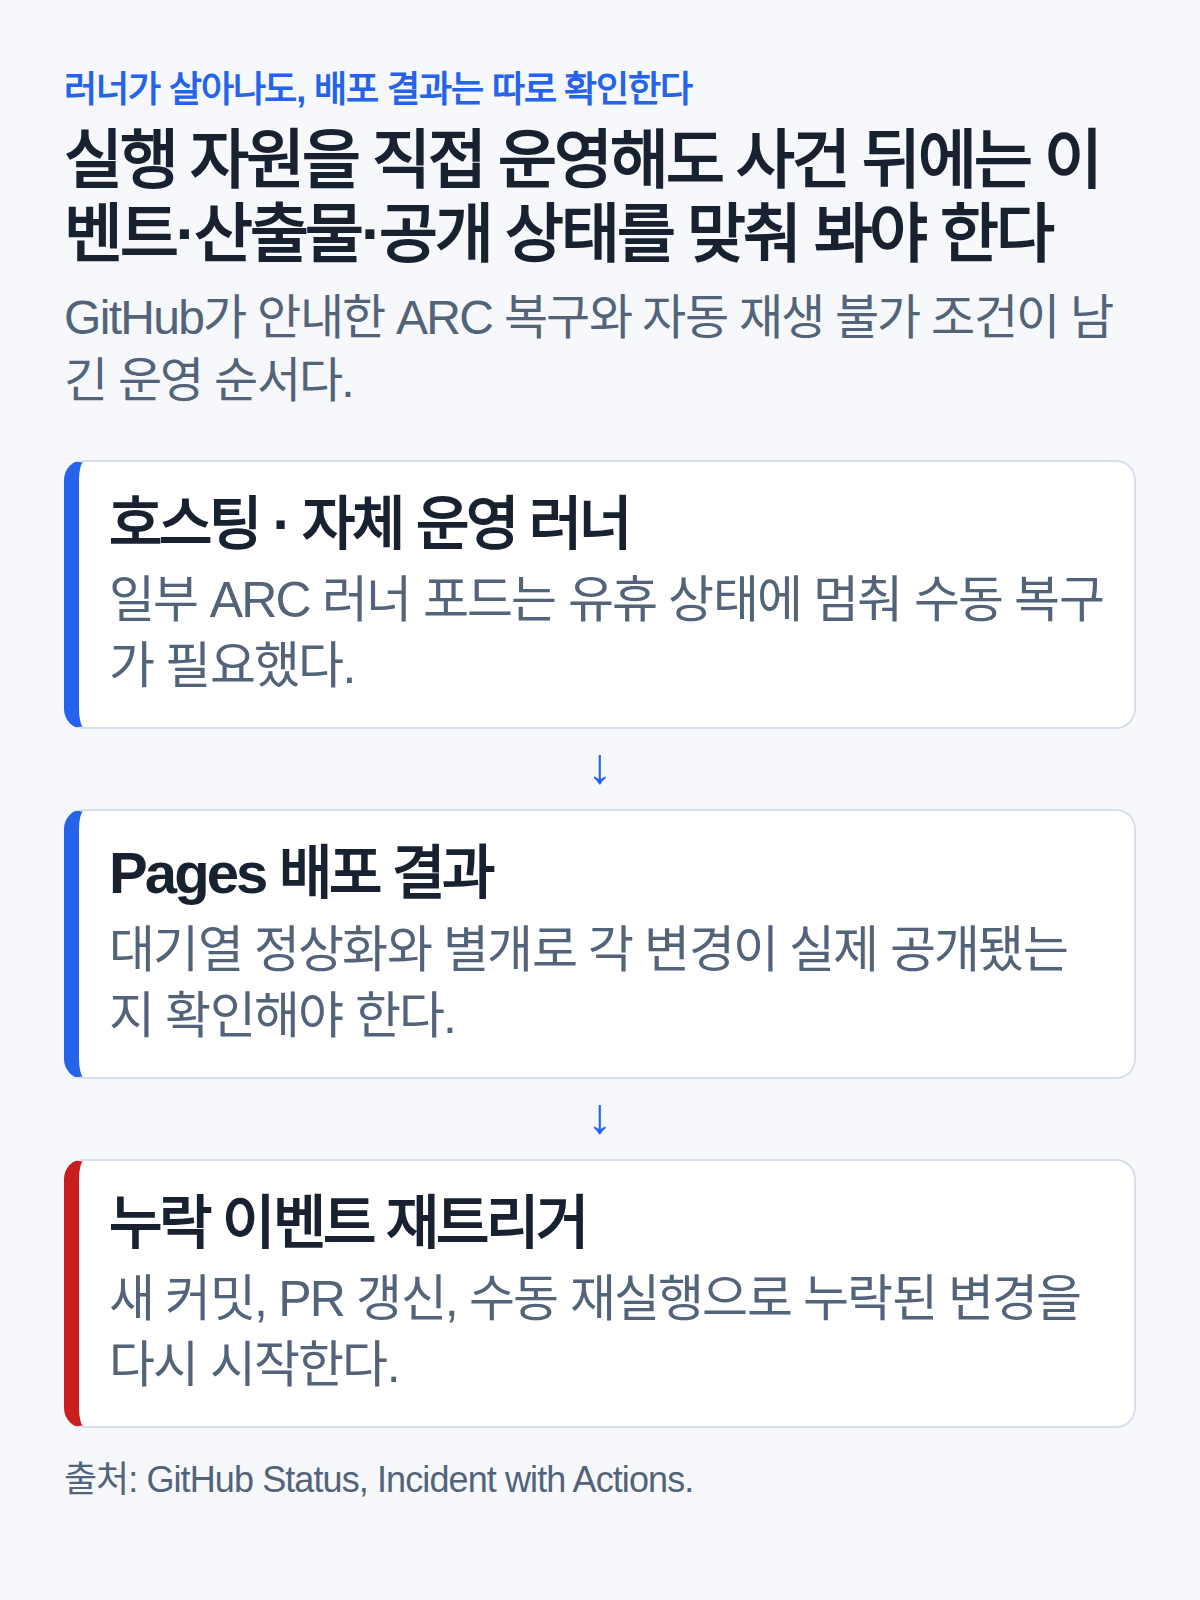
장애 초기에 GitHub는 일부 워크플로가 시작하지 못하거나 도중에 실패하고, Actions REST API 요청 일부도 오류를 낸다고 알렸다. 복구 과정에서는 대기열을 비우기 위해 웹훅 트리거를 제한했다. UTC 20시 34분 공지에서 처리 중인 웹훅은 약 15%였고, 푸시와 풀 리퀘스트 같은 이벤트 다수가 새 워크플로를 만들지 못했다. 실행 대기열의 성공 비율은 초기 30~40% 수준에서 약 65%, 97%, 99%로 개선됐지만, 트리거 자체가 제한되면 ‘코드는 이미 합쳐졌는데 배포가 시작되지 않는’ 상태가 남는다.
여기서 중요한 구분은 실행 실패와 이벤트 누락이다. 실행이 시작된 워크플로는 재시도하거나 대기열이 비워진 뒤 이어질 수 있다. 반면 GitHub는 처리되지 않은 푸시·풀 리퀘스트 이벤트를 자동으로 재생할 수 없다고 공지했다. 영향을 받은 고객은 새 커밋 푸시, 풀 리퀘스트 갱신, 수동 워크플로 재실행처럼 다시 트리거를 만들어야 했다. 배포 파이프라인의 관측 대상이 ‘실패한 실행’만이면 이 종류의 누락은 복구가 끝난 뒤에도 보이지 않는다.
호스팅 러너와 자체 운영 러너가 함께 멈추면 무엇이 달라지나
이번 장애는 GitHub 호스팅 러너와 자체 운영 러너에 모두 영향을 줬다. 자체 운영 쪽에서는 일부 Actions Runner Controller(ARC) 러너 포드가 유휴 상태에 멈췄다. GitHub가 안내한 복구 방법은 해당 포드를 kubectl로 삭제하거나 ARC 애플리케이션을 재배포하는 것이며, ARC가 대체 러너를 만든다. 다음 Actions Runner와 ARC 릴리스에는 이 수동 조치를 줄일 자동 복구 메커니즘을 넣겠다고 했다.
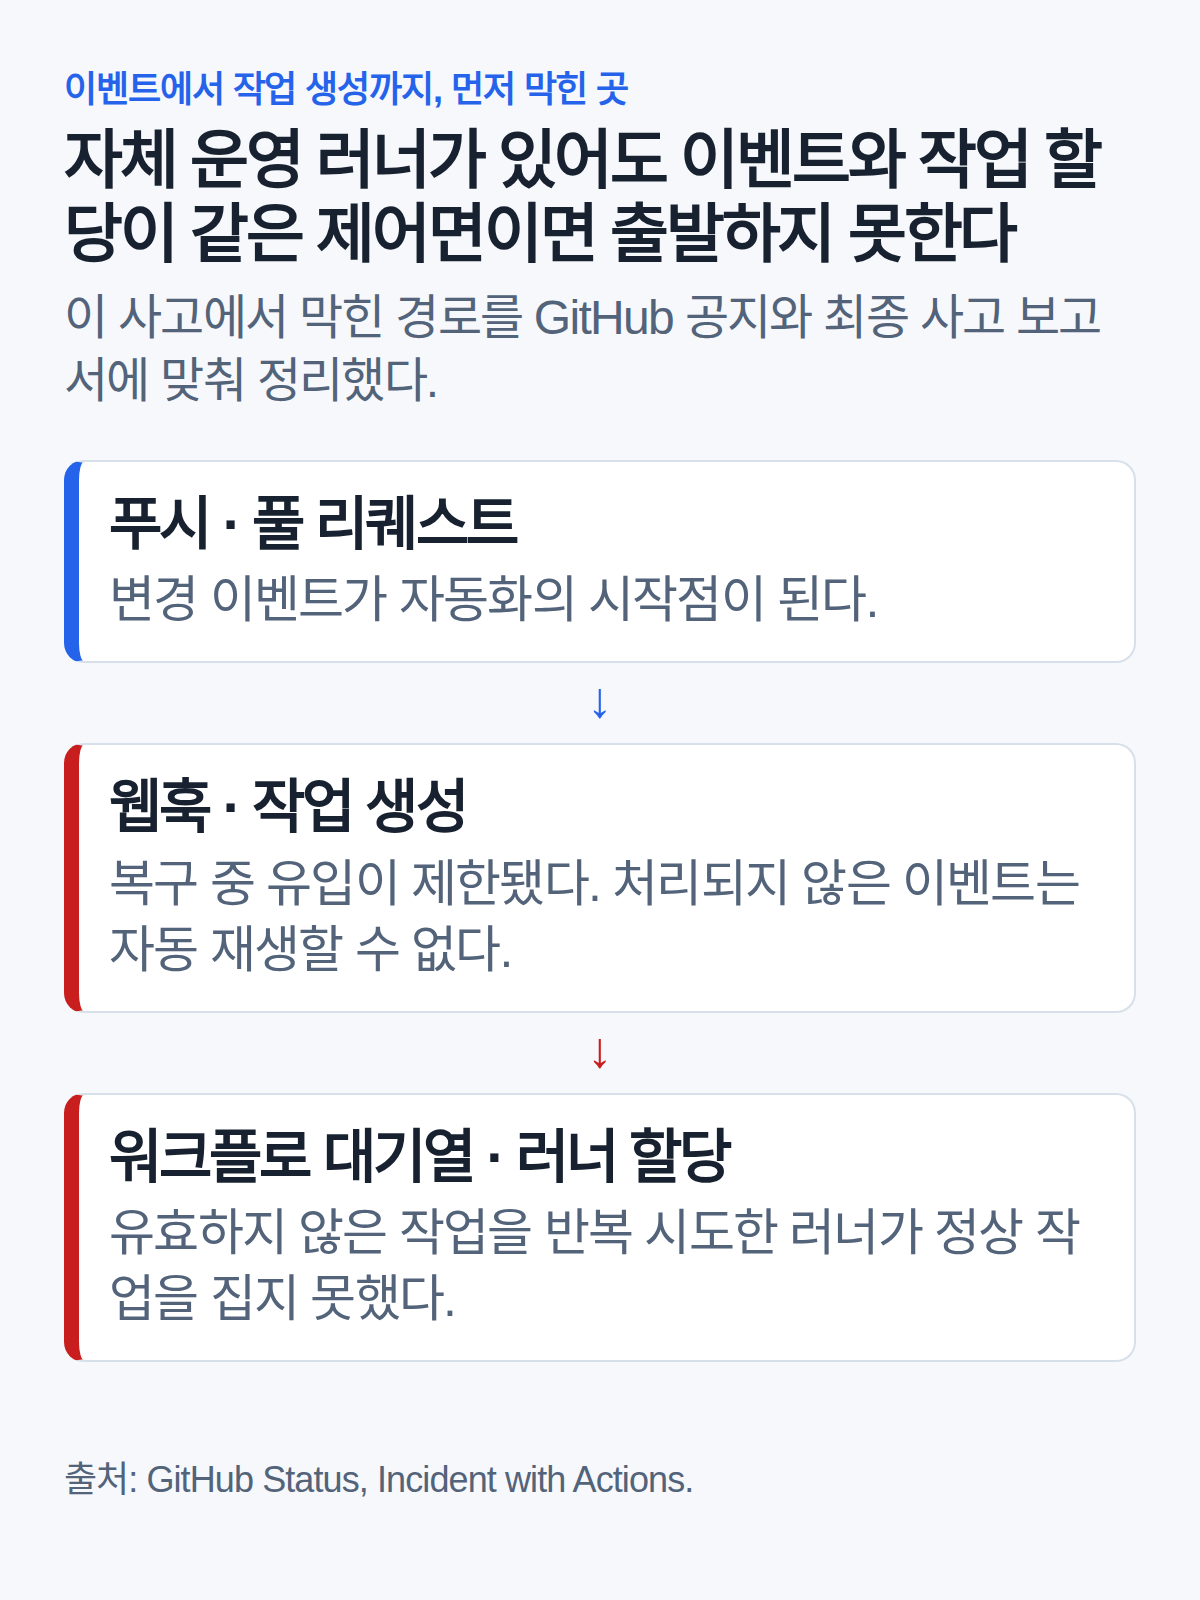
자체 운영 러너를 쓴다고 자동으로 독립성이 생기지는 않는다. 러너 컴퓨팅 자원을 직접 보유하더라도 이벤트 수신, 작업 할당, 실행 제어가 같은 플랫폼 제어면에 묶여 있으면 작업은 출발하지 못한다. 반대로 호스팅 러너만 쓰는 팀도 ‘작업이 실행됐는가’와 ‘특정 커밋의 산출물이 공개됐는가’를 다른 신호로 기록하면, 대기열 정상화 뒤 확인해야 할 범위를 즉시 좁힐 수 있다.
다음 장애에서 배포 판단을 남기려면 무엇을 분리해야 하나
첫째, 커밋·풀 리퀘스트마다 트리거 요청과 실제 실행 식별자, 완료 결과를 분리해 남겨야 한다. 실행 ID가 없는 변경은 실패한 실행이 아니라 시작되지 않은 변경이다. 둘째, 성공한 빌드의 산출물과 버전을 보관해야 한다. 코드 검증을 다시 돌리지 않아도 이미 승인된 산출물을 배포 단계에서 재사용할 수 있어, 실행 시스템의 회복과 서비스 공개를 같은 대기열에 세우지 않게 된다.
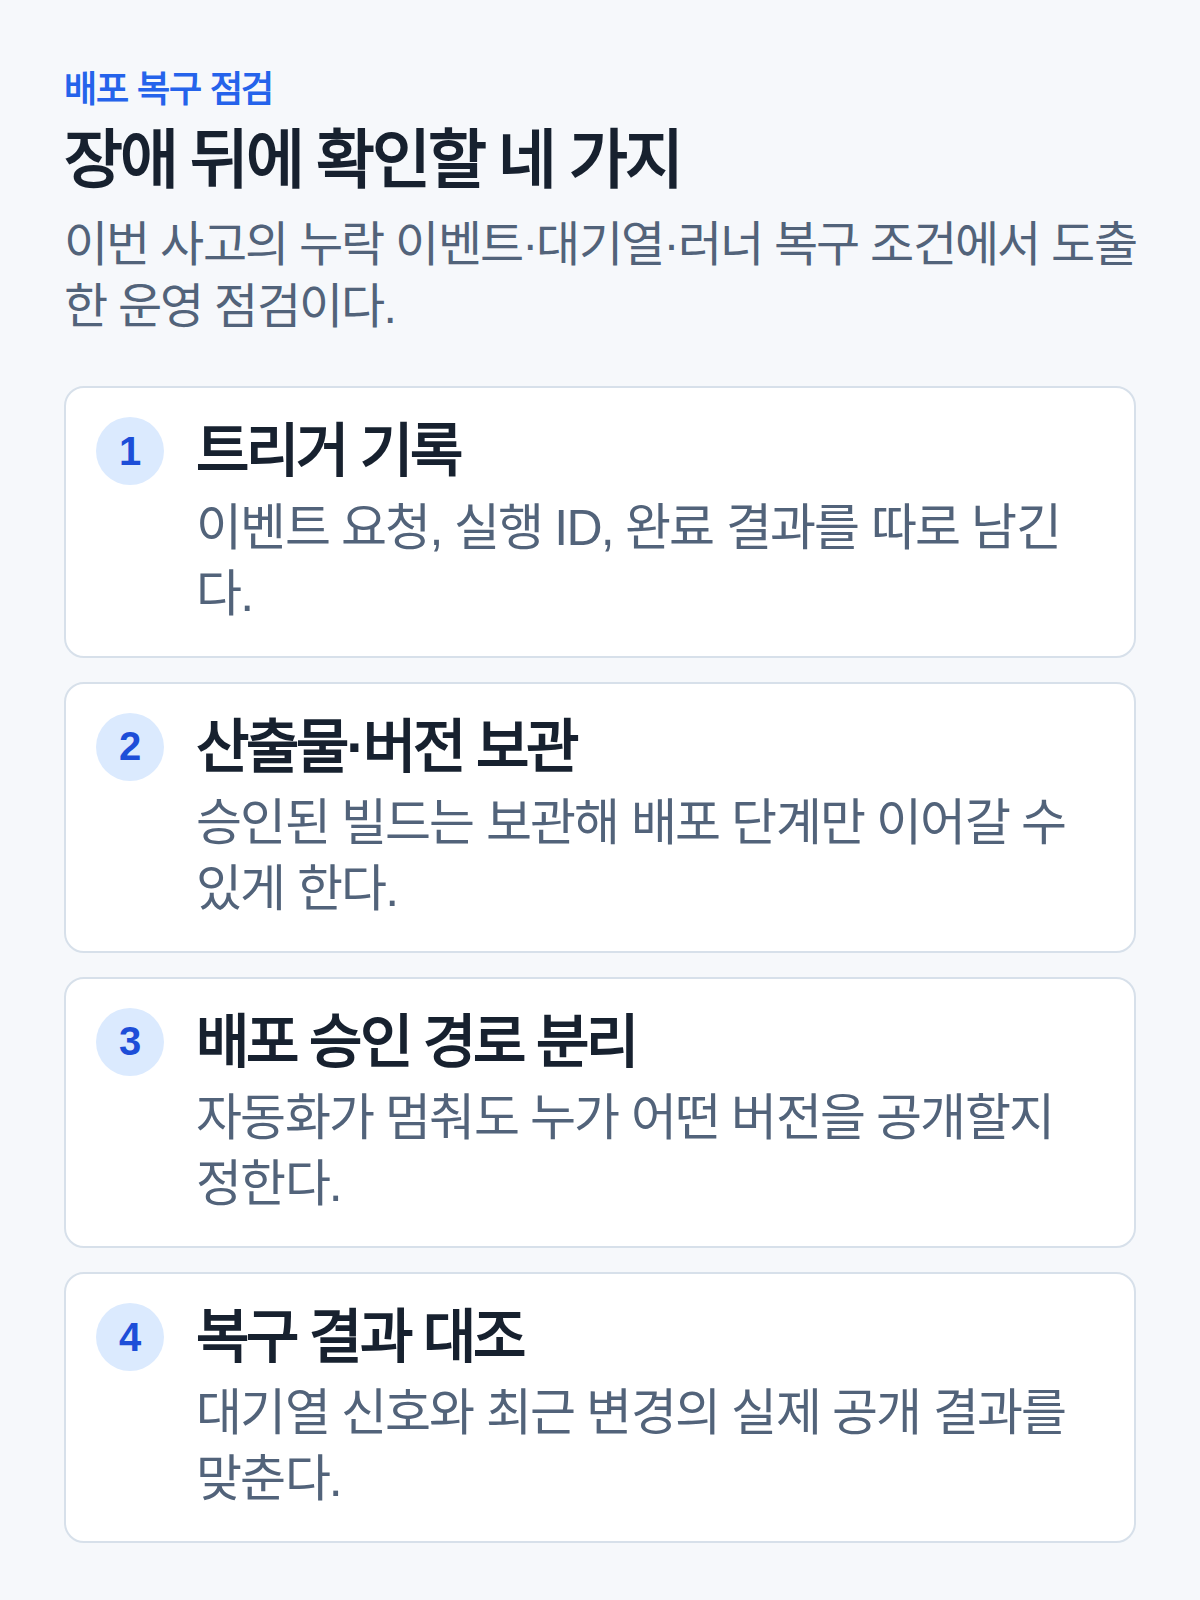
셋째, 정적 자산 전달 경로와 자동화 실행 경로를 구분할 필요가 있다. 이는 다른 CI 서비스를 하나 더 붙이라는 뜻이 아니다. 현재 배포 도구가 멈췄을 때 누가 어떤 버전의 산출물을 어떤 승인 기록으로 공개할지, 그리고 그 절차가 고객 데이터를 건드리지 않는지를 미리 정하는 일이다. 마지막으로 대기열이 비었다는 플랫폼 신호만으로 복구를 끝내지 말아야 한다. 최근 병합분, 예약 배포, 재시도된 작업, ARC 러너 상태를 배포 결과와 대조해야 자동 재생되지 않은 이벤트를 놓치지 않는다.
배포 파이프라인의 목표는 모든 구성 요소를 이중화하는 데 있지 않다. 한 의존성이 멈춘 사실을 다른 의존성 없이 발견하고, 검증된 산출물을 안전하게 다음 단계로 넘길 수 있게 만드는 데 있다. 이번 GitHub 장애는 실행 성공률이 99%로 돌아온 뒤에도 각 팀이 자기 변경분의 트리거와 공개 결과를 별도로 확인해야 했다는 점에서, 그 경계가 왜 필요한지 선명하게 보여 준다.
출처: GitHub Status, “Incident with Actions” (2026-08-06~07, UTC)