
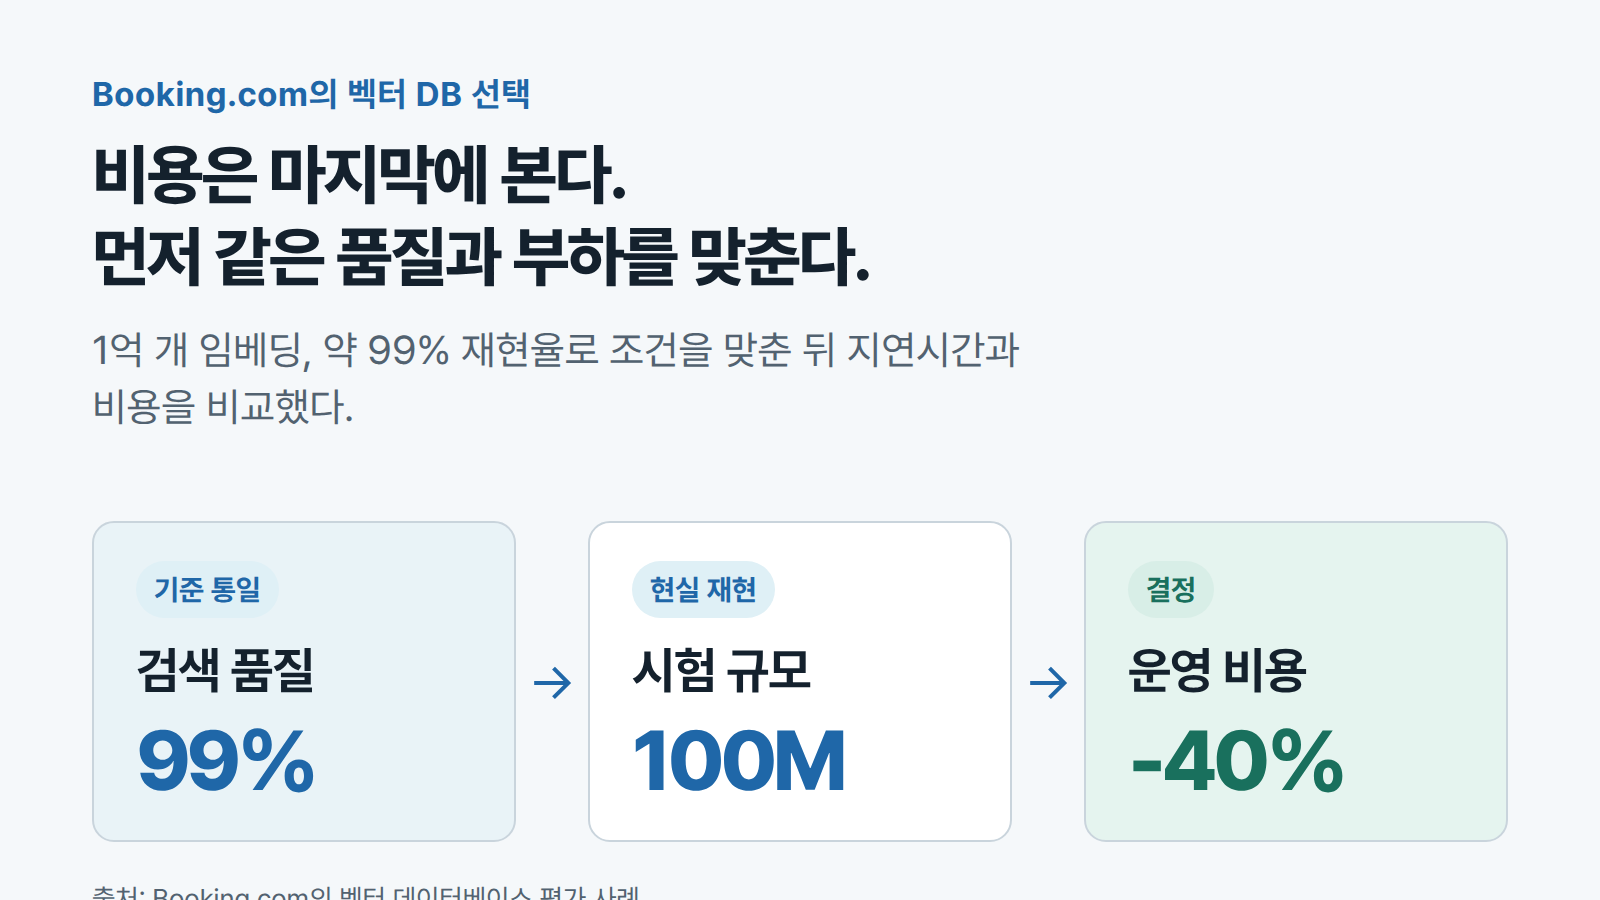
부킹닷컴은 임베딩 검색을 처음 실험용으로 붙였다가, 결국 결제 시스템급으로 다뤄야 하는 인프라로 재분류했다. 계기는 사용자 경험을 좌우하는 파트너 투숙객 메시징 에이전트처럼 벡터 검색에 직접 의존하는 서비스가 늘면서다. 그 뒤 클러스터 튜닝과 확장을 반복하던 기존 OpenSearch 기반 벡터 검색을 걷어내고, 1억 개 임베딩으로 직접 시험을 설계해 Weaviate로 옮겼다.
이 결정에서 눈여겨볼 지점은 최종 선택 자체가 아니라 비교의 순서다. 검색 품질을 먼저 같은 선에 맞추고, 그 다음에야 지연시간과 비용을 비교했다. 순서를 바꾸면 낮은 비용이 낮은 정확도의 결과인지 실제 효율의 결과인지 구분할 수 없기 때문이다.

벡터 검색이 배경 기능에서 핵심 인프라로 바뀐 이유
부킹닷컴의 임베딩·벡터 검색은 소수의 실험에서 시작해 유사도 검색, 의미 기반 필터링, 검색 증강 생성(RAG)을 지원하는 공용 인프라로 커졌다. 검색 가능한 도메인 데이터가 넓어질수록 정확하고 개인화된 응답에 필요한 문맥을 더 많이 확보할 수 있다는 게 이 인프라의 실제 가치다. 그리고 파트너와 투숙객 사이의 메시지 응답을 돕는 에이전트처럼, 벡터 검색이 사용자가 보는 결과를 직접 만드는 서비스가 늘었다. 이 지점부터 벡터 데이터베이스는 기본 데이터 저장소나 메시지 큐와 같은 수준의 예측 가능성과 확장성이 필요한 인프라가 됐다.
OpenSearch로 시작해서 공개 벤치마크를 믿지 않게 된 과정
초기 내부 Embedding Service의 백엔드로 OpenSearch를 고른 이유는 단순했다. 사내에 이미 있었고, AWS에서 바로 쓸 수 있었고, 기존 Terraform 설정으로 손쉽게 프로비저닝됐다. 새 기술 도입과 운영 부담 없이 초기 활용 사례를 빠르게 검증하는 데는 이 선택이 맞았다.
문제는 사용량이 늘면서 생겼다. 데이터셋이 수억 개 임베딩으로 커지고, 벡터 검색과 메타데이터 필터링을 함께 쓰는 질의가 늘고, 동시 요청과 지연시간 요구가 동시에 엄격해졌다. 허용 가능한 성능을 유지하려면 계속 튜닝하고 클러스터를 키워야 했다. 시스템이 아예 고장 난 건 아니었지만, 운영과 기능 확장은 점점 느려졌고 팀은 새 활용 사례를 만드는 일보다 AWS OpenSearch 인프라를 관리하는 데 더 많은 시간을 쓰게 됐다.
이 시점에서 팀은 공개 벤치마크와 비교 글을 신뢰하지 않기로 했다. 대부분 데이터셋이 작고, 워크로드가 합성이고, 동시성이 낮아 실제 환경을 반영하지 못한다고 판단했기 때문이다. 부킹닷컴 환경은 대규모 임베딩, 검색과 필터링의 결합, 높은 동시성이 함께 나타나는데, 이 조건에서는 지연시간이나 효율의 작은 차이도 사용자 경험과 비용에 곧바로 영향을 준다.
1억 개 임베딩으로 자체 시험을 설계한 방법
시험용 데이터셋은 Amazon Reviews 2023의 Electronics, Baby Products, Home & Kitchen 등 여러 범주 레코드로 구성한 1억 개 임베딩이다. 텍스트를 벡터로 바꾸는 데는 all-MiniLM-L6-v2를 썼는데, 이미 사내 모델 카탈로그에 등록돼 있어 기존 프로덕션 워크로드를 대표할 수 있었고 임베딩 품질과 추론 속도의 균형도 괜찮았다. 각 레코드에는 평점과 사용자 정의 태그 같은 메타데이터도 넣어서, 벡터 유사도와 복잡한 필터를 함께 처리하는 성능까지 시험 범위에 넣었다.
시험 워크로드는 세 가지였다. 첫째는 1억 개 전체에서 근사 최근접 이웃(a-KNN)을 찾는 전체 검색이다. 둘째는 벡터 유사도에 평점 범위, 범주, 카디널리티가 높은 태그 조건을 결합한 필터 검색으로, 실제 서비스에서 검색이 제한 없이 이뤄지는 경우가 드물다는 점을 반영했다. 셋째는 전체 작업의 약 20%를 연속 수집 스트림으로 채운 읽기·쓰기 혼합 워크로드로, 색인이 진행되는 동안 질의 지연시간이 어떻게 달라지는지 봤다.
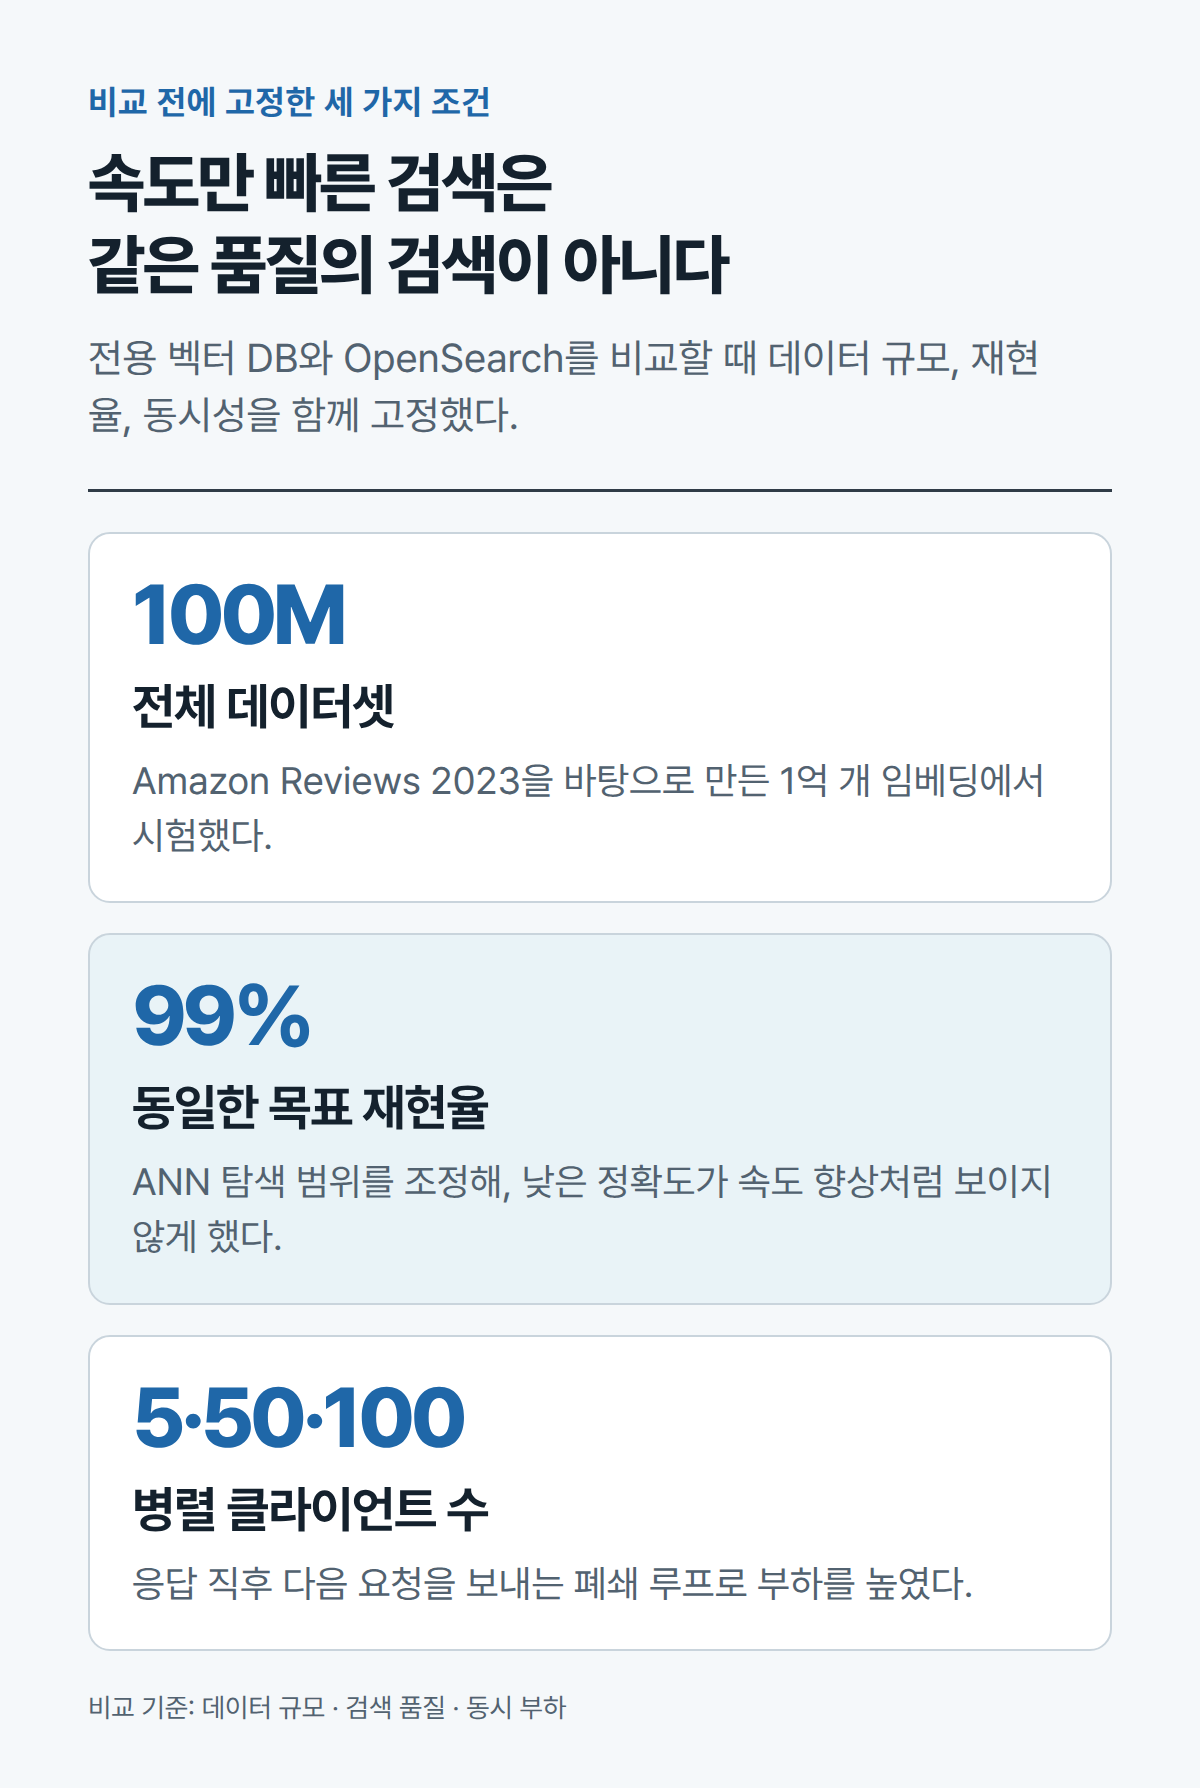
부하는 병렬 클라이언트를 5개에서 50개, 100개로 늘리며 확대했다. 각 클라이언트가 응답을 받은 직후 다음 요청을 보내는 폐쇄 루프 방식이라 처리량과 초당 요청 수가 동시성을 따라 자연스럽게 올라간다. 모든 시험을 1억 개 벡터 전체에서 돌린 것도 소규모 데이터에서 나타나는 편향을 피하려는 선택이었다.
속도를 재기 전에 검색 품질을 먼저 통일한 이유
비교에서 가장 신경 쓴 부분은 따로 있다. 어떤 시스템이 더 빠르게 응답하더라도, 그게 더 적은 후보만 살펴봐서 생긴 결과라면 공정한 비교가 아니다. 그래서 색인에 이미 있는 약 200만 개 벡터를 무작위로 뽑아 각각을 질의로 사용하고, 그 벡터가 자신이 속한 상위 k개 이웃 안에 실제로 나오는지로 Recall@k를 계산했다. 그리고 검색 범위 같은 ANN 매개변수를 조정해 모든 시스템을 약 99%라는 같은 목표 재현율에 맞췄다.
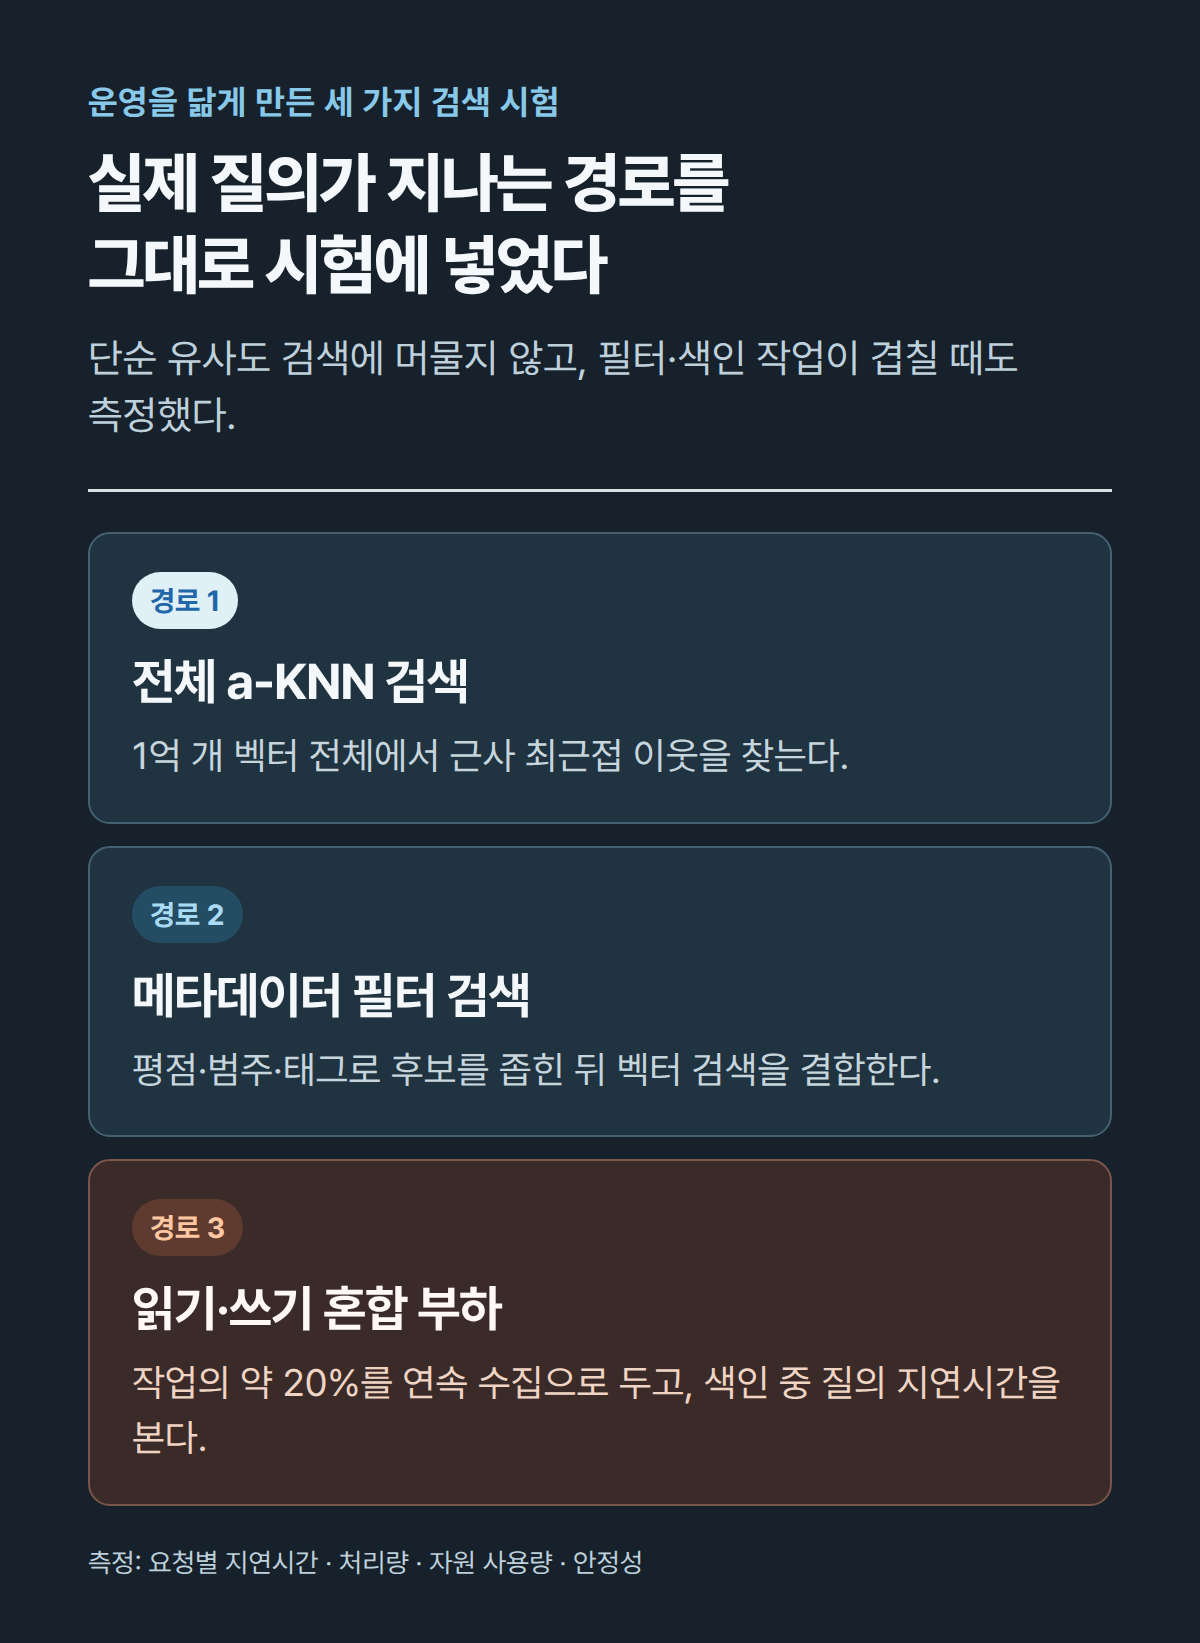
이 작업 덕분에 이후 비교한 지연시간, 처리량, 자원 사용량 차이는 검색 품질을 낮춰서 얻은 결과가 아니라 시스템 자체의 효율 차이로 해석할 수 있게 됐다. 측정 항목은 요청별 지연시간, 전체 처리량, 자원 사용량, 안정성이었고, 그중에서도 평균이 아니라 P99 꼬리 지연시간에 가장 무게를 뒀다. 사용자가 실제로 느끼는 건 평균이 아니라 가장 느린 요청이기 때문이다.
40%라는 비용 절감이 어디서 나왔나
같은 재현율과 SLO 기준에서, 전용 벡터 데이터베이스는 OpenSearch보다 낮은 P99 지연시간, 높은 동시성에서의 더 나은 처리량, 더 적은 자원으로도 예측 가능한 확장 특성을 보였다. 이 효율 차이가 그대로 비용으로 이어져, 컴퓨팅과 메모리 사용량 기준으로 OpenSearch 대비 약 40%의 비용 절감이 나왔다. 벡터 기능을 얹은 범용 검색 엔진과 처음부터 벡터 검색만을 위해 만든 시스템은 이 규모에서 성능 특성 자체가 다르다는 뜻이다.
평가한 여러 전용 후보 가운데 시나리오 전반에서 가장 일관된 성능을 보인 쪽은 Weaviate였고, 결과는 이 제품과 기존 OpenSearch 기준선만 공개됐다. 다른 후보를 비교에는 넣었지만 결과를 외부에 전부 공개하지는 않은 셈이다.
마이그레이션이 큰 사고 없이 끝난 이유
기술적 우위만큼 중요했던 건 미리 해둔 설계 결정이다. 모든 데이터베이스 접근이 내부 Embedding Service 뒤로 추상화돼 있어서, 클라이언트는 원래부터 저장 계층과 직접 통신하지 않았다. 이 구조 덕분에 여러 데이터베이스를 병렬로 띄워두고 백엔드를 클라이언트에 드러내지 않은 채 바꿀 수 있었고, 대부분의 팀은 설정값 하나만 바꾸면 마이그레이션이 끝났다.
같은 상황에 적용할 판단 순서
클러스터를 늘리는 결정을 반복하고 있다면, 다음 순서를 벡터 데이터베이스 자체보다 먼저 점검할 만하다. 첫째, 튜닝과 증설이 되풀이되는 신호가 실제로 있는지 본다. 둘째, 공개 벤치마크가 아니라 자기 데이터 규모와 질의 패턴으로 후보를 시험한다. 셋째, 재현율이나 SLO 같은 품질 기준을 먼저 고정해서 비용 비교가 품질 저하로 왜곡되지 않게 한다. 넷째, 저장 계층이 서비스 뒤에 추상화돼 있는지 확인한다. 이 마지막 조건이 없으면 아무리 좋은 벡터 데이터베이스를 골라도 전환 자체의 비용이 커진다.
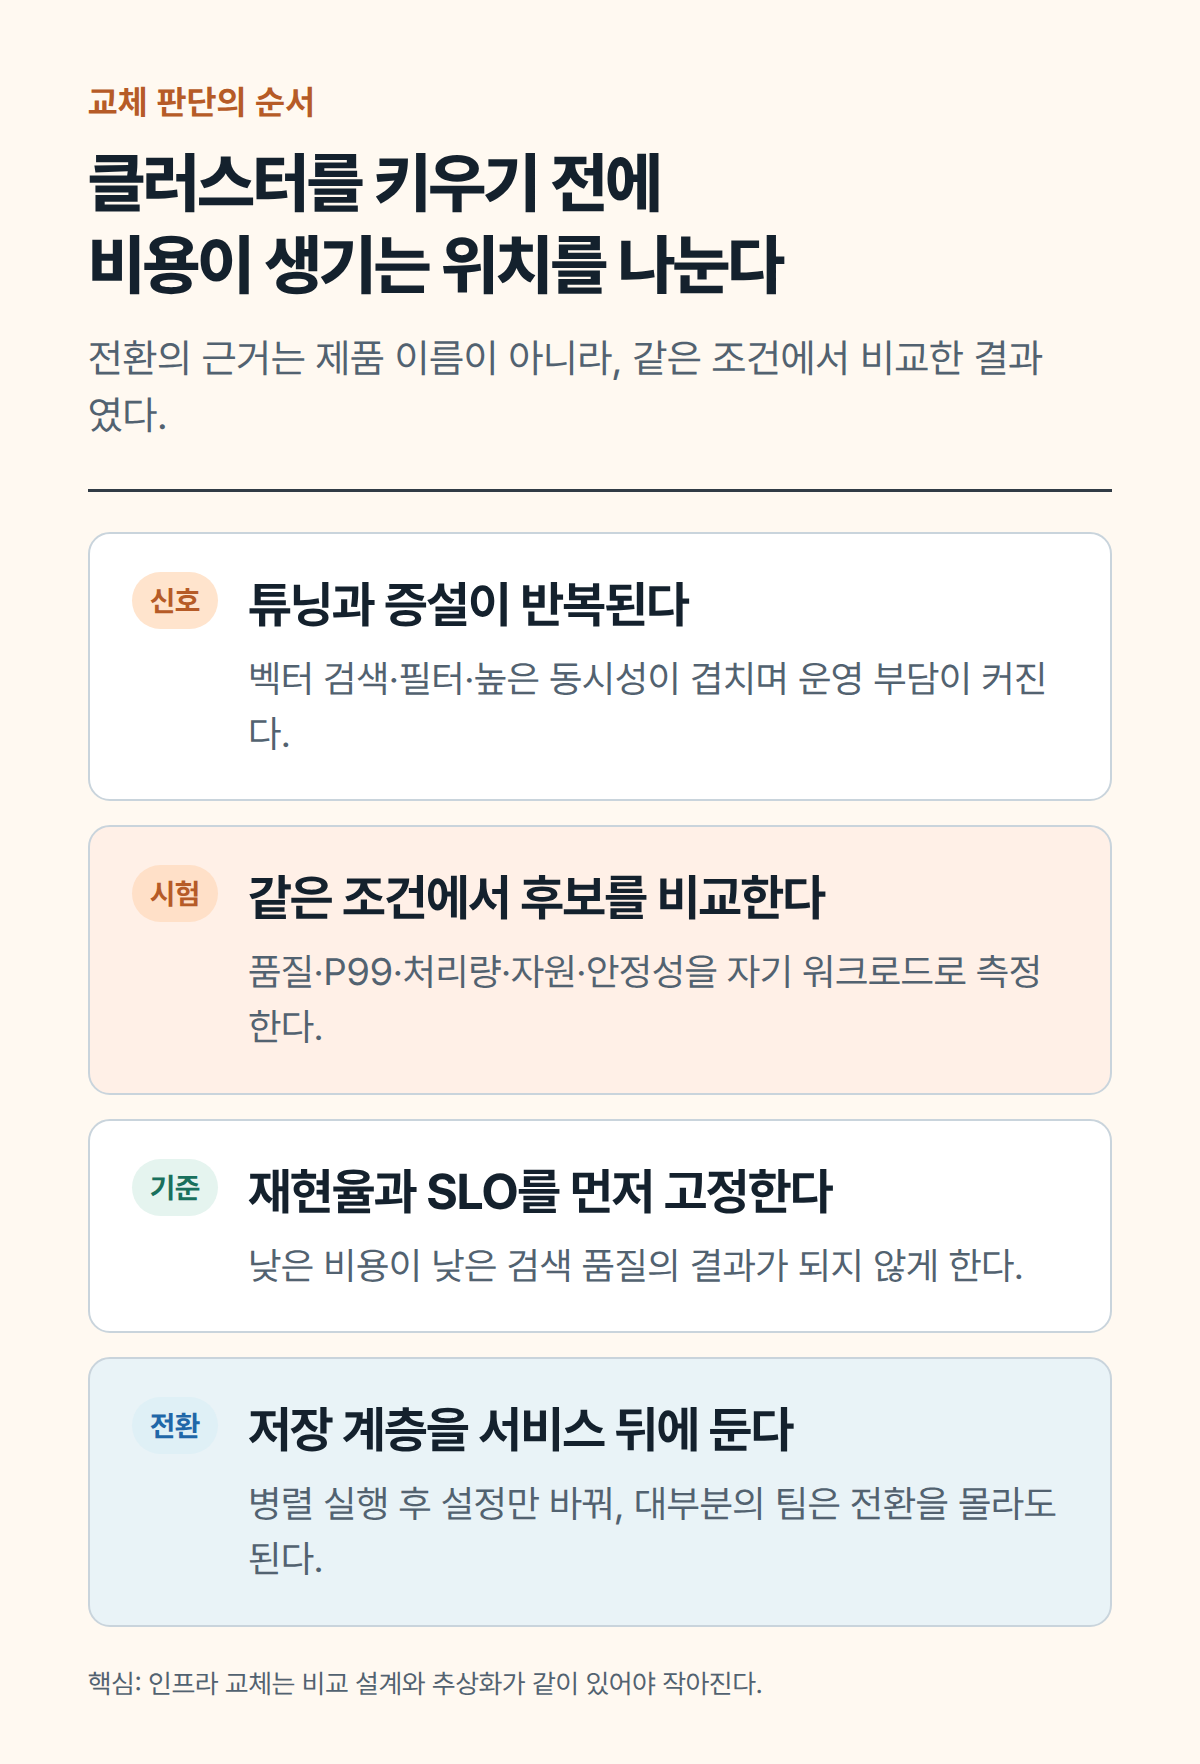
부킹닷컴 사례에서 남는 결론은 특정 제품 이름이 아니라 이 순서다. 자기 워크로드로 직접 시험하고, 저장 계층을 추상화해 두면 다음 교체는 더 작아진다.