
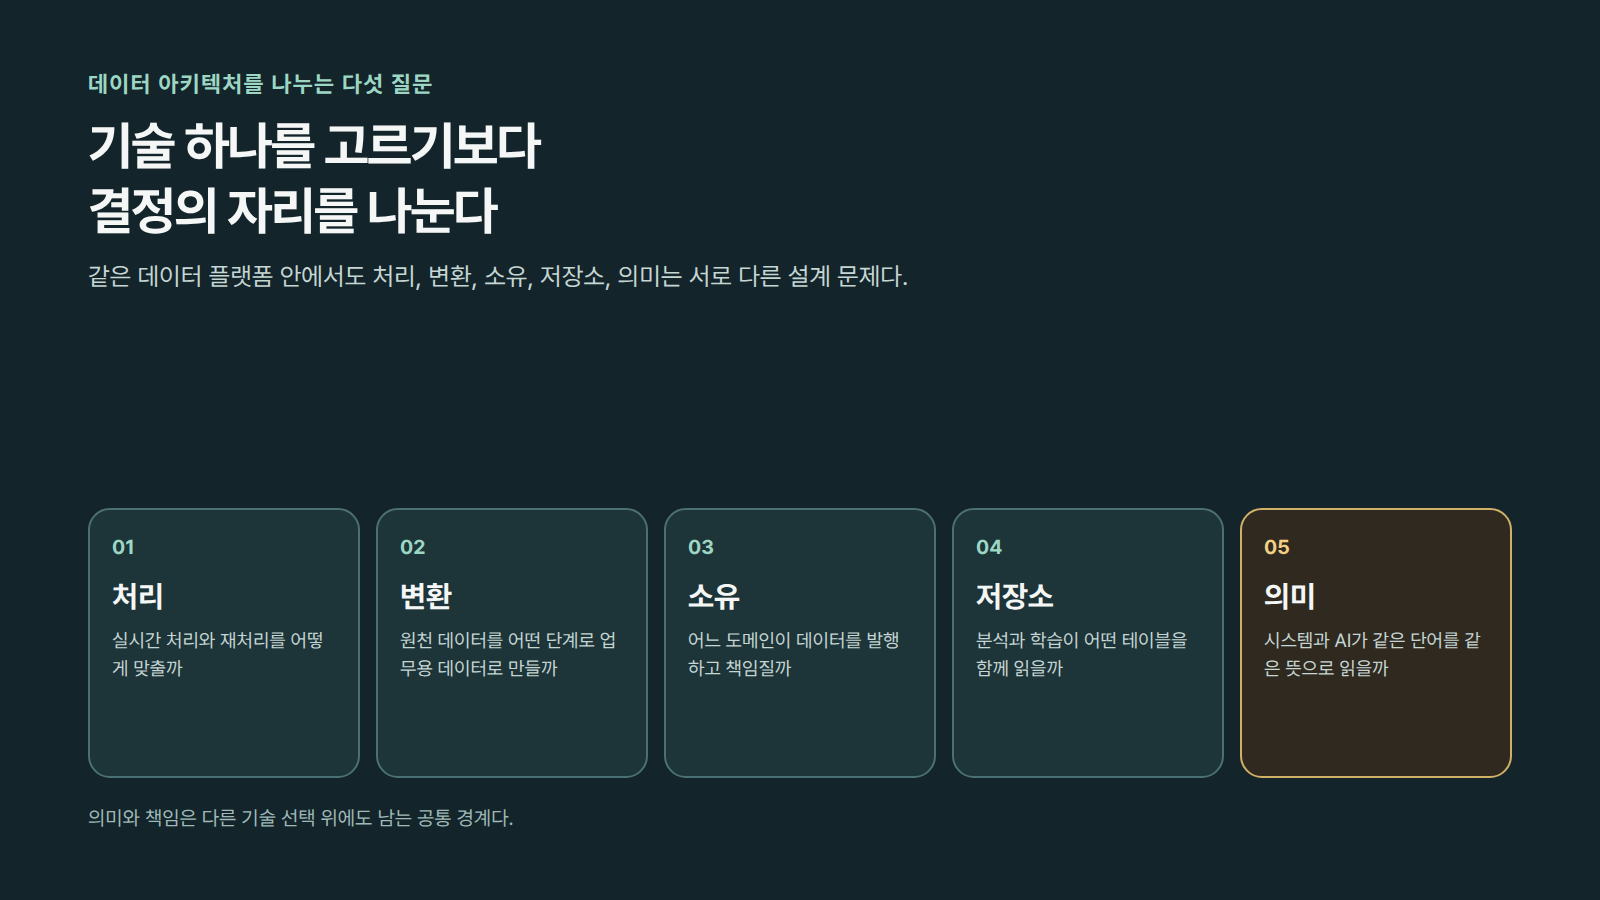
AI를 데이터 위에 얹는다고 해서 데이터팀의 일이 모델 선택으로 바뀌는 것은 아니다. 2026년 8월 19일 공개된 데이터 아키텍처 패턴 해설은 AI 애플리케이션, 에이전트, RAG, 시맨틱 검색이 대시보드나 야간 배치와 다른 방식으로 데이터를 소비한다고 짚는다. 사람 분석가라면 낯선 값에서 멈춰 질문할 수 있지만, 에이전트는 받은 정의와 계약 안에서 다음 도구 호출이나 답변을 이어 간다.
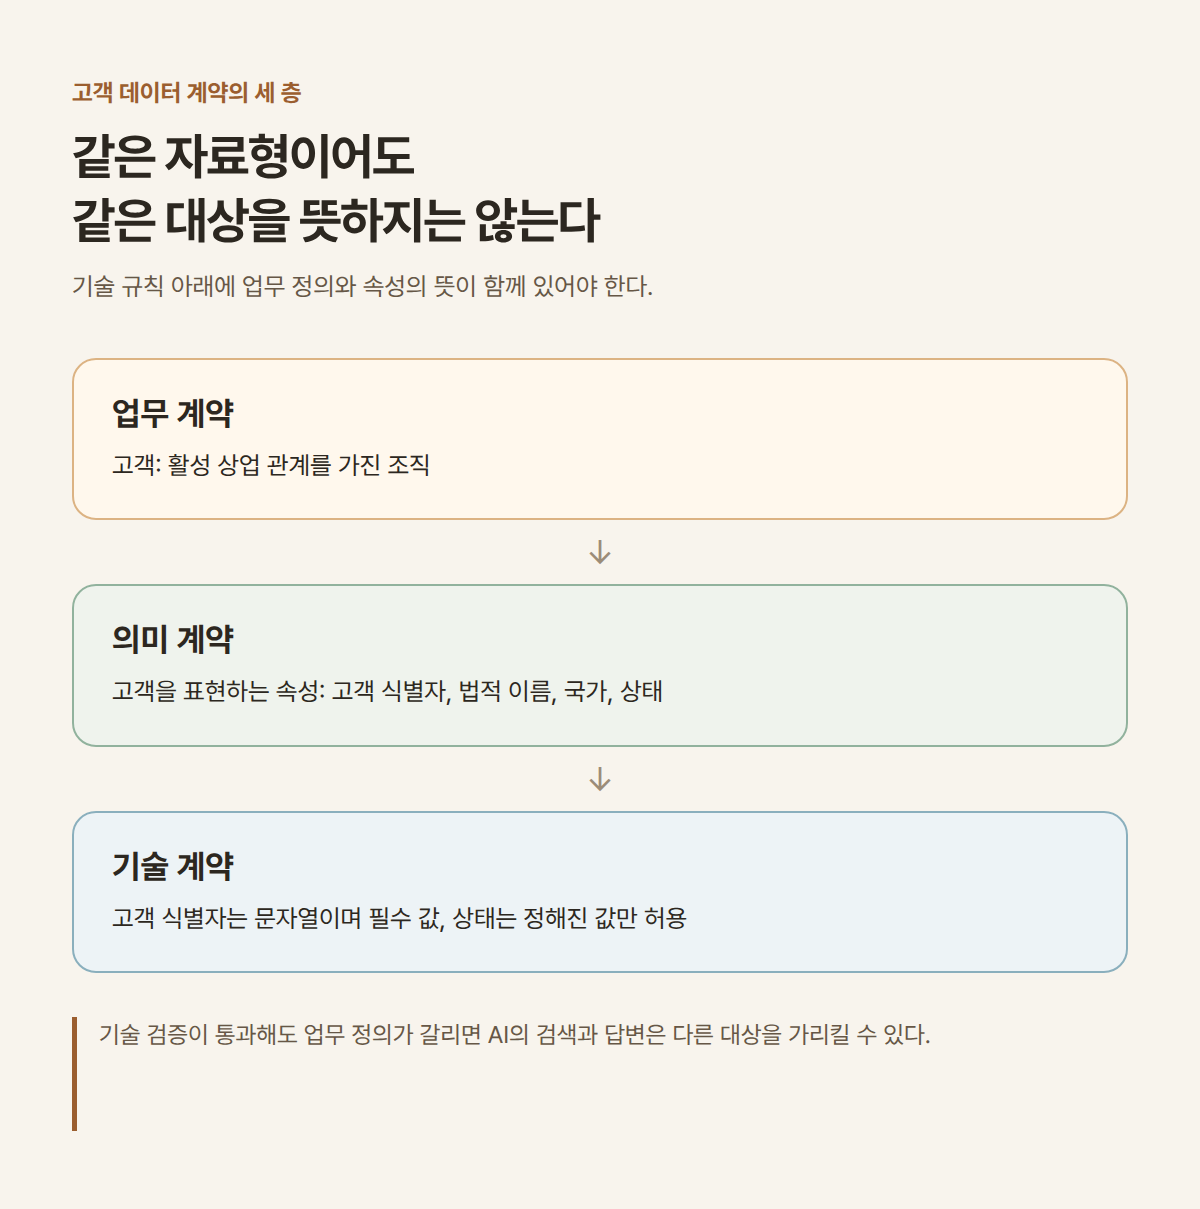
그래서 먼저 정할 것은 저장소나 파이프라인 이름이 아니라 데이터가 가리키는 대상과 그 정의를 바꿀 권한이다. 예를 들어 두 시스템이 customerId를 문자열로 저장해도 한쪽은 활성 계약 고객, 다른 쪽은 마케팅 수신 동의자를 고객으로 부르면 조인과 검색은 성공해도 질문의 답은 어긋날 수 있다.

여섯 패턴은 왜 같은 후보 목록이 아닌가
원문은 Lambda와 Kappa를 처리 방식, Medallion을 변환 단계, Data Mesh를 소유권, Data Lakehouse를 저장소와 플랫폼, 시맨틱 아키텍처를 의미의 문제로 구분한다. 이들은 서로 같은 자리를 두고 경쟁하지 않는다. 한 조직은 도메인별 소유권에는 Data Mesh를, 공용 테이블에는 Lakehouse를, 원천 데이터 정리에는 Medallion을 함께 쓸 수 있다.
이 구분은 데이터팀의 논의를 짧게 만든다. 실시간성과 재처리가 문제라면 이벤트와 처리 경로를 본다. 원천부터 업무용 테이블까지의 품질과 추적성이 문제라면 변환 단계를 본다. 다른 팀이 데이터를 내놓고 바꾸는 과정에서 충돌한다면 소유자와 계약을 먼저 본다. AI 도입에서 마지막 질문은 특히 중요하다. 에이전트가 테이블을 읽을 수 있느냐보다 그 테이블의 ‘고객’, ‘매출’, ‘활성’이 무엇을 뜻하는지 일관되게 해석할 수 있느냐가 결과를 좌우한다.
스키마만 맞아도 답이 틀릴 수 있는 이유는 무엇인가
원문은 계약을 세 겹으로 설명한다. 업무 계약은 고객의 범위를 문장으로 정한다. 의미 계약은 customerId, 법적 이름, 국가, 상태처럼 그 대상을 표현할 속성을 정한다. 기술 계약은 자료형과 필수 여부처럼 시스템이 검사할 규칙을 정한다. JSON Schema가 통과했다는 사실은 마지막 층이 맞았다는 뜻일 뿐, 앞의 두 층까지 합의됐다는 보장은 아니다.
이 세 층을 한 문서에 길게 몰아넣을 필요는 없다. 데이터 제품이나 API마다 짧은 정의, 표준 속성, 검증 규칙을 함께 두고 카탈로그와 계약에서 참조하면 된다. 중요한 점은 정의가 위키의 설명으로 끝나지 않는 데 있다. 새 필드가 추가되거나 상태값의 의미가 바뀔 때, 소비 시스템과 에이전트가 무엇을 다시 읽고 어떤 버전을 써야 하는지까지 계약에 들어가야 한다.
책임은 데이터 소유자 이름만 적는 것으로 끝나지 않는다
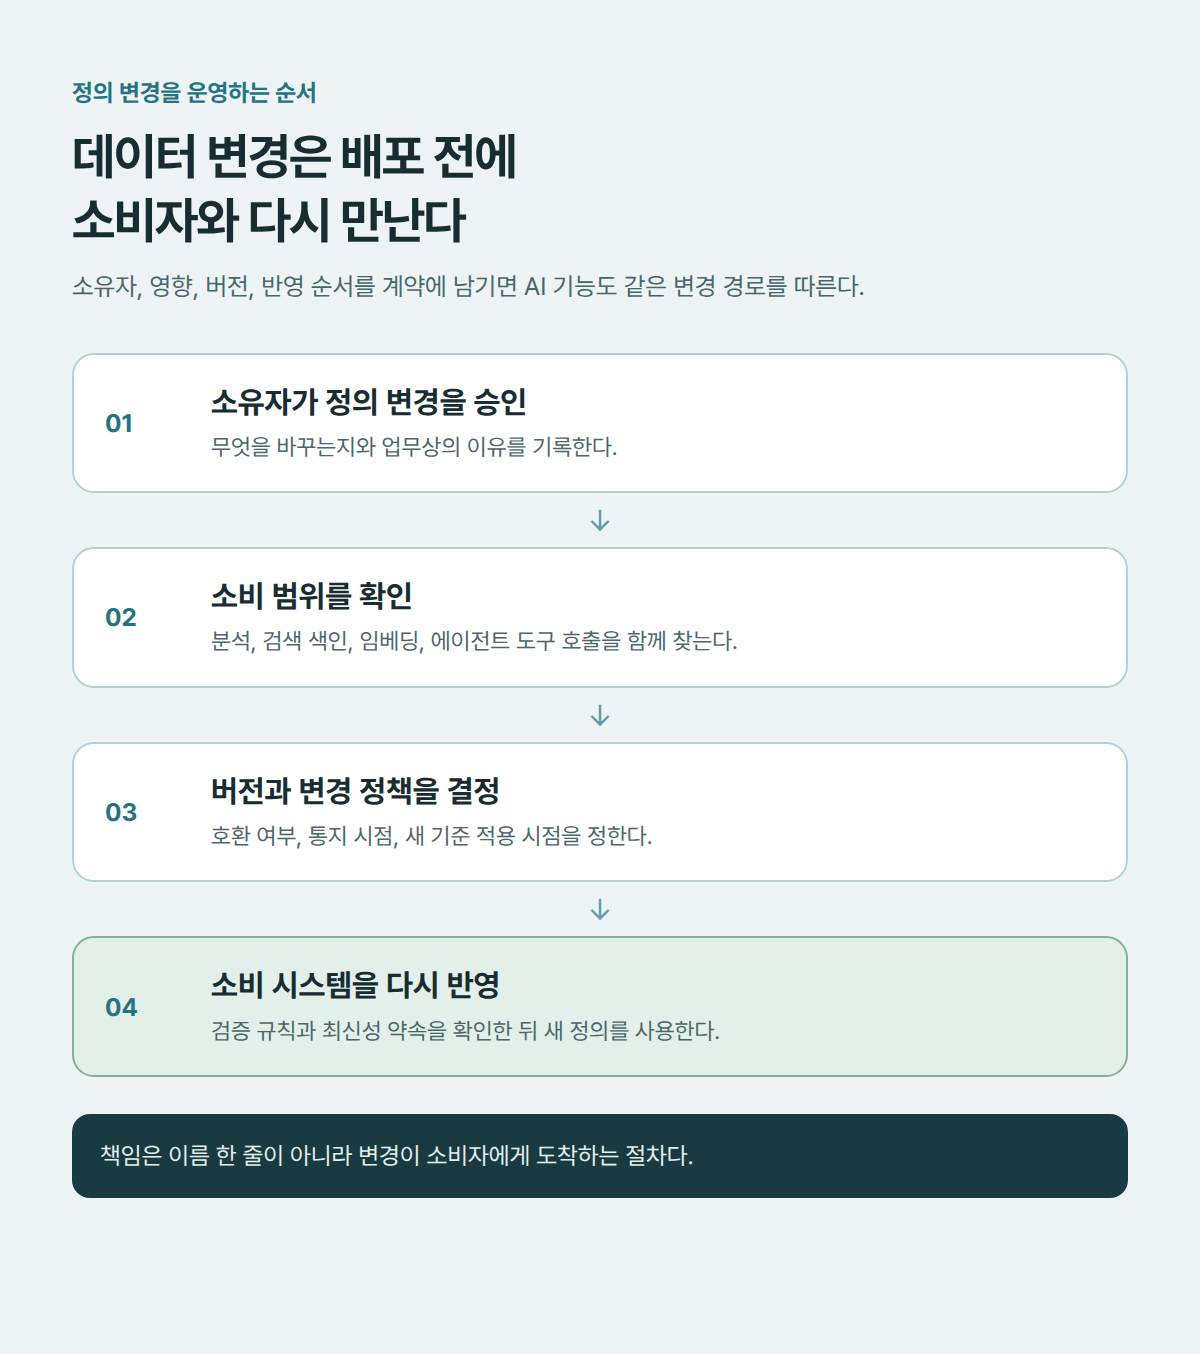
Data Mesh에서 도메인은 데이터를 제품처럼 발행한다. 원문이 든 계약 항목은 소유자, 스키마, 최신성 SLA, 품질 규칙, 버전과 변경 정책이다. 여기서 책임은 장애가 났을 때 호출할 사람의 이름만 뜻하지 않는다. 누가 정의를 승인하는지, 어떤 변경이 호환성을 깨는지, 소비자가 얼마나 전에 통지받는지, 약속한 최신성이 지켜지지 않을 때 무엇을 멈출지를 미리 정하는 일이다.
AI 기능을 붙이는 팀이라면 이 계약에 소비 방식도 보태는 편이 낫다. 검색 색인이나 임베딩을 다시 만들어야 하는 변경인지, 이전 정의로 생성한 답변이나 추천을 폐기해야 하는지, 사람 검토가 필요한 도구 호출인지가 그 예다. 이 항목은 모델 프롬프트에 흩어놓기보다 데이터 변경 절차에 붙어 있어야 새 모델이나 새 에이전트가 들어와도 같은 경계를 따른다.
데이터팀은 어디서 시작하면 좋은가
새 아키텍처를 한 번에 교체할 필요는 없다. 에이전트가 이미 읽는 데이터 제품 하나를 고르고, 그 안의 핵심 명사 하나부터 합의하면 된다. ‘고객’처럼 여러 도메인에 걸친 단어라면 업무 정의, 표준 속성, 품질 기준, 소유자, 변경 통지를 한 묶음으로 만든다. 그다음 해당 데이터를 쓰는 검색, 분석, 자동화가 그 묶음을 실제로 참조하는지 점검한다.
저장소와 처리 기술은 계속 바뀐다. 반면 데이터가 무엇을 뜻하고 누가 그 뜻을 바꿀 수 있는지는 시스템 경계를 넘는다. AI 시대의 데이터 아키텍처는 더 많은 데이터를 빨리 옮기는 설계에서 끝나지 않는다. 기계가 읽을 수 있는 의미와 변경 책임을 데이터 제품의 일부로 만드는 데서 출발한다.
출처: The Golden Hour, “Data Architecture Patterns: Decisions for the AI Era” (2026-08-19)