
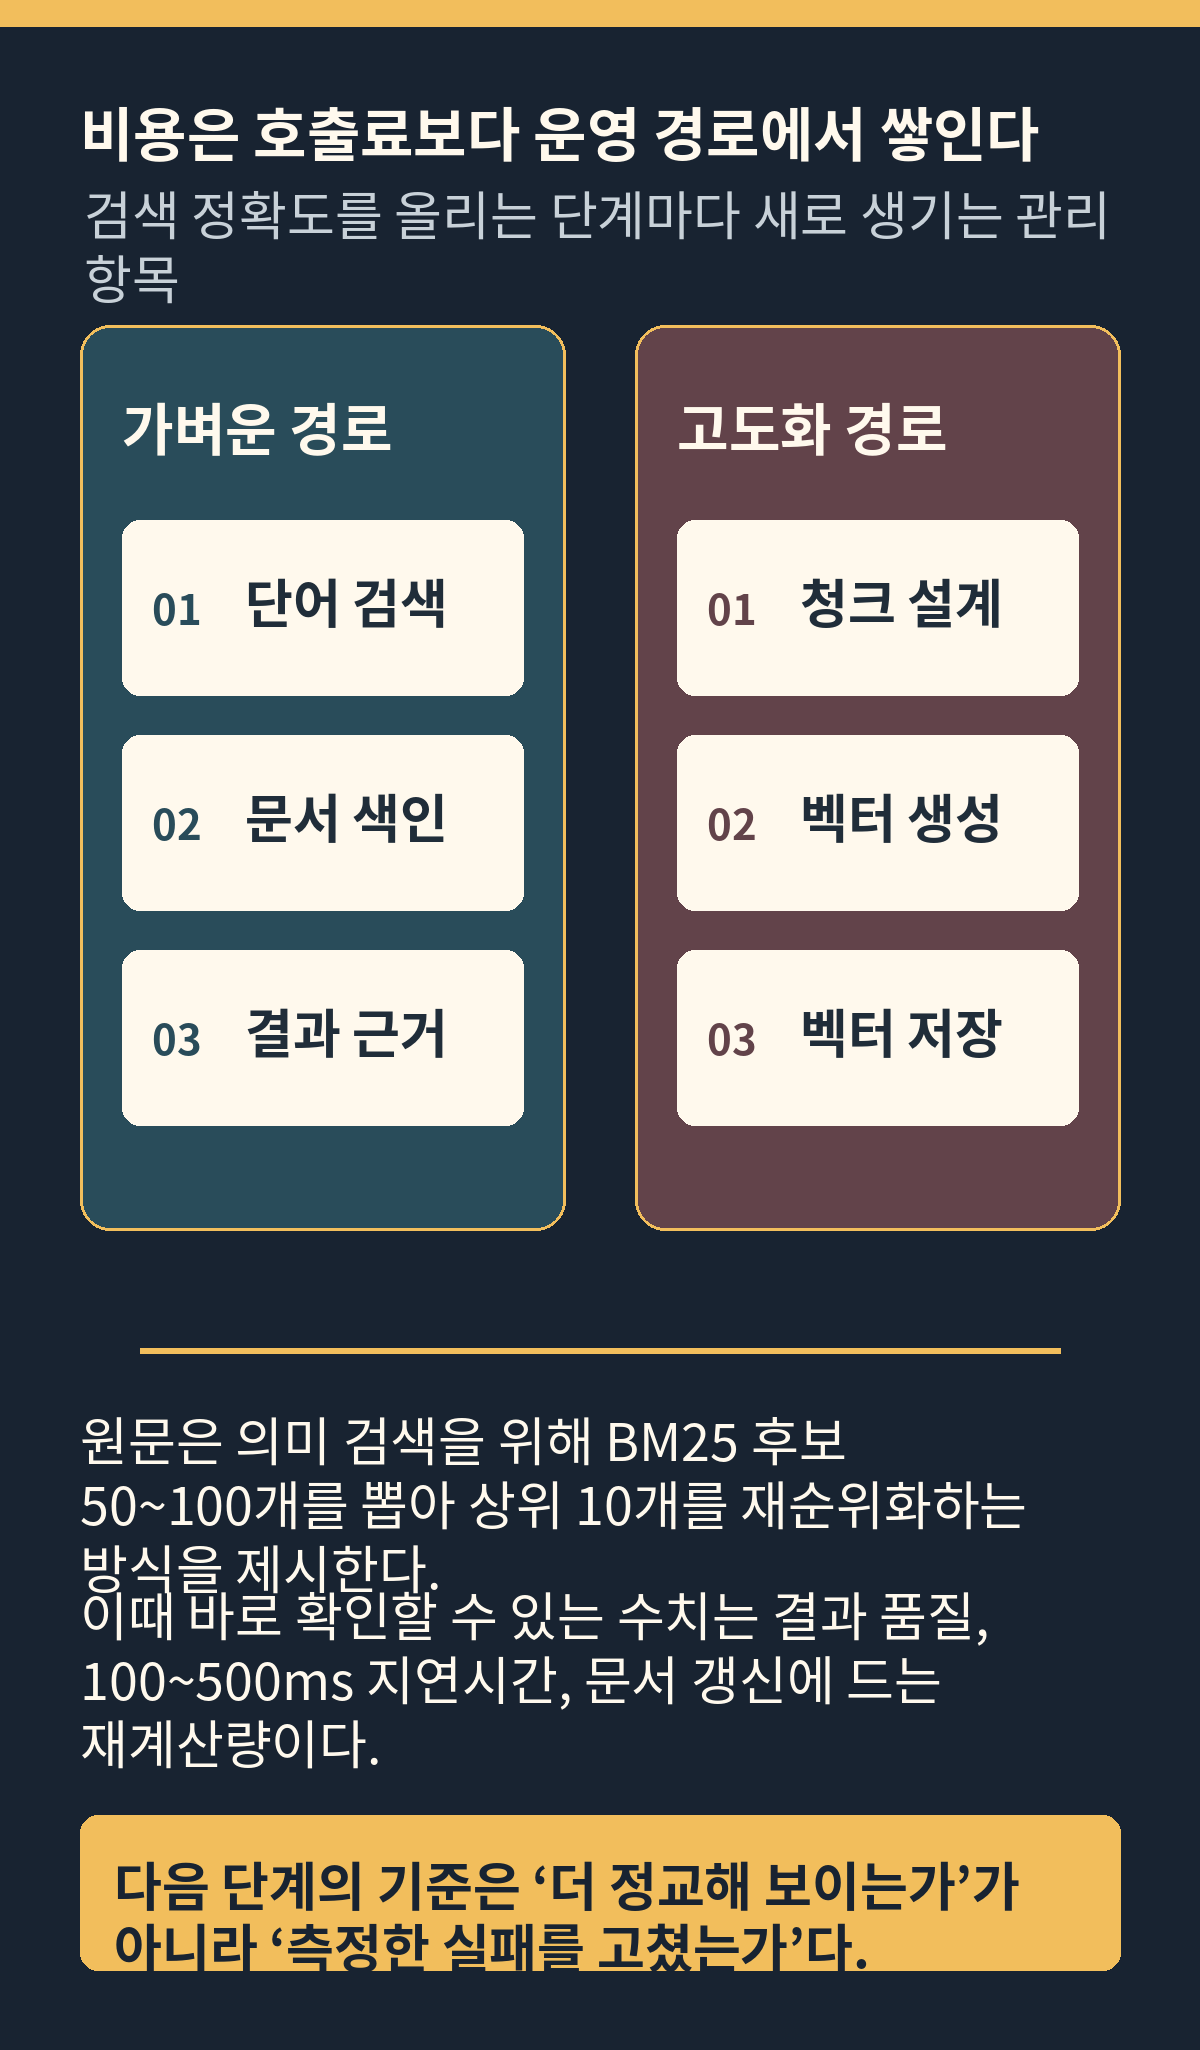
RAG는 모델이 답을 만들기 전에 관련 문서를 찾아오는 구조다. 검색 품질이 기대에 못 미치면 많은 팀이 임베딩, 벡터 데이터베이스, 재순위화 모델을 한꺼번에 붙인다. 하지만 RAG의 월 비용은 임베딩 API 호출료만으로 정해지지 않는다. 문서를 어디서 자를지, 갱신된 문서를 언제 다시 계산할지, 검색 결과가 나빠진 원인을 어떻게 추적할지까지 운영 항목이 늘어난다.
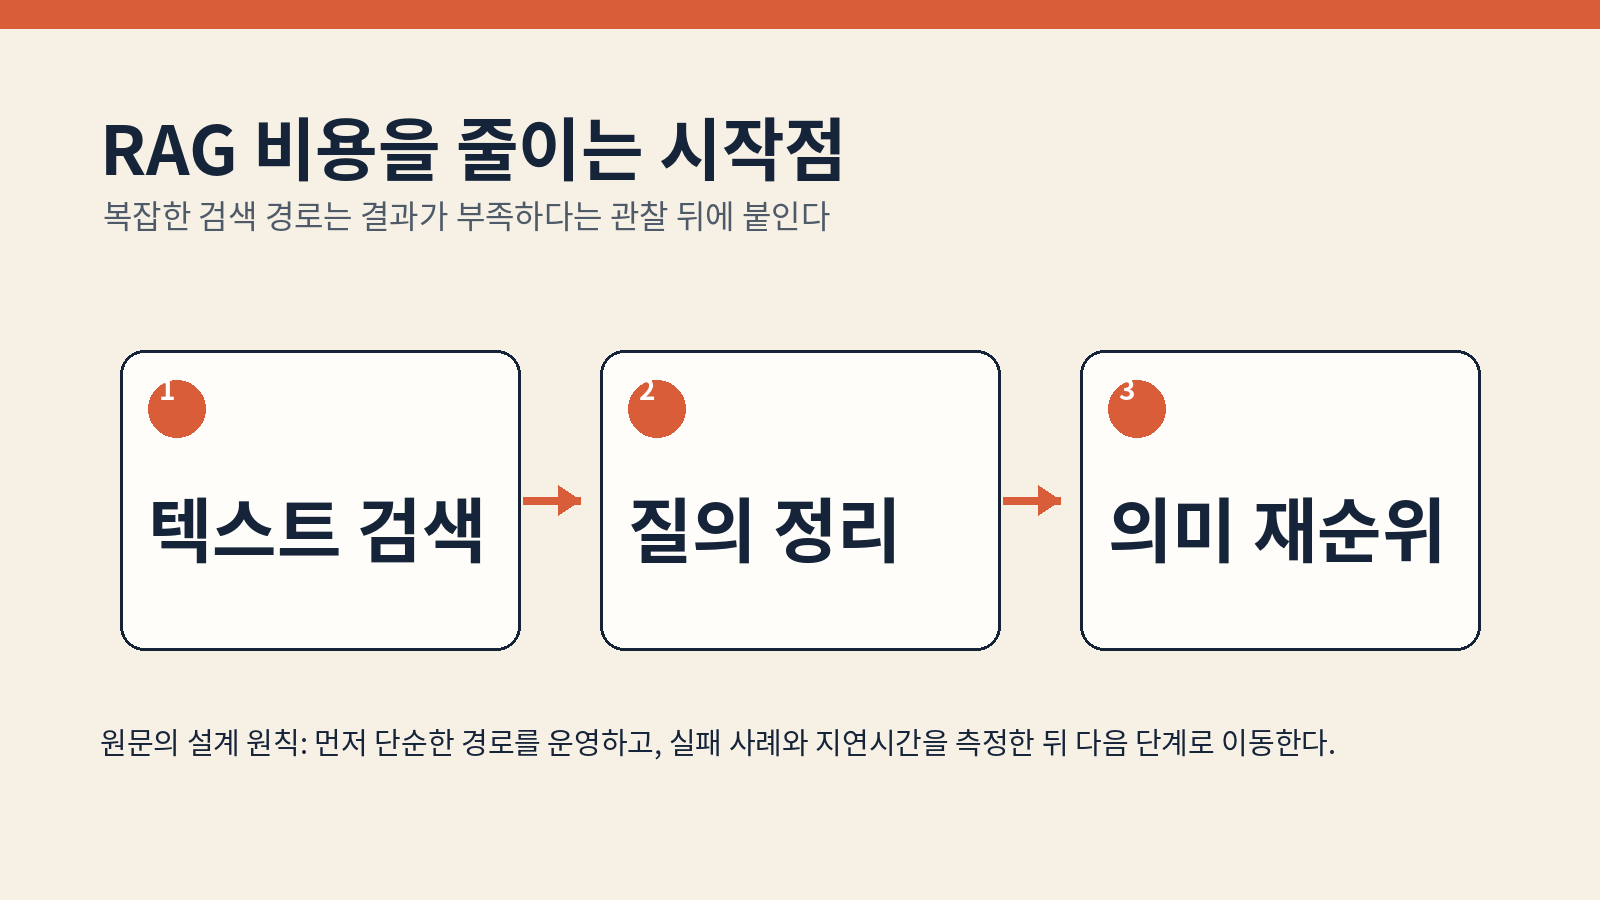
Lighthouse AI의 Rafael Pierre는 2026년 6월 글에서 여섯 가지 검색 구조를 단순한 쪽부터 제시했다. 출발점은 BM25 같은 전체 텍스트 검색이고, 사용자가 실제로 못 찾는 문서와 질의 패턴을 본 뒤에만 다음 단계를 더한다. 비용을 줄이는 방법은 값싼 모델을 고르는 일보다, 아직 필요하지 않은 경로를 시스템에 넣지 않는 데 가깝다.

비용부터 줄이려면 무엇을 재야 하나
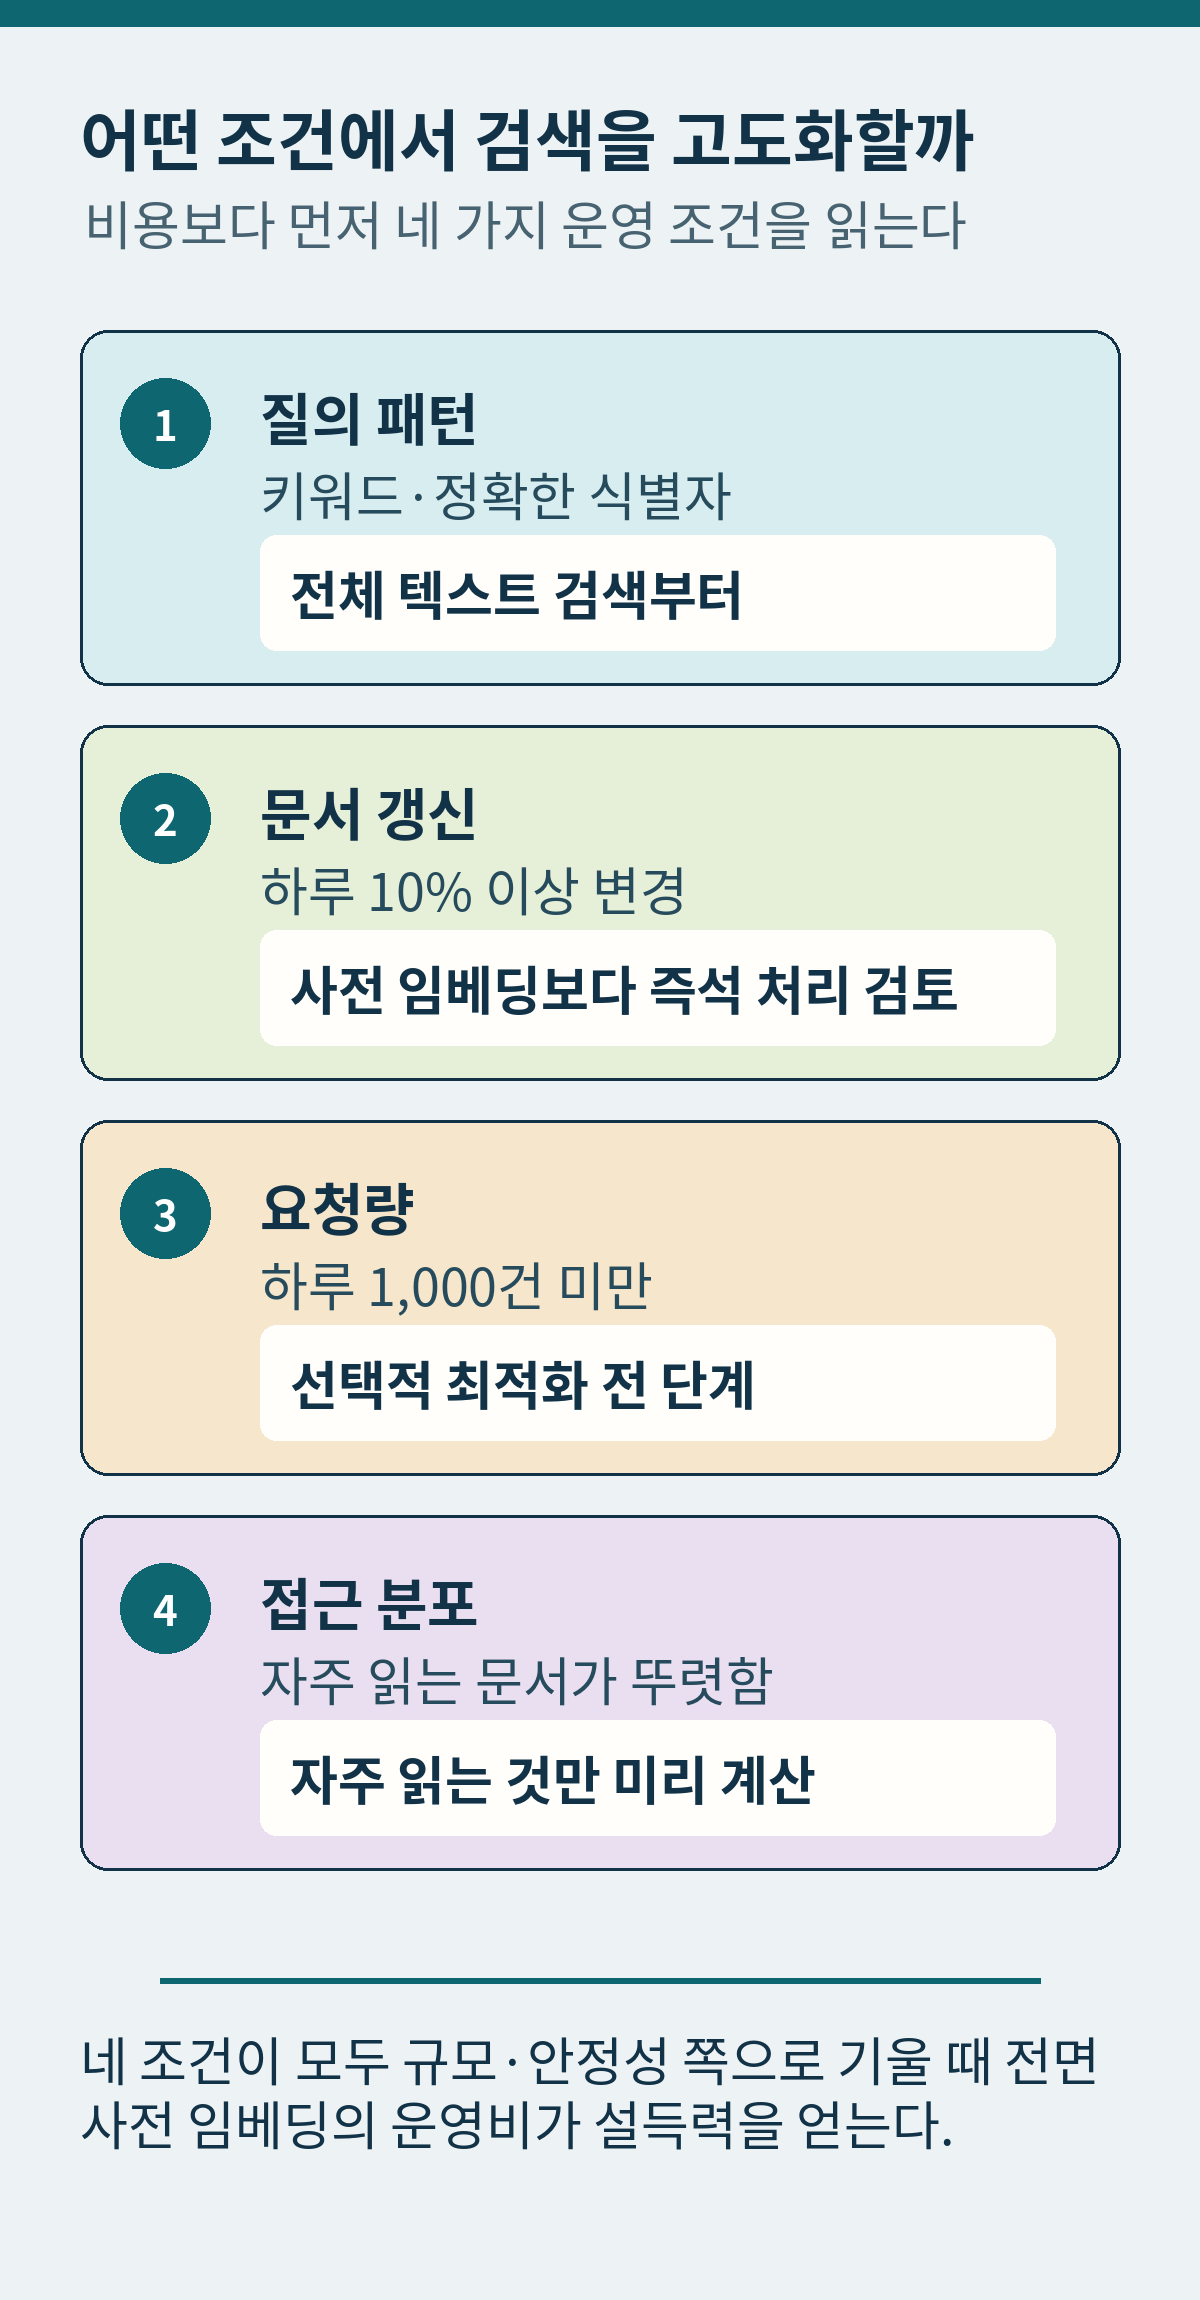
먼저 검색 로그를 둘로 나누면 판단이 쉬워진다. 문서 번호, 제품명, 오류 코드, 사내 약어처럼 정확한 단어가 핵심인 질의와 “이 기능을 어떻게 설정하나”처럼 말하듯 쓰는 질의를 구분하는 일이다. 전자는 단어 일치가 정확한 전체 텍스트 검색에서 잘 풀리는 경우가 많다. 후자는 사용자의 표현을 문서 용어에 맞게 정리하는 질의 재작성만으로 결과가 나아질 수 있다.
원문은 하루 1,000건 미만의 질의라면 단순한 접근이 충분할 수 있다고 제안한다. 이 기준은 절대적인 용량 제한이 아니라, 임베딩 인프라를 먼저 만들기 전에 검색 실패의 종류를 확인하라는 운영 순서다. 재작성은 전체 문서를 다시 계산하지 않고 프롬프트와 용어집을 바꿔 바로 시험할 수 있다. 원문이 든 GPT-4o mini 기준 질의 재작성 비용은 건당 약 0.001달러다.
전체 텍스트 검색만으로 끝나는 경우는 언제인가
BM25와 PostgreSQL 전문 검색 같은 방식은 문서가 왜 선택됐는지 추적하기 쉽다. 청킹 크기와 겹침 폭을 정할 필요도 없다. “invoice #12345”, “pandas merge dataframe”처럼 정확한 단어가 결과를 좌우하는 검색, 내부 시스템 이름처럼 일반 임베딩 모델이 낯설어하는 고유 용어가 많은 문서 묶음에 특히 잘 맞는다.
반대로 동의어와 의도를 알아야 하는 질문은 단어 검색만으로 놓칠 수 있다. 이때도 첫 처방은 벡터 데이터베이스가 아니라 질의 정리다. 사용자가 “버그를 고치는 법”이라고 묻고 문서가 “디버깅”이라는 제목을 쓴다면, 재작성기는 둘을 이어 주는 검색어를 만들 수 있다. 검색 결과와 원래 질문을 함께 저장하면 재작성 전후의 성공률도 비교할 수 있다.
임베딩은 어느 지점에서 추가할까
질의 재작성 뒤에도 의미상 가까운 문서를 놓친다면 혼합 검색이 다음 후보가 된다. 원문은 BM25로 후보 50~100개를 먼저 고르고, 그중 상위 10개를 임베딩으로 재순위화하는 구성을 든다. 정확한 용어를 잡는 단어 검색과 의미 유사도를 보는 임베딩을 분업시키는 방식이다.
여기서 확인할 숫자는 API 청구액 하나가 아니다. 원문은 문서 50개를 즉석에서 임베딩할 때 질의당 200~500ms의 지연이 더해질 수 있다고 설명한다. 사용자 대기 시간이 문제라면 그 지연을 품질 개선과 함께 비교해야 한다. text-embedding-3-small의 100만 토큰당 0.02달러라는 원문의 계산을 따르면, 문서 50개가 각각 500토큰인 질의를 하루 1,000건 처리할 때 월 임베딩 비용은 약 15달러다. 비용보다 먼저 보이는 병목은 응답 시간일 수 있다.
문서가 자주 바뀌면 무엇을 저장해야 하나
하루에 문서의 10% 이상이 바뀌는 뉴스, 소셜 피드, 실시간 운영 문서는 모든 문서를 미리 임베딩하는 방식과 잘 맞지 않는다. 원문은 이 경우 BM25로 좁힌 20~50개 후보만 요청 시점에 임베딩하는 방식을 제시한다. 오래된 벡터를 남겨 두는 대신 최신 텍스트를 바로 점수에 반영할 수 있고, 임베딩 모델을 바꿀 때도 전체 인덱스를 다시 만드는 부담이 줄어든다.
반대로 10만 문서 이상이면서 자주 찾는 문서가 뚜렷하면 자주 읽는 문서만 미리 계산하고 나머지는 요청 시 처리하는 hot/cold 계층이 맞을 수 있다. 하루 1만 건을 넘는 질의, 50ms 미만 응답, 월간 변경률 5% 미만처럼 규모와 안정성이 함께 확보된 경우에야 전체 사전 임베딩과 근사 최근접 이웃 검색의 관리비가 설득력을 얻는다.
복잡한 질문도 한 번에 비싼 경로로 보내지 말라
“CSV를 읽고, 빈 값을 정리하고, 결과를 그려 달라” 같은 질문은 하나의 검색어가 아니라 여러 작업의 묶음이다. 원문은 이를 하위 질의로 나누고, 쉬운 질의는 단어 검색으로, 어려운 질의만 재작성이나 임베딩으로 보내는 방식을 권한다. 병렬로 처리하면 총 대기 시간은 각 하위 작업의 합보다 가장 느린 작업에 가까워진다.
팀이 바로 할 일은 복잡한 RAG 도입 계획을 세우는 것이 아니라, 현재 검색을 2~4주 운영하며 실패 질의를 모으는 일이다. 이미 있는 문서를 못 찾는지, 표현만 달라서 못 찾는지, 의미 검색이 필요한지, 최신성이 깨지는지를 구분하면 다음 투자 대상이 정해진다. 이 순서를 건너뛰면 검색 시스템 비용은 모델 선택표에서 보이는 것보다 커진다.
출처: Rafael Pierre, “RAG Is Simpler Than You Think”, Lighthouse AI, 2026-06-10