
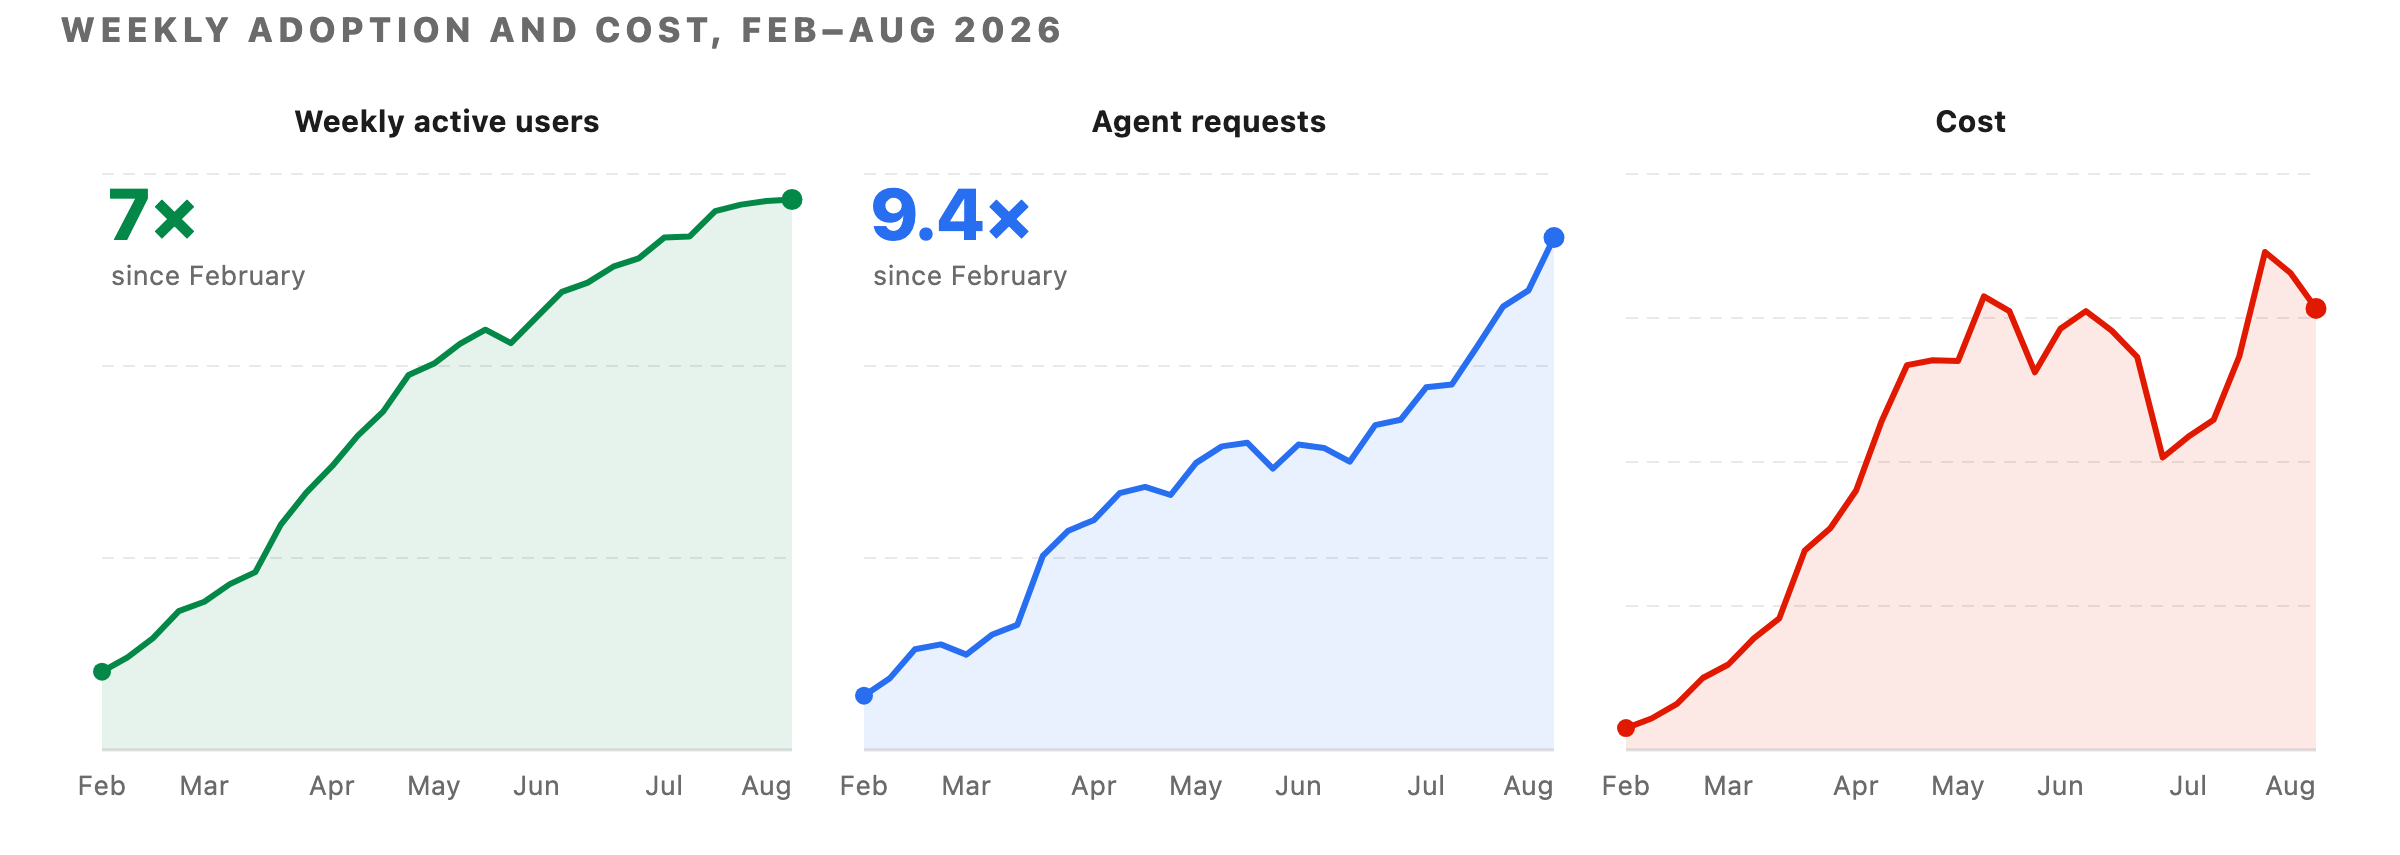
AI 도입이 넓어질수록 제품팀은 곧 예산을 막는 사람과 쓰임을 넓히는 사람 사이에 선다. Uber는 2026년 2월부터 8월 중순까지 주간 활성 사용자를 7배, 주간 에이전트 요청을 9.4배로 늘리면서도 4월 이후 총 AI 지출을 대체로 안정화했다고 밝혔다. 답은 사용량 상한을 먼저 거는 일이 아니라, 비용이 만들어지는 과정을 제품 운영 대상으로 바꾸는 데 있었다.
Uber 내부에서는 풀 리퀘스트의 70% 이상이 로컬 또는 클라우드 에이전트에서 나왔고, 엔지니어가 만든 에이전트 스킬은 3,600개를 넘었다. 하루 스킬 실행도 3만 건 이상이다. 이 정도 규모에서는 "이번 달 얼마를 썼나"라는 총액만으로 원인을 찾을 수 없다. 누가 어떤 세션에서, 어느 모델로, 몇 번의 왕복과 토큰을 썼는지를 제품 지표처럼 나눠 봐야 한다.

사용량이 늘었는데도 비용은 왜 멈출 수 있었나
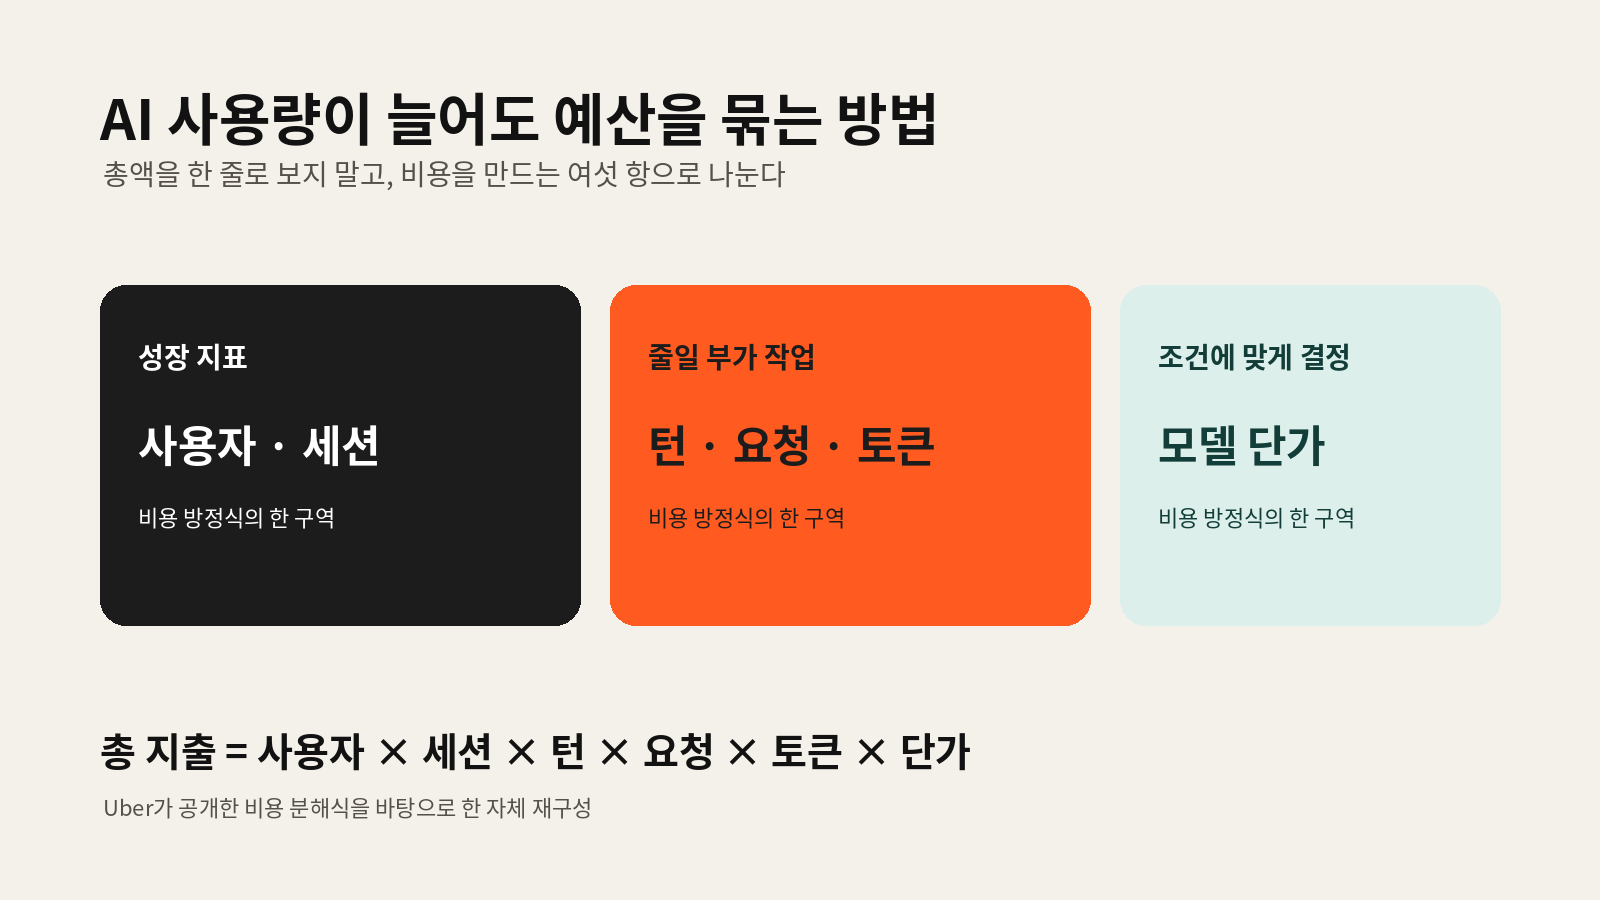
총 AI 지출은 여섯 항의 곱으로 볼 수 있다. 사용자 수 × 사용자당 세션 × 세션당 턴 × 턴당 요청 × 요청당 토큰 × 토큰당 가격이다. 앞의 두 항은 채택과 이용 빈도다. 제품팀이 AI를 도입한 이유가 실제 업무 활용을 넓히는 데 있다면 이 값은 줄일 목표가 아니다. Uber는 그 뒤의 세 항, 곧 에이전트가 사람의 요청을 처리하면서 추가로 만드는 턴·요청·토큰을 주요 최적화 영역으로 잡았다.
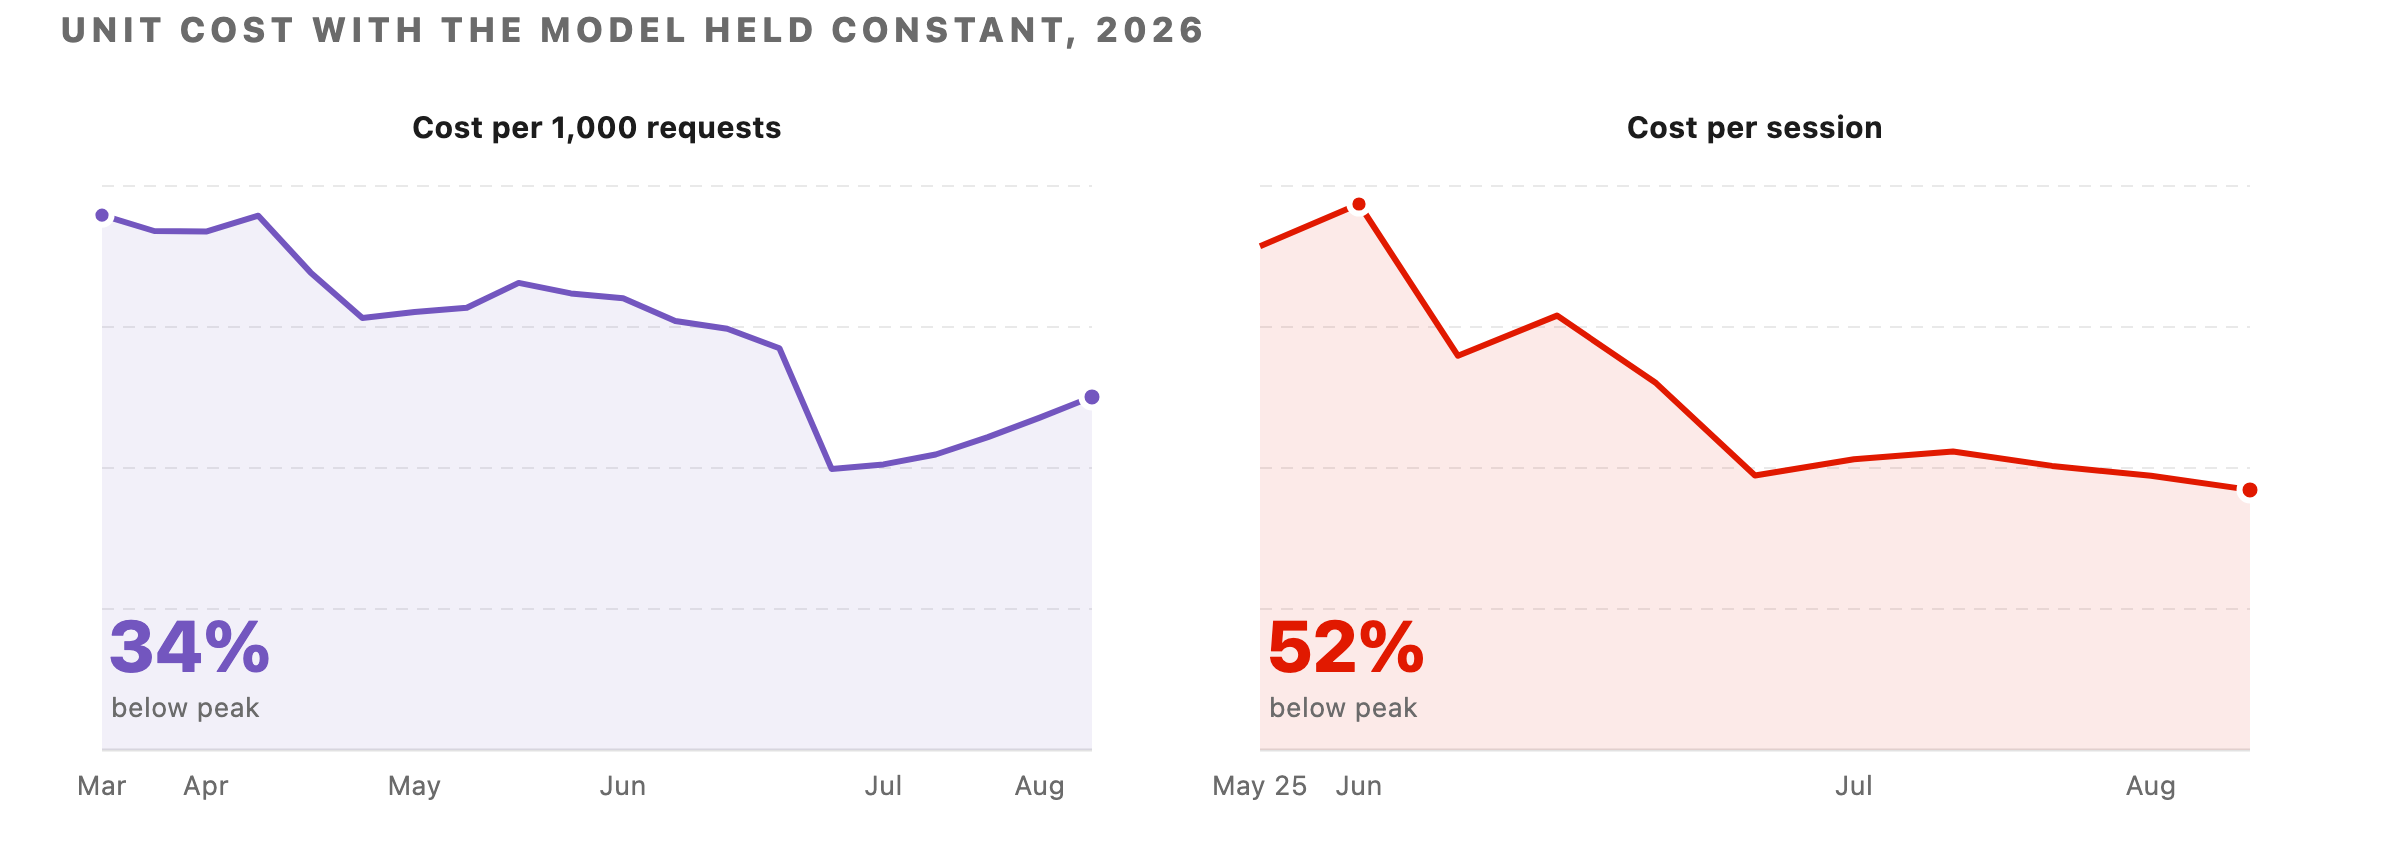
단가도 별도 축이다. 같은 모델을 고정해 비교했을 때 Uber는 2월부터 7월 사이 요청 1,000건당 비용을 정점 대비 약 34% 낮췄고, 세션당 비용은 6월 정점 대비 52% 낮췄다고 설명했다. 사용자가 늘어 비용이 늘었다는 설명과, 같은 작업을 더 비싸게 처리했다는 설명을 분리한 셈이다.
예산을 멈추는 대신, 비용 신호를 먼저 보여준다
Uber의 운영 방식에서 눈에 띄는 부분은 엄격한 개인별 상한 대신 실시간 가시성을 택했다는 점이다. 터미널 상태 줄에 세션 비용을 계속 표시하고, 여러 대화형 도구는 도구별 예산이 아니라 하나의 공동 풀로 관리한다. 자동 실행되는 관리형 에이전트에는 별도 등급을 둔다. 예상 지출의 50%, 80%, 100%에 도달하면 Slack 알림을 보내고, 등급 상향은 관리자의 빠른 승인 흐름으로 처리한다.
이 구조는 "예산 초과"라는 사후 사건을 "계속할 일인지, 더 싼 경로가 있는지"를 고르는 작업으로 바꾼다. 상태 줄은 현재 비용을 보여주고, 세션 분석 화면은 왜 비용이 생겼는지 파고든다. Uber의 분석 도구는 모델 선택, 커진 컨텍스트, 캐시 만료, 시작 프롬프트 과부하처럼 16가지 낭비 패턴을 세션 기록에서 찾는다. 제품팀이 비용 알림을 만들 때도 남은 예산만 보여주기보다, 바로 다음에 바꿀 수 있는 행동까지 붙여야 하는 이유다.
제품팀이 매주 답해야 할 질문은 네 가지다
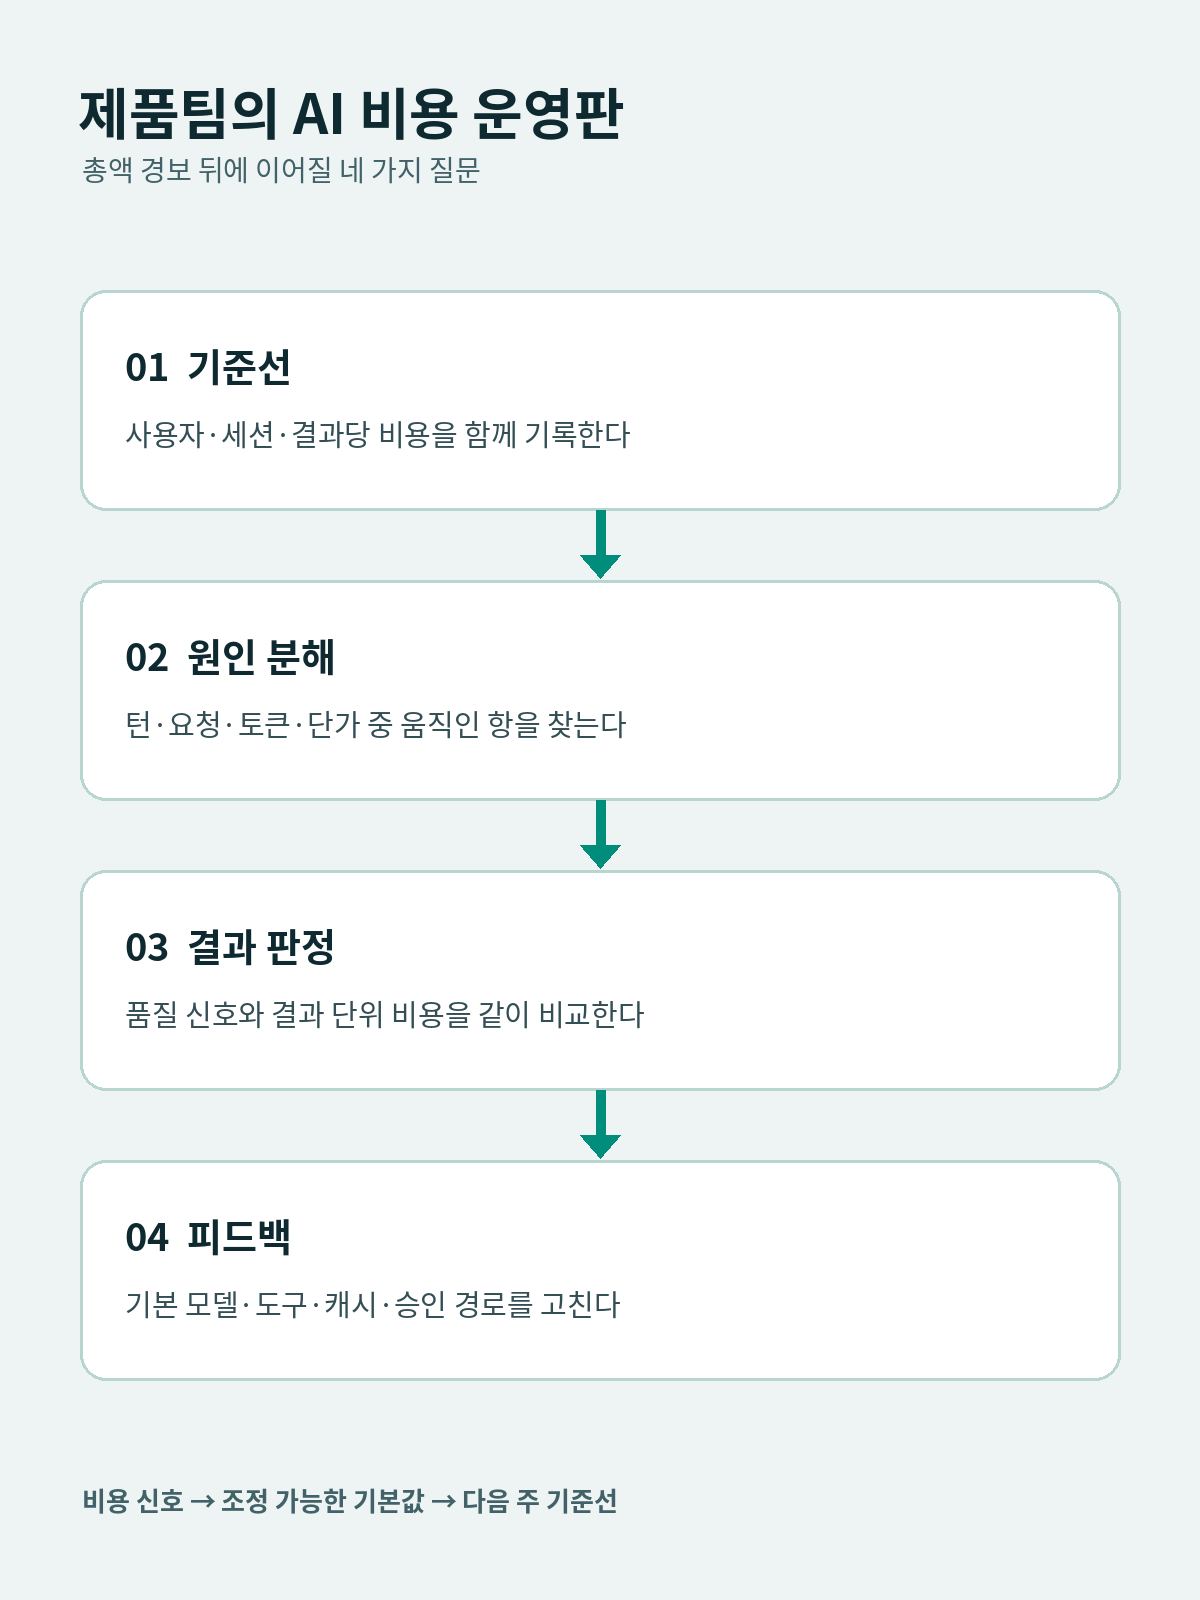
첫째, 사용자가 늘어서 비용이 늘었는가. 둘째, 세션 하나가 길어졌는가. 셋째, 모델·도구·컨텍스트 중 무엇이 요청당 토큰을 키웠는가. 넷째, 더 많은 비용이 실제 결과 품질을 높였는가. 이 순서가 없으면 사용량 급증 때 가장 쉬운 처방인 모델 하향이나 일괄 차단으로 흐르기 쉽다.
Uber는 관리형 에이전트마다 머지된 풀 리퀘스트, 코드 리뷰, 경보 분류, 정리 작업처럼 결과 단위의 비용을 두고, 되돌림 비율·F1·평균 복구 시간 같은 품질 신호와 함께 본다. 모델 선택도 벤치마크에서 비용·완료 품질·신뢰성을 같이 비교해 파레토 효율적인 조합을 고른다. 단가가 싼 모델이 아니라 같은 결과를 가장 낮은 비용으로 내는 경로를 찾는 방식이다.
도구 연결 방식도 비용 설계의 일부다
에이전트가 가진 도구 정의와 대화 기록은 매 요청마다 다시 전송된다. Uber는 100개가 넘는 도구를 세션 처음에 모두 불러오면 도구 스키마만 약 5만~7만 토큰이 더해진다고 적었다. 그래서 내부 MCP 도구를 셸 명령으로 노출하고, 필요한 도구만 검색해 불러오게 했다. SQL처럼 여러 번 상태를 확인하는 작업은 코드 모드에서 반복을 스크립트로 묶고, 모델에는 마지막 요약만 돌려준다.
여기서 제품팀의 설계 대상은 모델 API 요금제가 아니라 기본 경로다. 긴 컨텍스트를 언제 압축할지, 캐시 수명을 작업 성격에 맞게 어떻게 정할지, 하위 작업에는 어느 모델을 기본값으로 둘지, 반복 조회를 어디에서 묶을지를 제품 기본값으로 결정한다. Uber는 대화형 세션에서는 400K 토큰에서 자동 압축을 시작하고 추론 노력의 기본값을 Medium으로 두며, 짧게 끝나는 하위 에이전트와 사람의 유휴 시간이 긴 대화형 세션에 서로 다른 캐시 수명을 사용한다.
결국 예산을 지키는 운영은 사용량을 누르는 일이 아니다. 사용자가 늘어도 가치 없는 왕복, 불필요하게 실린 컨텍스트, 결과로 이어지지 않는 고비용 경로를 계속 찾아 기본값에서 없애는 일이다. 총액 경보는 시작 신호이고, 제품팀의 일은 그 뒤에 비용의 곱셈식을 결과 지표와 다시 연결하는 데 있다.
출처: Uber Engineering, “Running a Software Factory Efficiently at Uber Scale” (2026-08-27)