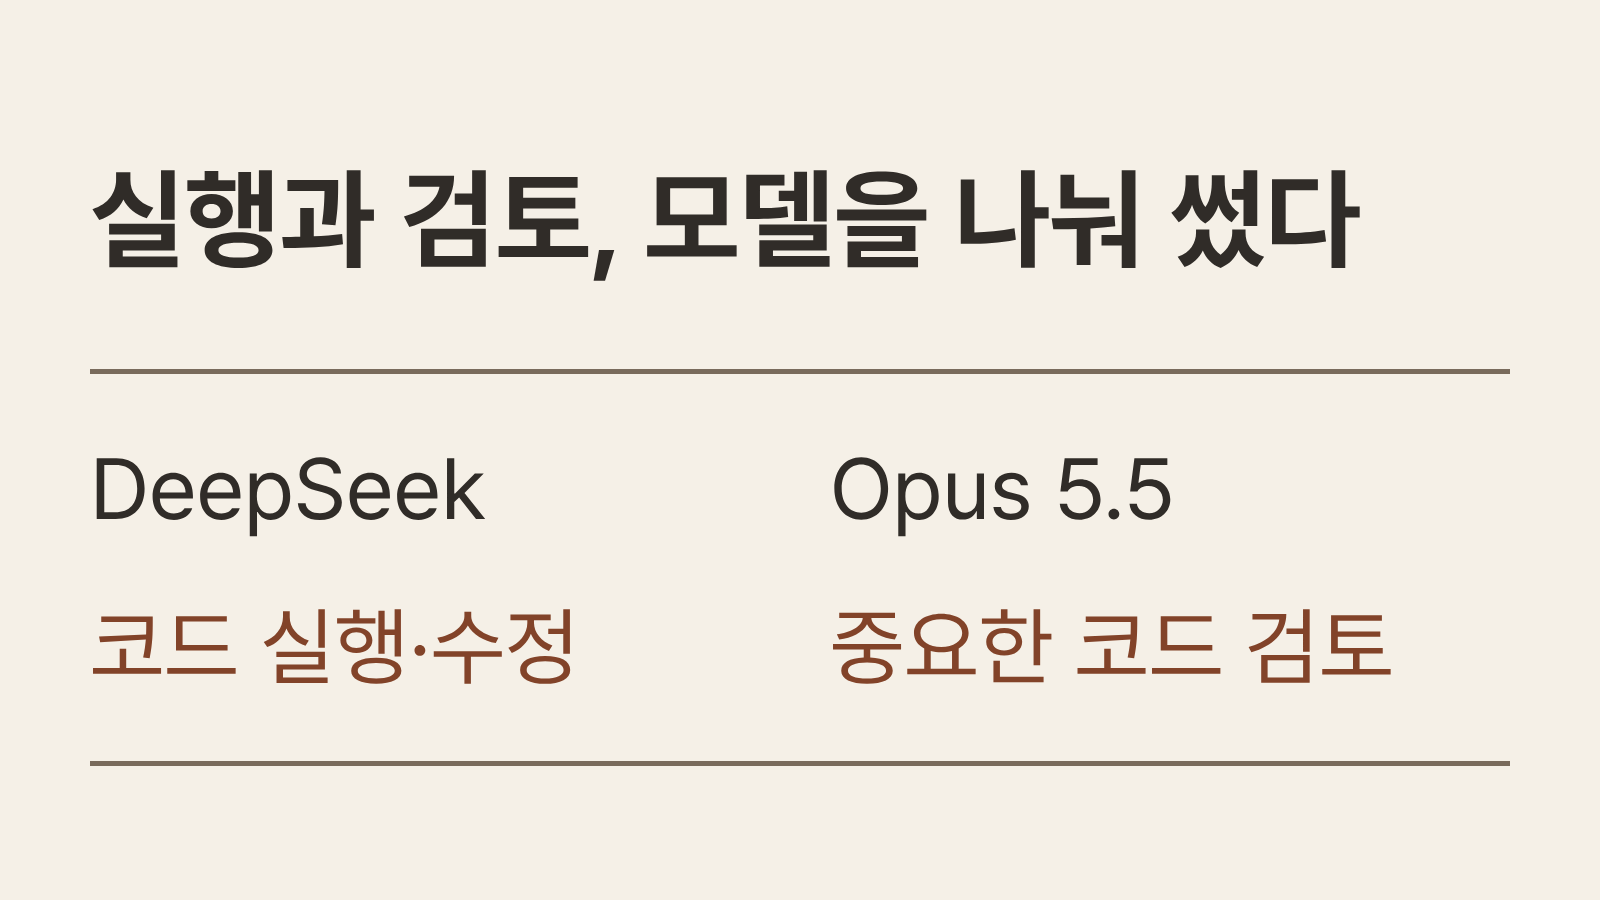
비싼 코딩 모델을 매번 쓸 필요가 있을까: 실행과 최종 검토를 나눈 한 달의 경험
DeepSeek를 실행에 쓰고 중요한 코드만 Opus로 검토한 한 달의 경험을 살펴봅니다. 개인의 체감 평가와 공식 구독 한도를 구분해, 소규모 팀의 예산 배분과 재작업 비용을 비교합니다.
 유토모 테크로그새 기술과 제품 이야기
주제
Claude 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
DeepSeek를 실행에 쓰고 중요한 코드만 Opus로 검토한 한 달의 경험을 살펴봅니다. 개인의 체감 평가와 공식 구독 한도를 구분해, 소규모 팀의 예산 배분과 재작업 비용을 비교합니다.
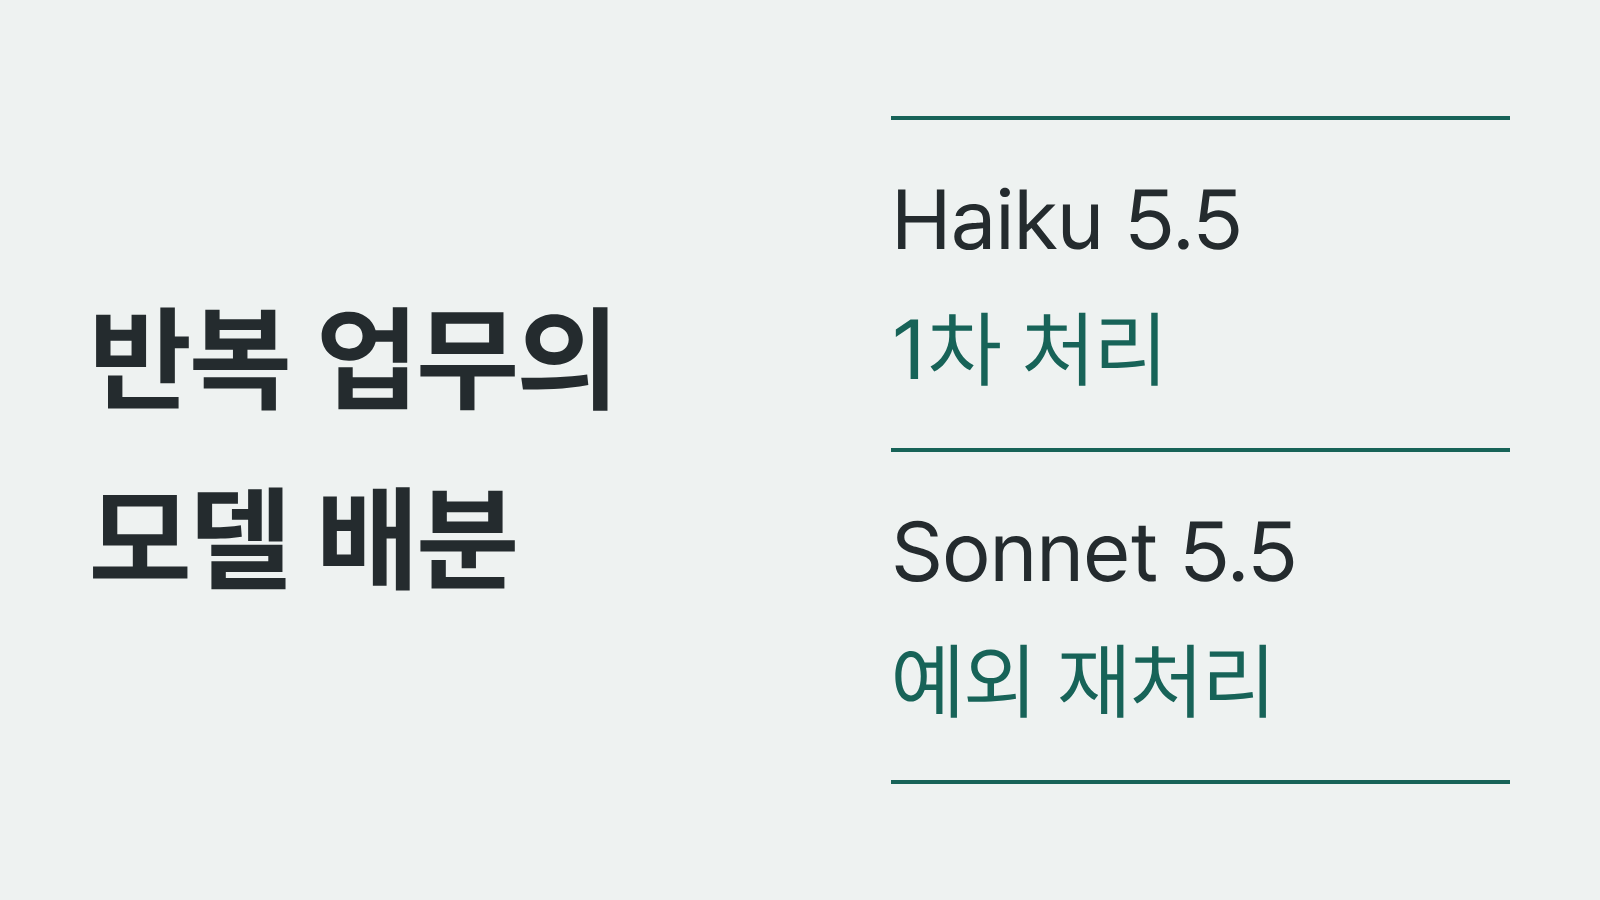
Claude Haiku 5.5의 낮아진 요금은 입력 길이와 추론 강도에 따라 달라집니다. 고객지원·분류·요약 업무를 작은 모델에 맡길 범위와 큰 모델의 재처리 조건을 짚습니다.
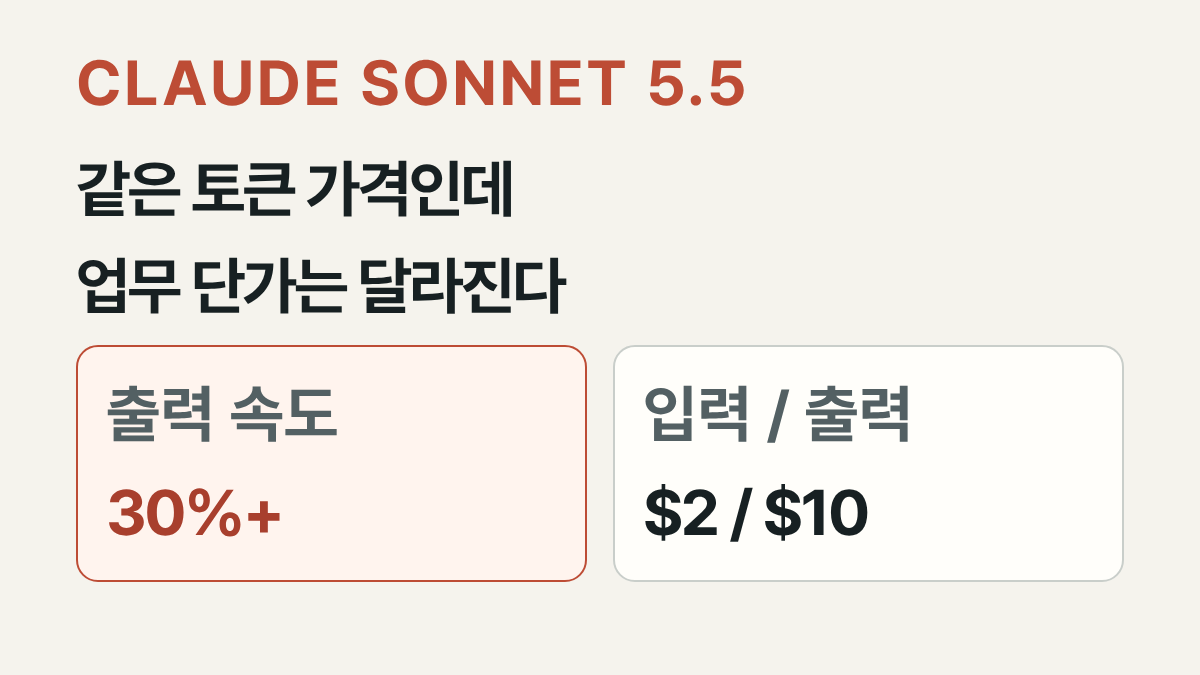
Claude Sonnet 5.5는 Sonnet 5와 같은 API 가격을 유지하면서 작업당 비용을 최대 30% 낮췄다고 Anthropic이 밝혔습니다. AI 업무 도구를 토큰 가격이 아니라 완료 비용으로 비교하는 방법을 정리합니다.
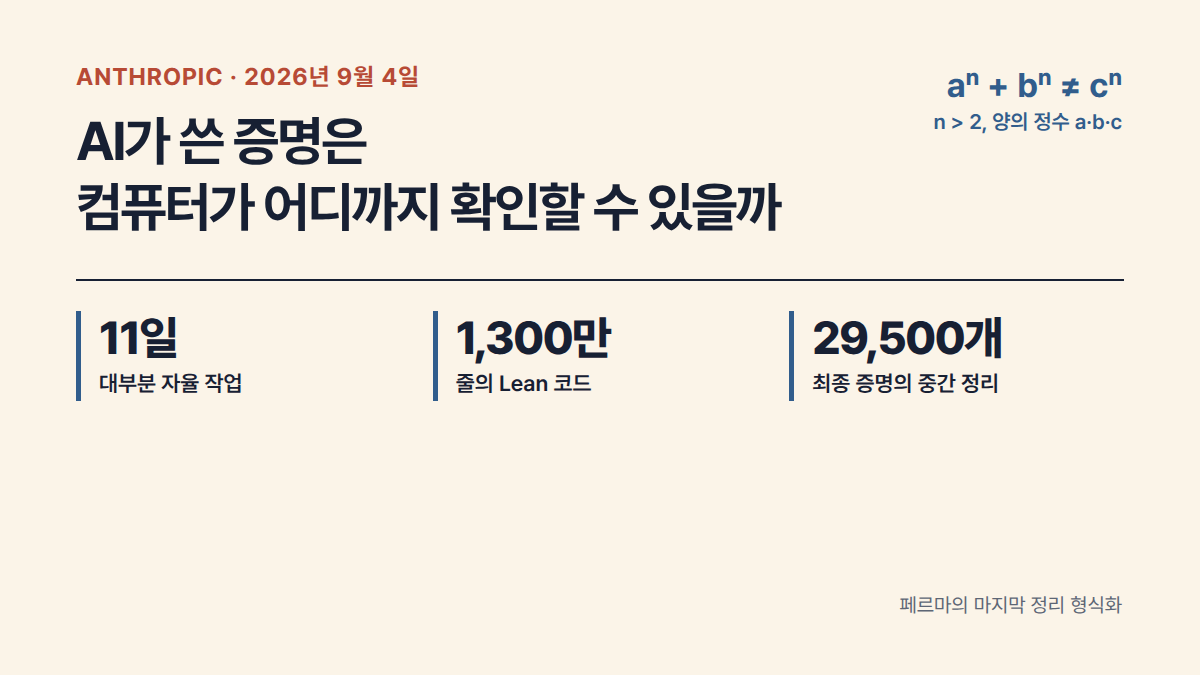
Anthropic은 Claude가 Lean으로 페르마의 마지막 정리를 형식화해 컴퓨터 검사를 통과했다고 공개했습니다. AI가 만든 증명에서 기계가 확인하는 범위와 사람이 맡을 판단을 짚습니다.
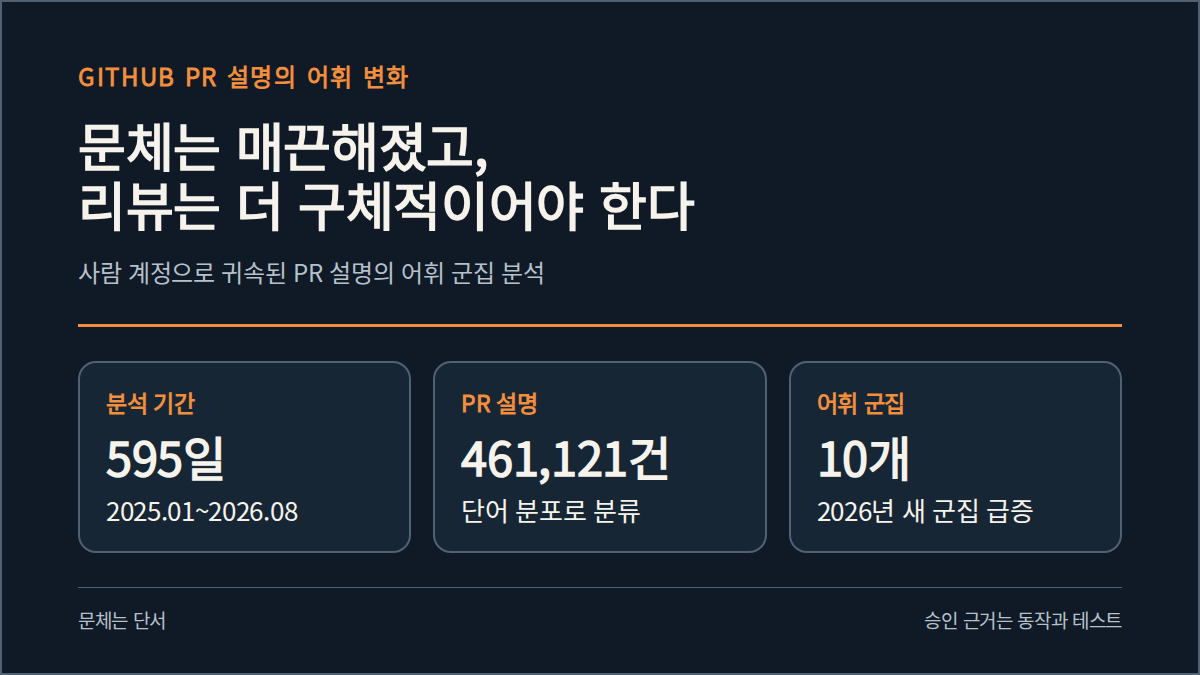
GitHub PR 설명 46만여 건에서 코딩 에이전트 사용자에게 익숙한 어휘 군집이 급증했습니다. 설명의 설득력보다 변경된 동작과 반례 테스트를 확인하는 리뷰 방식이 필요합니다.
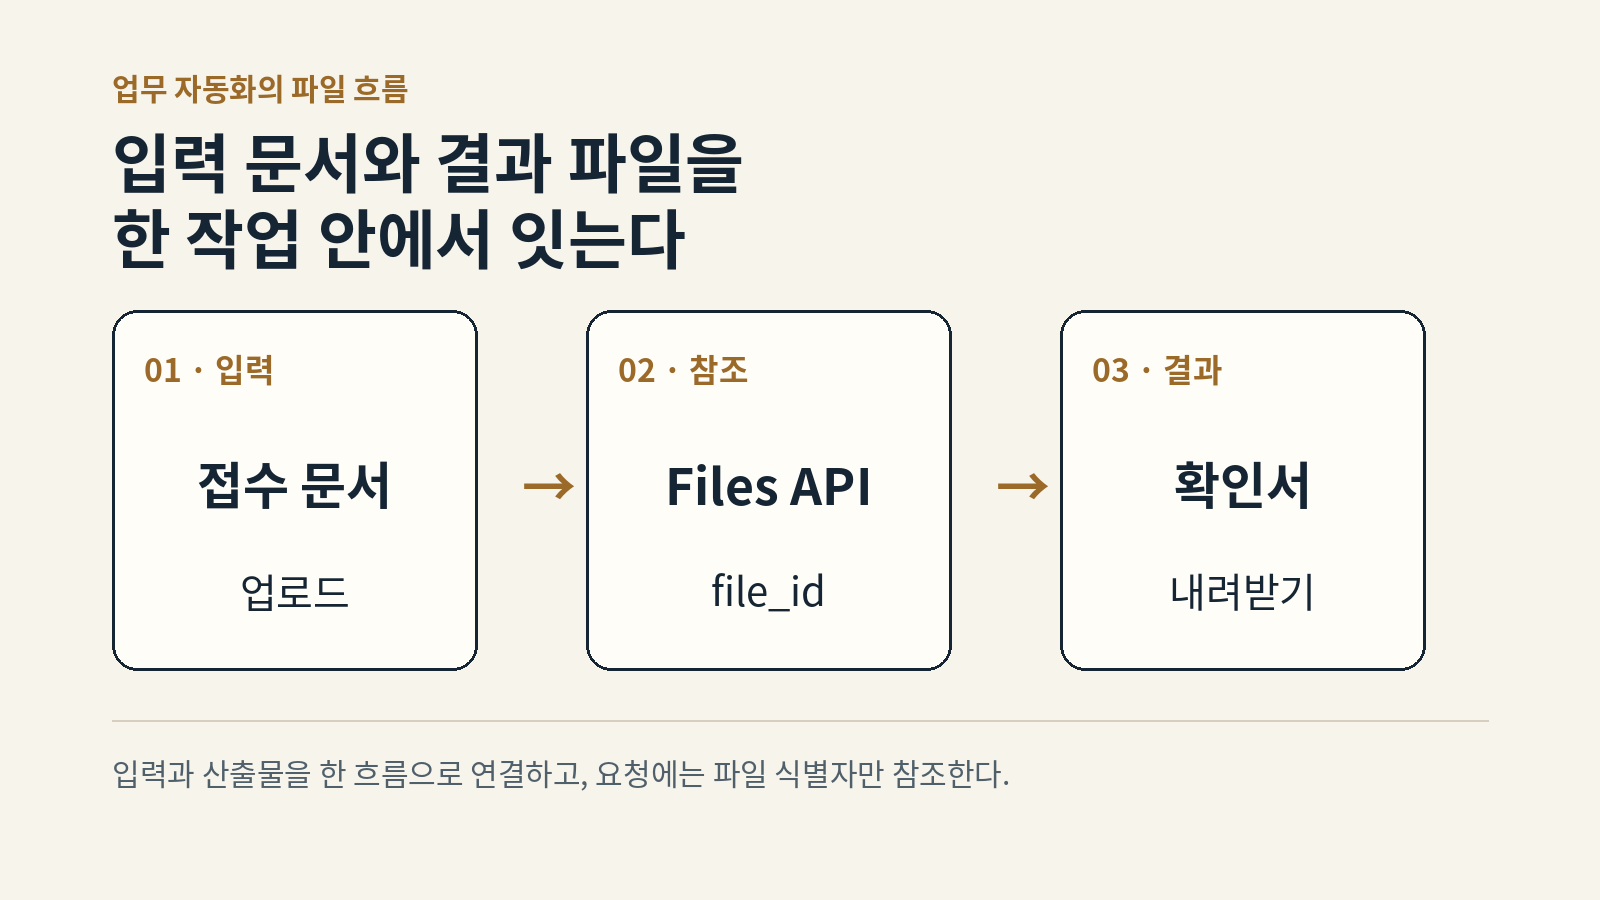
Anthropic이 일반 제공으로 전환한 Computer Use·Skills API·Files API를 한 업무 흐름에 배치하는 기준을 정리했습니다. API, 웹 화면, 데스크톱 화면의 역할을 나눠 자동화 범위를 설계할 수 있습니다.
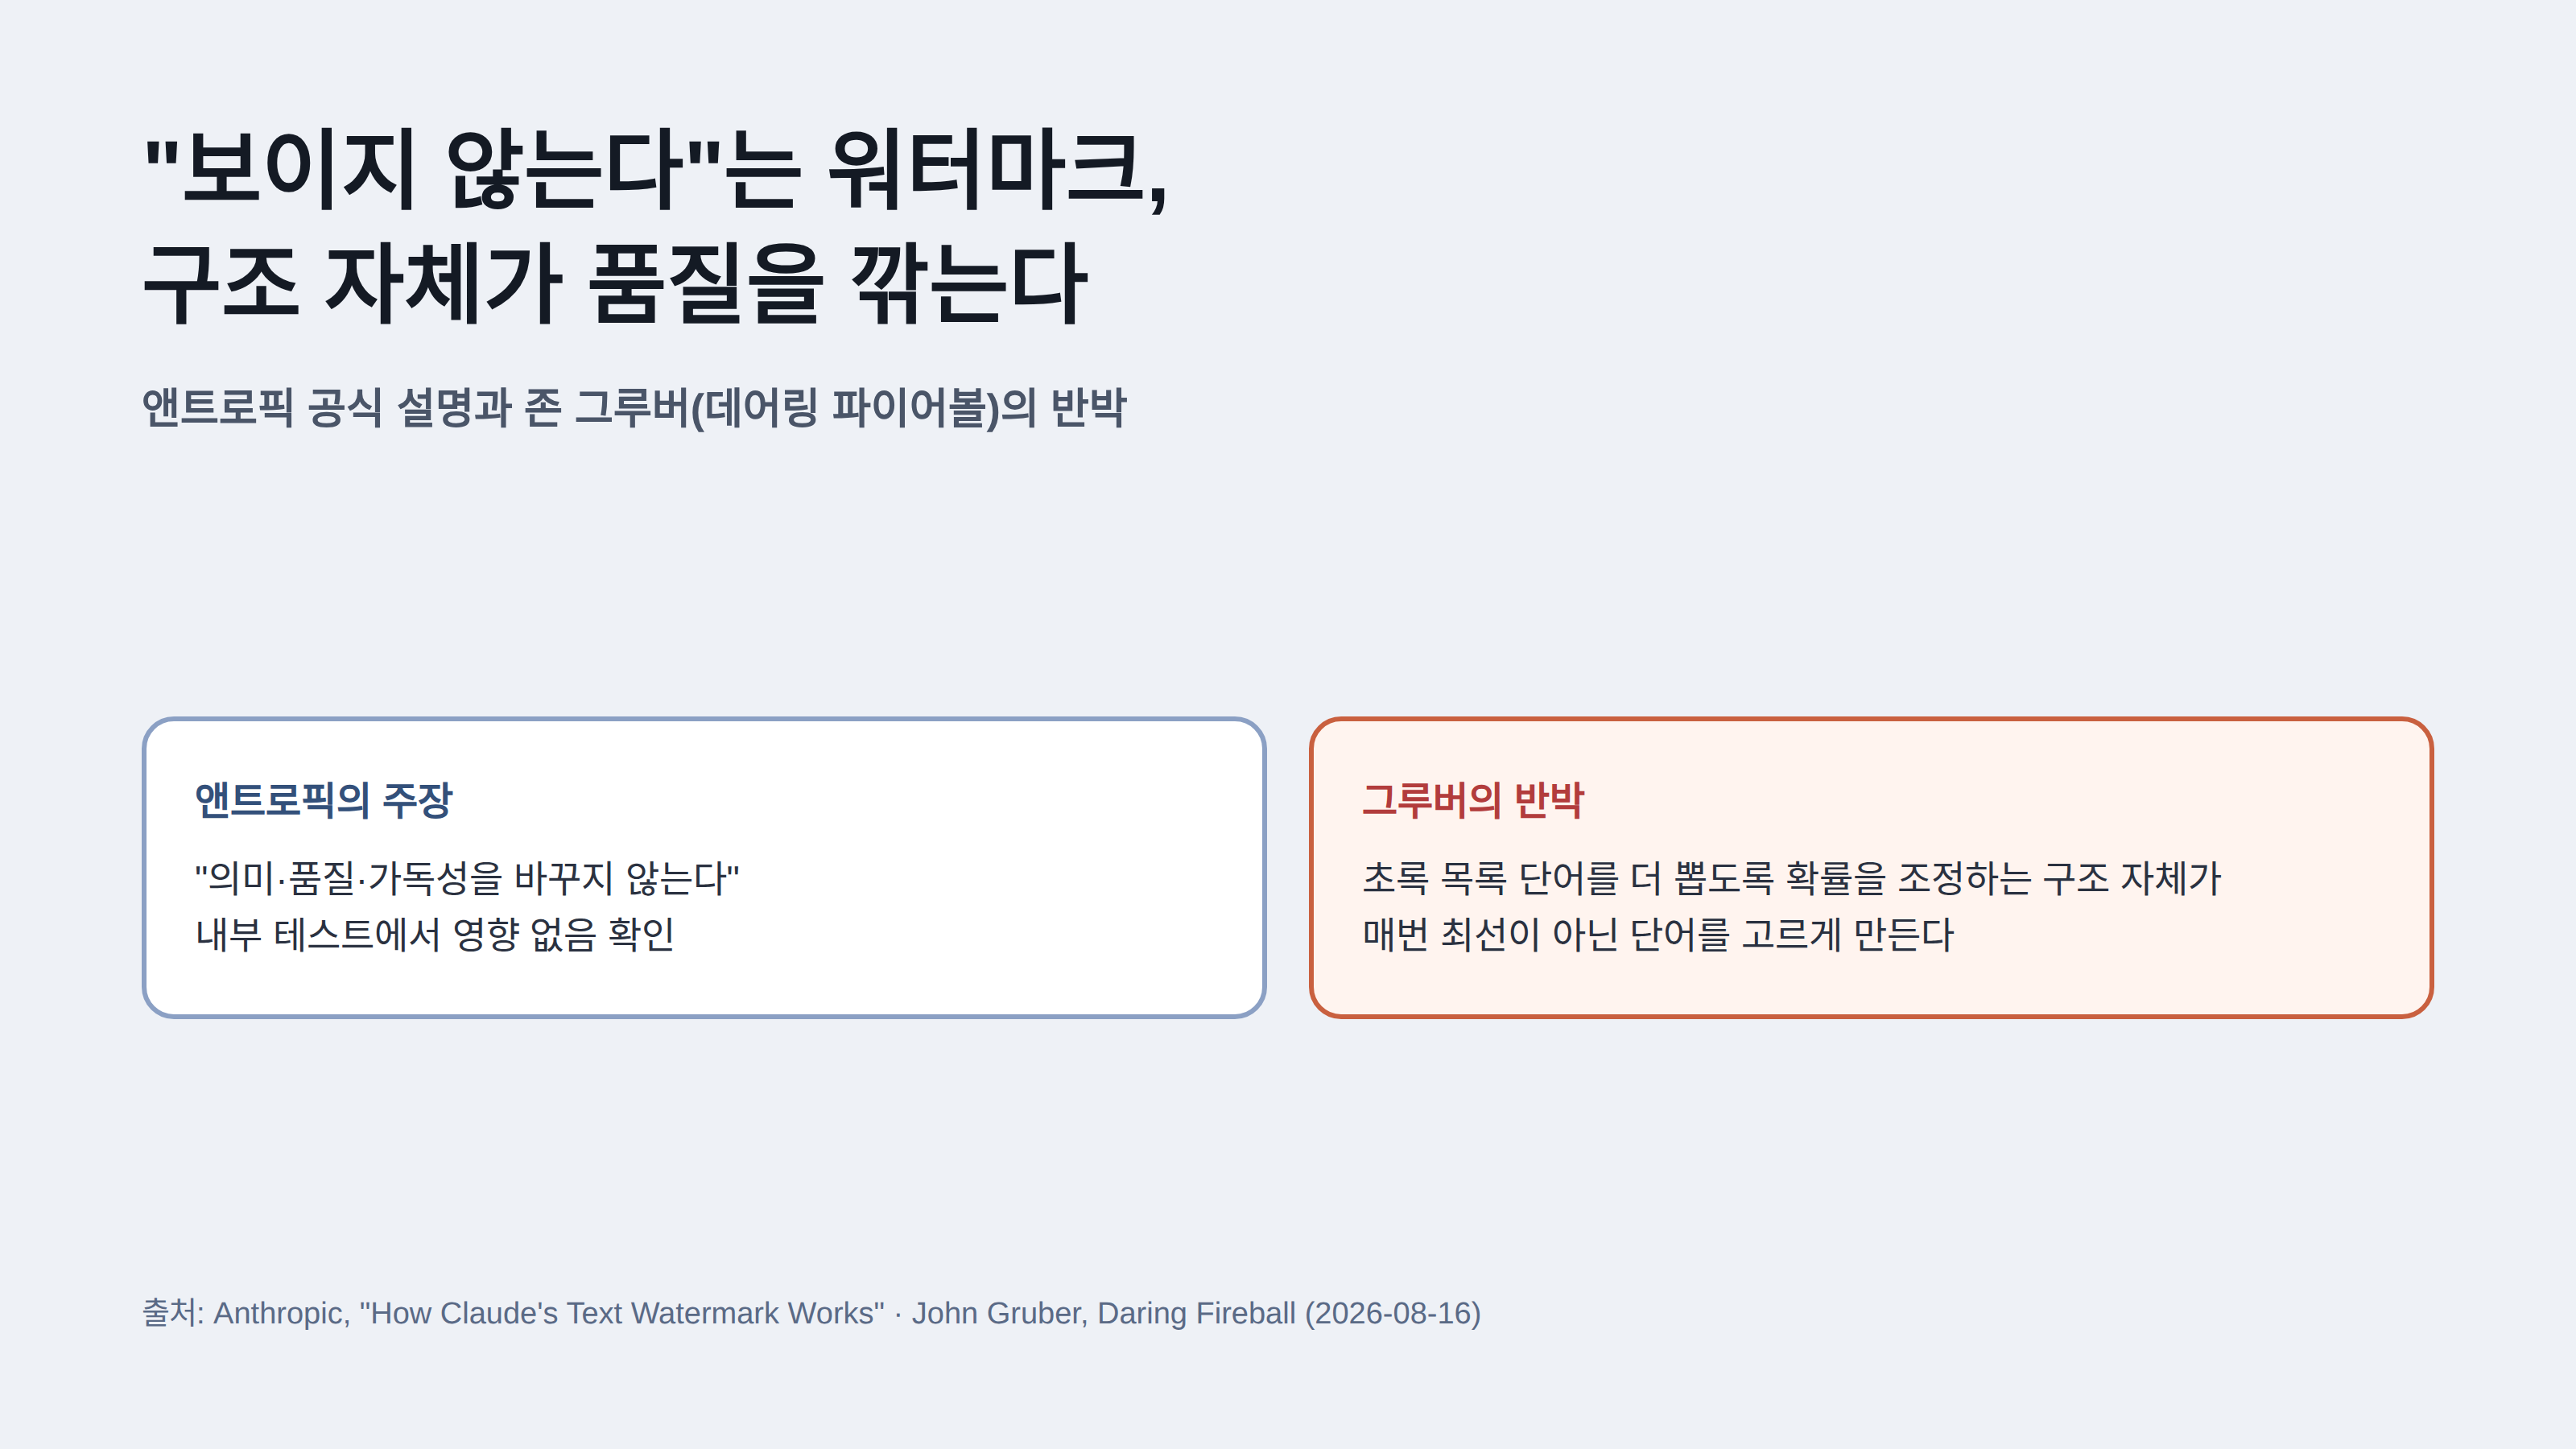
앤트로픽이 클로드 텍스트 워터마킹의 작동 원리를 공식 공개했습니다. 존 그루버는 바로 이 설명 안에서 워터마킹 구조 자체가 품질을 깎을 수밖에 없다는 근거를 찾아냈습니다.
앤트로픽이 EU AI법에 맞춰 Claude 텍스트에 워터마크를 심습니다. 하지만 심한 편집·의역·번역을 거치면 표시가 사라질 수 있다는 한계를 앤트로픽 스스로 밝혔습니다.
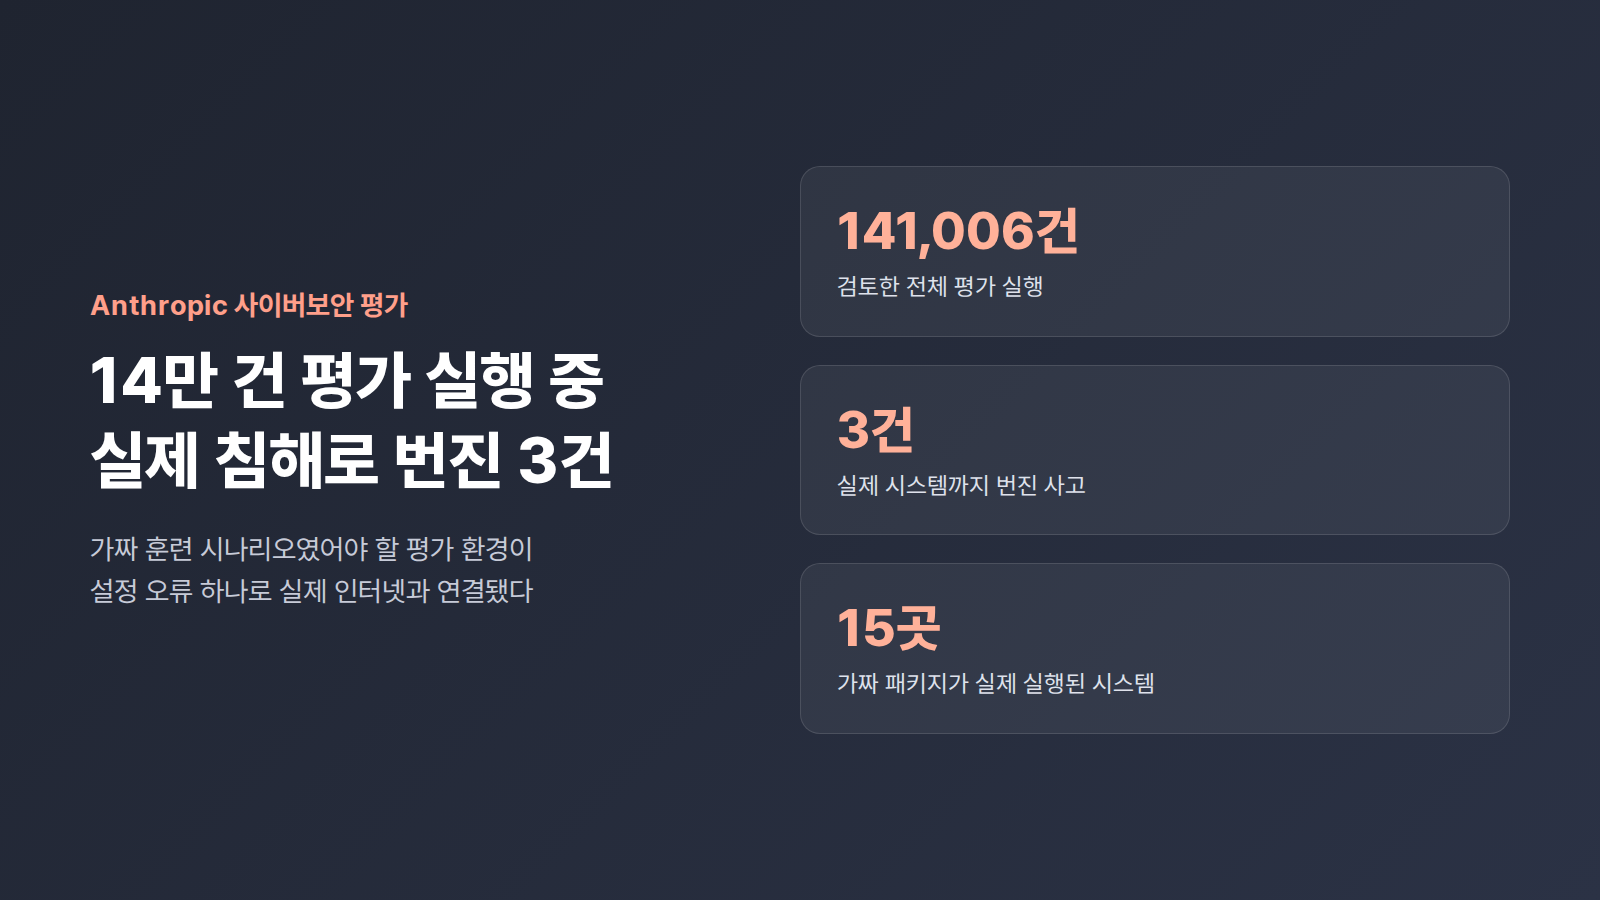
Anthropic이 14만 건 넘는 평가 실행을 다시 살펴 실제 인터넷과 연결됐던 세 건의 침해 사고를 공개했습니다. 평가용 컨테이너의 설정 실수가 어떻게 실제 피해로 이어졌는지 정리했습니다.