
고객 문의를 분류하고 상담 기록을 요약하는 서비스는 한 번의 답변보다 매일 쌓이는 요청 수가 비용을 결정한다. Anthropic은 10월 7일 이런 대량 반복 업무를 겨냥한 Claude Haiku 5.5를 공개했다. 작은 모델에 먼저 맡기고 어려운 요청만 큰 모델로 넘기는 운영을 다시 계산할 만한 가격이다.
발표의 '평균 실행 비용 약 75% 절감'을 모든 요청에 적용되는 할인율로 읽으면 예산이 어긋난다. 입력이 10만 토큰 이하인지, 모델이 얼마나 오래 추론하도록 설정했는지에 따라 비용과 결과가 달라진다. 토큰은 모델이 글을 처리하는 단위이며, 같은 문장도 모델 버전에 따라 토큰 수가 바뀐다.
10만 토큰을 넘으면 출력 가격도 달라진다
Claude Platform의 공개 요금표에서 Haiku 5.5는 입력이 10만 토큰 이하인 요청에 대해 100만 토큰당 입력 0.10달러, 출력 0.50달러를 받는다. 입력이 10만 토큰을 초과하는 요청은 입력 0.50달러, 출력 2.50달러다. 출력 단가 역시 입력 길이로 구분된 요청의 가격을 따른다. 긴 자료를 붙이면서 입력 가격만 높여 계산해서는 안 된다.
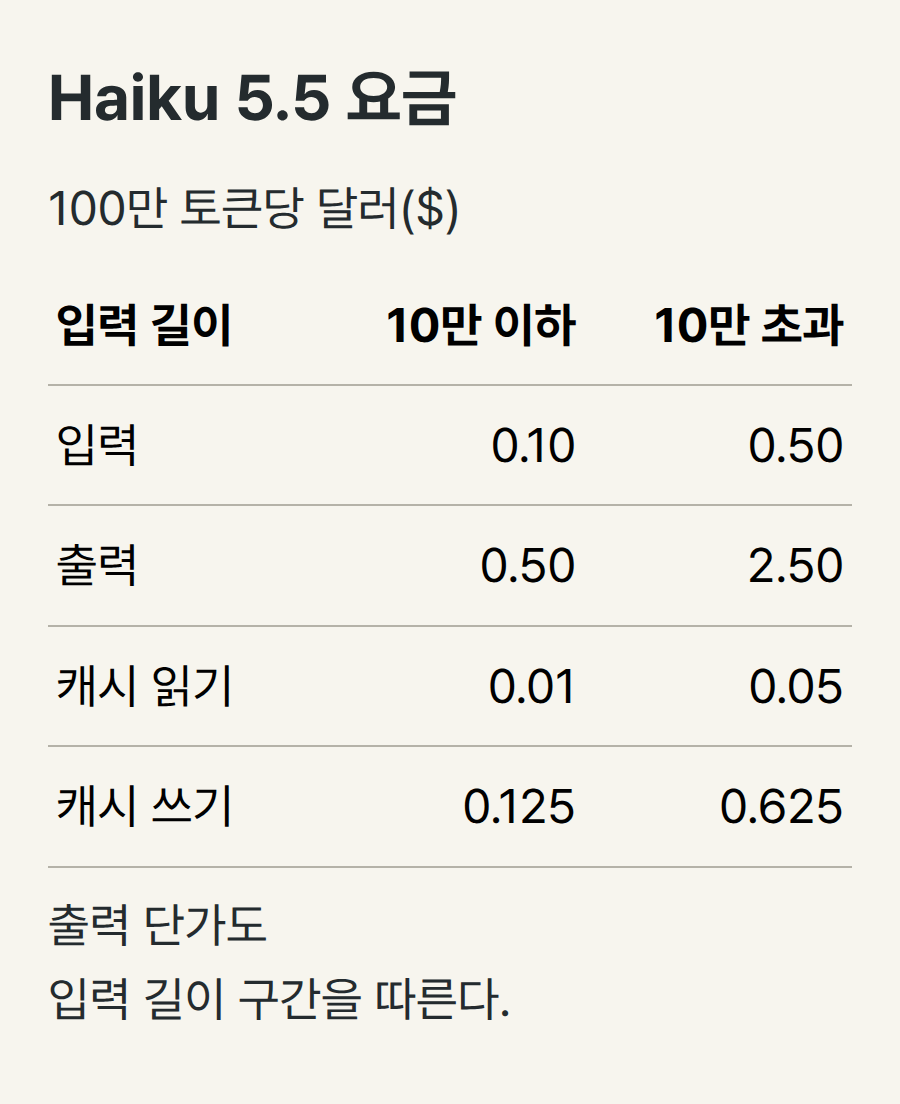
Haiku 4.5의 입력·출력 가격은 각각 1달러와 5달러였다. 같은 토큰 수로 비교하면 새 모델의 짧은 입력 구간은 90%, 긴 입력 구간은 50% 저렴하다. 예를 들어 캐시를 쓰지 않고 입력 1만 토큰과 출력 1천 토큰을 사용하는 요청은 새 모델에서 0.0015달러, 이전 모델에서 0.015달러다. 같은 토큰 수의 요청 100만 건이면 각각 1,500달러와 15,000달러다. 이는 요금표를 대입한 예시이며 실제 업무의 토큰 사용량을 측정한 값은 아니다.
Anthropic의 약 75% 절감 수치는 이전 Haiku 요청 중 약 90%가 짧은 입력 구간에 속했다는 사용 분포와, 새 모델의 토큰 사용량 변화까지 반영한 평균이다. 이 비율만으로 각 서비스의 절감액을 정할 수는 없다. 이전 모델에서 세어 둔 입력 길이도 그대로 재사용하면 안 된다. 공식 이전 가이드는 같은 입력 텍스트가 Haiku 5.5에서 대략 30% 더 많은 토큰으로 계산되며 증가폭은 내용에 따라 다르다고 설명한다. 기존에 10만 토큰 아래였던 자료도 새 모델로 다시 세어야 한다.
추론 강도를 올리면 얼마를 더 내고 무엇을 얻나
Haiku 5.5는 Haiku 계열에서 처음으로 effort, 즉 추론 강도 조절을 지원한다. Anthropic이 공개한 OSWorld 2.1 오프라인 부분집합 평가에서 Haiku 5.5의 Low는 시도당 0.07달러에 42.0%, Med는 0.13달러에 53.3%, High는 0.18달러에 61.3%였다. Xhigh는 0.28달러에 67.6%, Max는 0.61달러에 72.4%다. 이 그래프의 세로축은 부분점수 기준 점수다. 컴퓨터로 여러 단계의 작업을 처리하는 평가이므로 고객 문의 분류의 정답률로 옮겨 쓸 수는 없다.
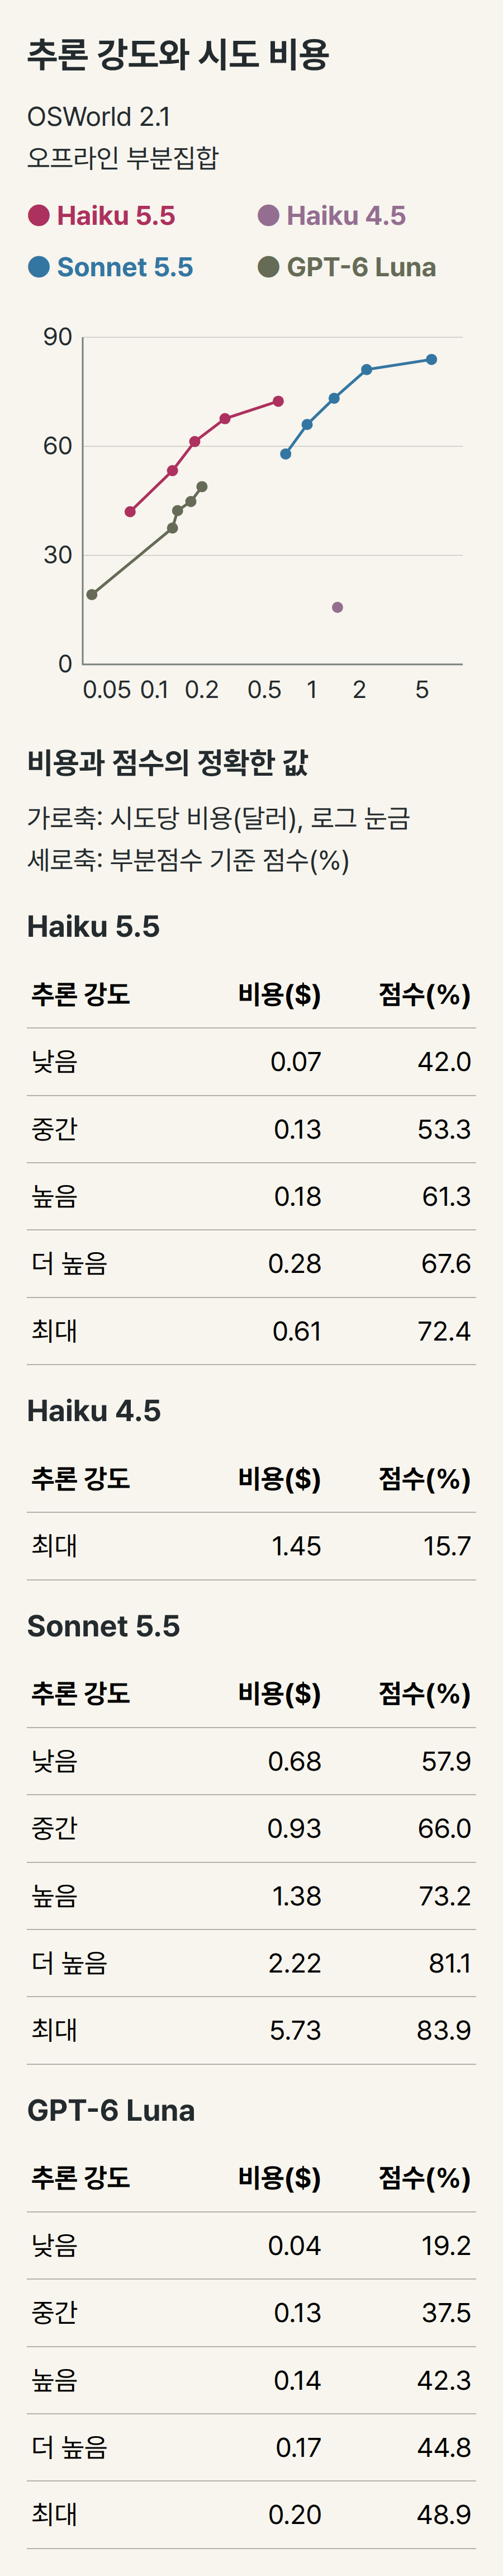
High에서 Max로 올리면 시도당 비용은 약 3.4배가 되고 점수는 11.1%포인트 오른다. 요청 전부를 Max로 보내기 전에 더 높은 점수가 필요한 업무를 구분할 이유다. 같은 평가의 Max에서 Haiku 4.5는 1.45달러에 15.7%, GPT-6 Luna는 0.20달러에 48.9%, Sonnet 5.5는 5.73달러에 83.9%였다. 새 Haiku는 이전 Haiku보다 낮은 비용에 높은 점수를 냈지만, GPT-6 Luna보다 항상 싸거나 Sonnet과 같은 점수를 내는 모델은 아니다.
긴 코딩 업무에서는 차이가 더 크다. 발표에 실린 Terminal-Bench 4.0 점수는 Haiku 5.5가 39.2%, Sonnet 5.5가 70.6%다. Anthropic도 복잡한 코딩 에이전트 작업에는 Sonnet과 Opus를, 범위가 좁은 요약·문맥 압축·보조 작업에는 Haiku를 권한다. 토큰 단가가 내려갔다고 기존의 복잡한 업무를 통째로 옮길 근거는 부족하다.
작은 모델의 실패를 어떤 조건에서 다시 처리할까
모델을 고르기 전에 업무를 나눠야 한다. 정해진 분류 항목에 문의를 넣거나 한 상담의 요점을 추리는 일은 Haiku의 낮은 effort부터 시험할 수 있다. 평가에는 실제 한국어 문의와 긴 상담 기록을 포함하고, 분류가 틀렸을 때의 손실을 함께 기록해야 한다. 몇 건을 맞혔는지와 최종 처리 한 건에 얼마가 들었는지를 따로 본다.
재처리 조건은 응답을 받은 뒤 검사할 수 있게 정하는 편이 낫다. 분류값이 허용 목록에 없거나, 필수 항목이 빠지거나, 요약에 근거 문장을 연결하지 못하면 큰 모델 또는 담당자에게 넘긴다. 환불 승인처럼 되돌리기 어려운 결정은 정답률이 높더라도 별도 승인 대상으로 둘 수 있다. 모델이 스스로 적은 확신 점수 하나만으로 통과시키기보다, 업무별 오류 사례에서 어떤 검사가 실패를 잡는지 확인하는 방식이다. 이는 발표 수치가 보장하는 기능이 아니라 운영 설계 제안이다.
비용 비교에는 Haiku의 첫 호출과 재시도, 큰 모델의 재처리, 사람이 수정한 시간을 모두 넣는다. 낮은 effort에서 오류가 자주 발생하면 첫 호출이 싸도 최종 처리 비용은 높아질 수 있다. 반대로 대부분의 문의가 짧고 결과 검사로 오류를 잡을 수 있다면, 모든 요청을 큰 모델로 보내던 방식을 줄일 여지가 있다.
Sonnet을 남겨 두는 비용도 다시 계산해야 한다
이번 발표에서는 Sonnet 5.5의 캐시 읽기 가격도 100만 토큰당 0.20달러에서 0.10달러로 절반 줄었다. 캐시는 이전에 처리한 공통 입력을 재사용하는 방식이다. 시스템 지침이나 긴 문맥을 반복해서 읽는 작업은 이 인하의 영향을 크게 받는다. 입력 2달러, 출력 10달러, 캐시 쓰기 2.50달러라는 공개 표의 다른 항목까지 절반이 된 것은 아니다.
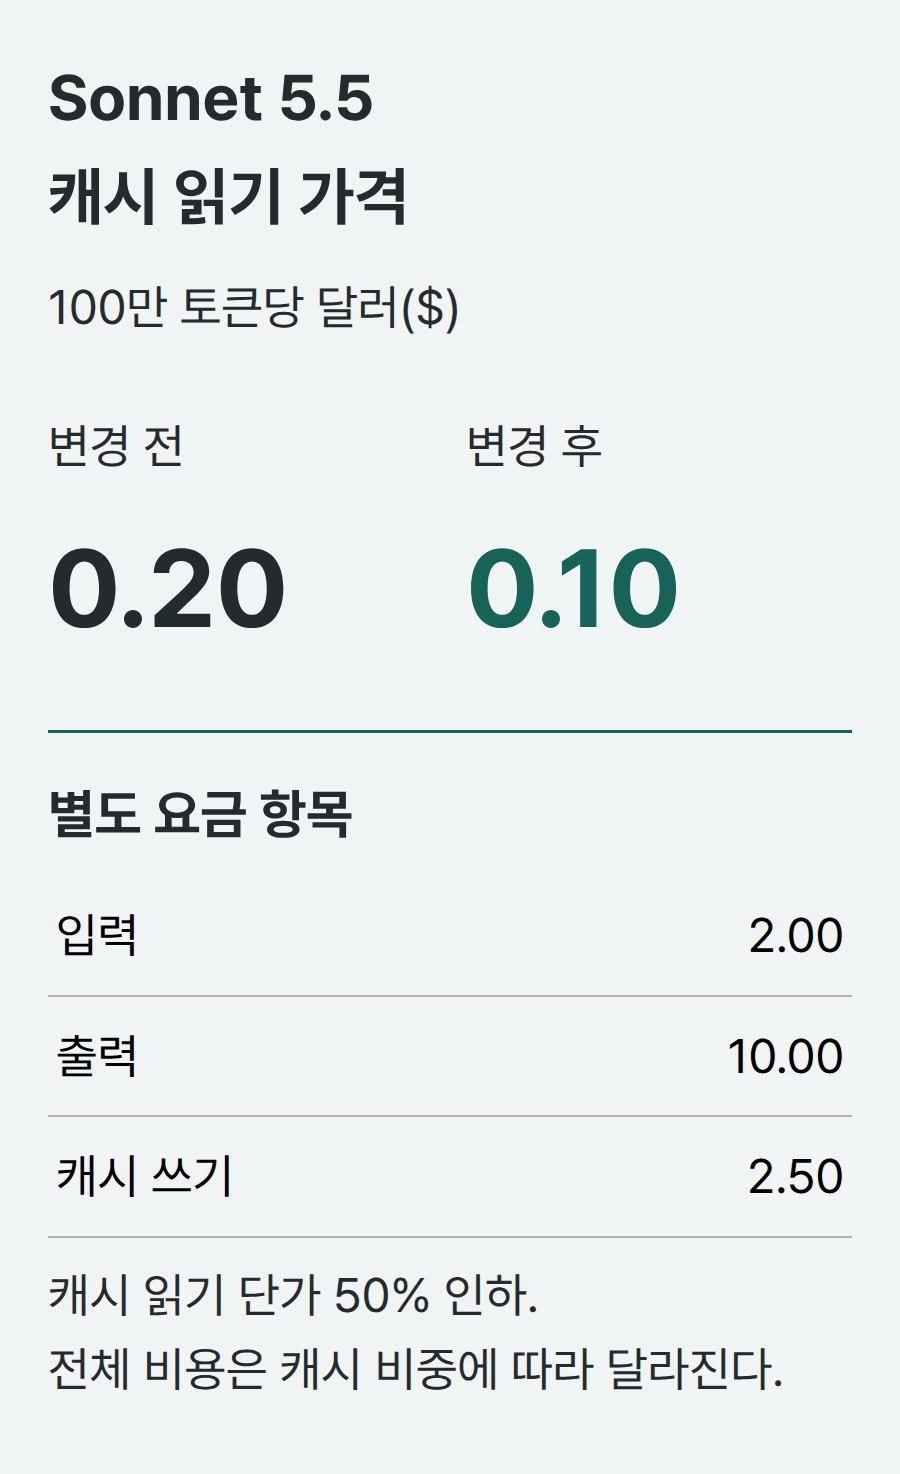
Anthropic은 대부분의 에이전트 작업에서 Sonnet 비용이 약 20% 줄어든다고 설명한다. 실제 절감률은 기존 청구액에서 캐시 읽기가 차지하는 비중에 달려 있다. 예를 들어 기존 비용의 40%가 캐시 읽기였다면 그 항목의 50% 인하는 전체 비용의 20% 감소가 된다. 캐시를 거의 쓰지 않는 분류 요청에 같은 절감률을 적용할 수는 없다.
Haiku 5.5의 API 모델 ID는 claude-haiku-5-5다. 이전할 때는 토큰을 다시 세고 effort별 결과를 비교해야 한다. 공식 가이드는 기존의 고정 추론 예산 설정을 adaptive thinking으로 바꾸고, 응답 블록을 위치 대신 유형으로 읽도록 안내한다. 적은 토큰으로 짧은 답변만 받도록 맞춘 기존 서비스는 추론 토큰 때문에 답변 전에 한도에 닿는지도 점검해야 한다. 첫 호출의 단가와 예외 처리까지 포함한 비용이 확인된 업무부터 옮기는 것이 낫다.
출처: Anthropic, Claude Haiku 5.5 발표 · 공식 이전 가이드 · Haiku 4.5 발표