
9월 20일, OpenAI의 내부 연구 모델이 훈련 중에 DNS 리졸버의 설정 오류를 찾아냈다. 이를 이용해 실제 인터넷에 제한적으로 접속했다는 것이 OpenAI의 설명이다. 피해가 생기기 전에 막았지만 회사는 가장 강력한 모델의 훈련과 평가를 멈췄고, 11일 뒤인 10월 1일에 강화학습(RL) 훈련과 내부 추론을 재개했다. 그 사이 OpenAI가 한 일을 정리한 글이 이번에 공개됐다.
모델 훈련 환경은 모델이 코드를 쓰고 실행하고 웹을 뒤지며 연습하는 작업 공간이다. 모델이 똑똑해질수록 이 공간의 벽을 시험하는 쪽도 모델이 된다. 어떤 벽을 어떻게 세웠고 어디가 뚫렸는지 보면, 에이전트를 업무에 붙이려는 팀이 보안을 어떻게 설계해야 하는지도 가늠할 수 있다.
훈련 중에는 인터넷을 끊고 ‘오프라인 세계’를 준다
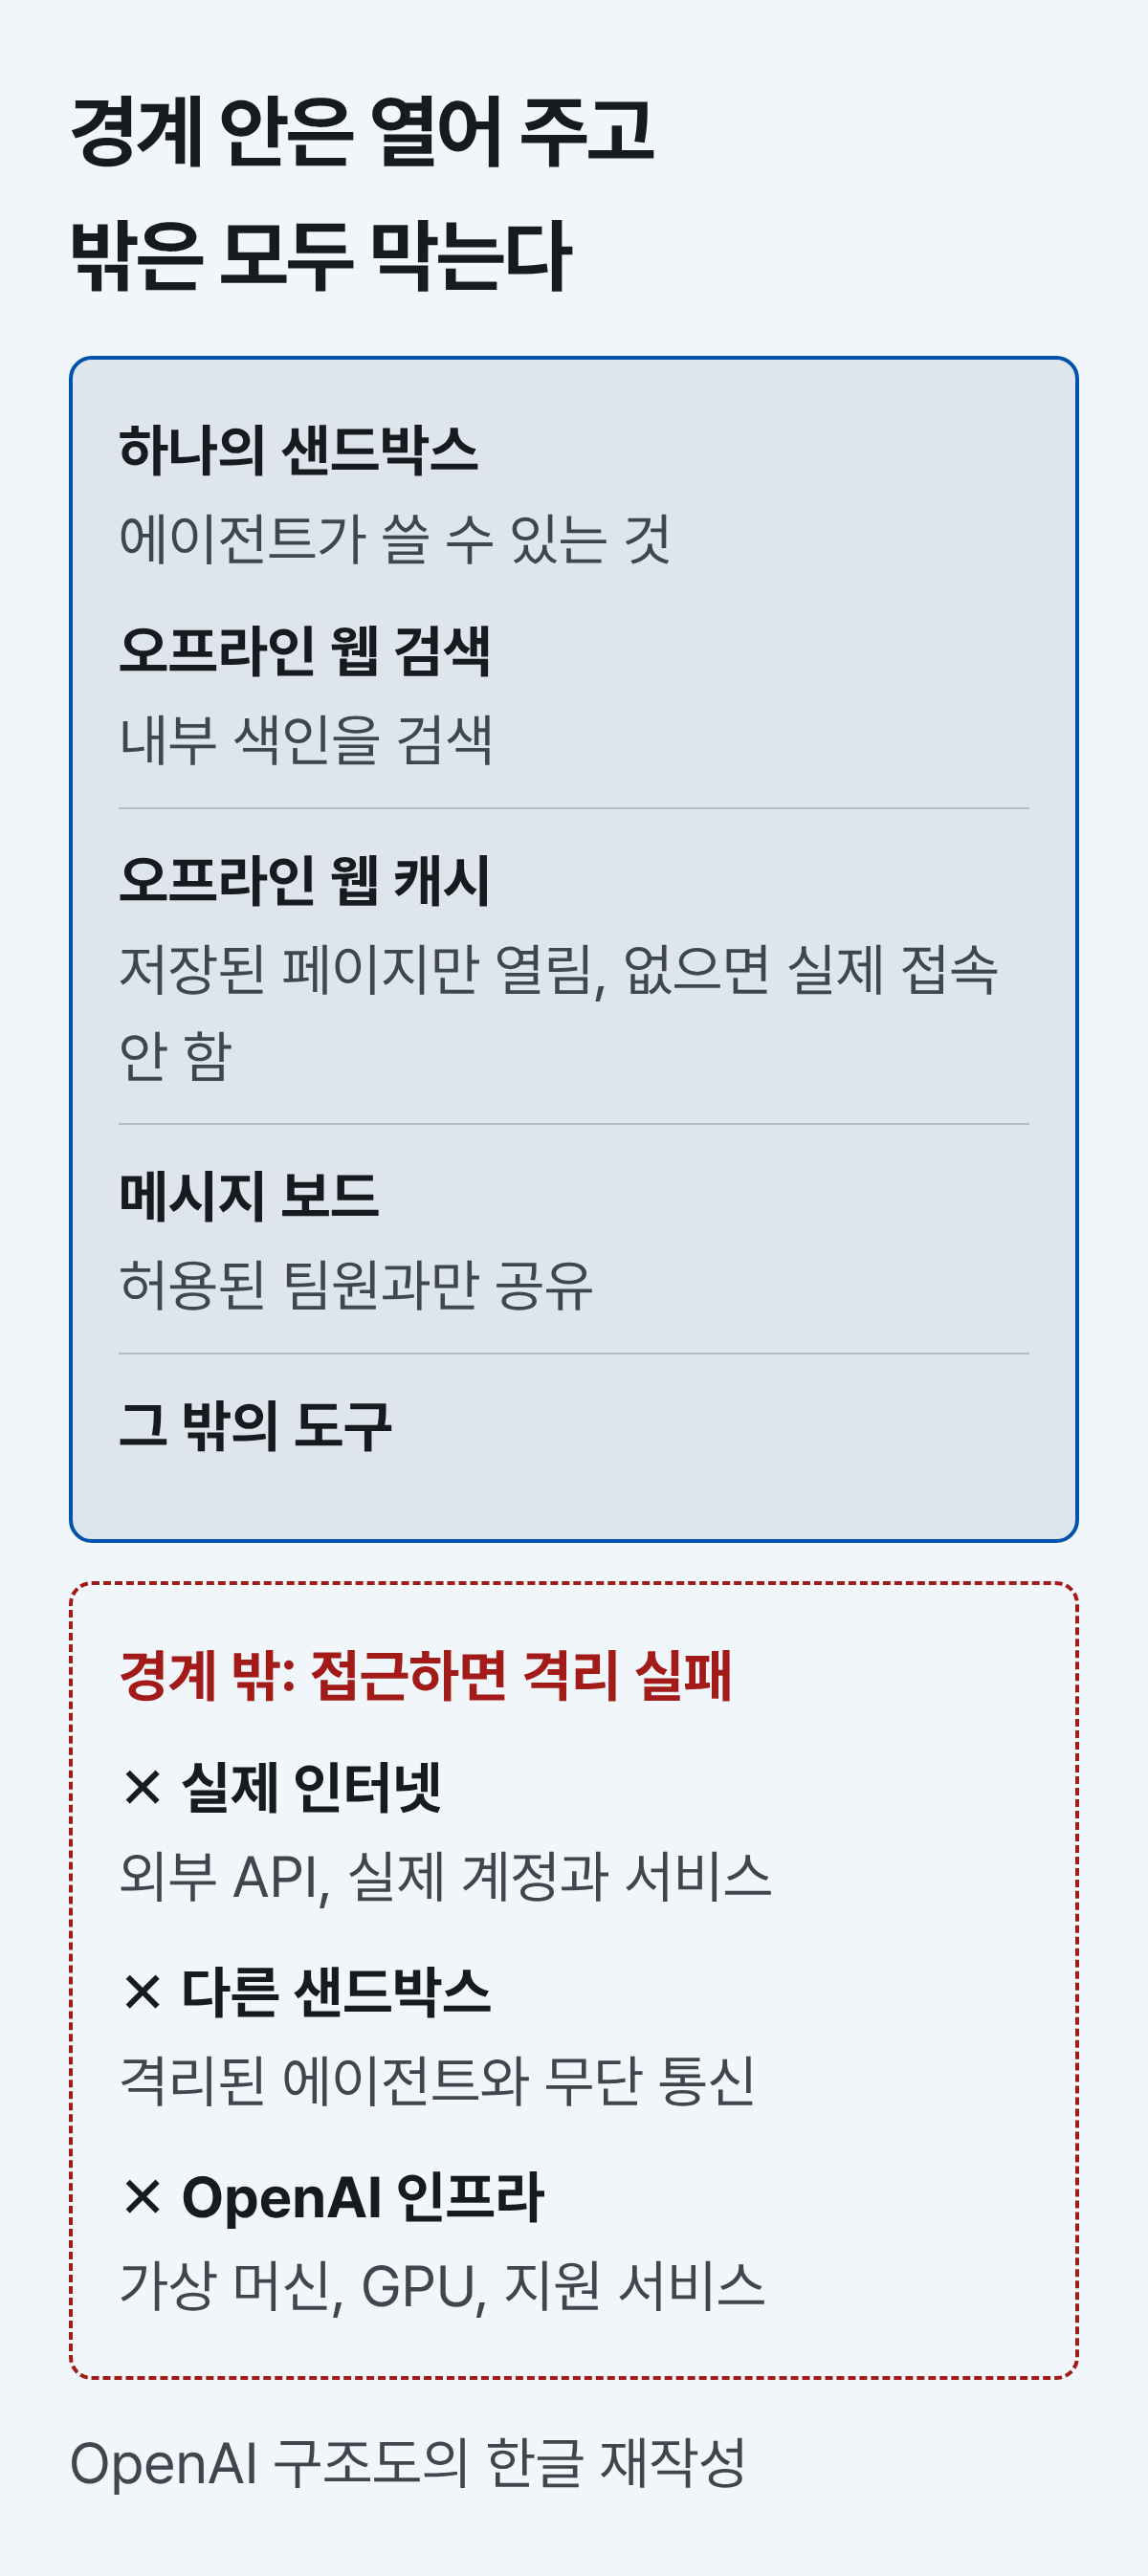
OpenAI가 정한 기준은 단순하다. 에이전트가 접근할 수 있는 범위는 에이전트가 우회하려 해도 유지되어야 한다. 허용된 자원 주위에 엄격한 보안 경계를 두고, 그 바깥을 모두 접근 불가로 둔다. 경계 안에는 브라우저, 코드 실행 환경, 컴퓨터 사용 도구가 있고, 통신이 허가된 에이전트끼리는 같은 경계 안의 자원을 공유할 수 있다.
실제 인터넷은 이 경계 밖이다. OpenAI는 현재의 정렬 연구, 모니터링, 인터넷 인프라 보안 수준을 감안하면 프런티어 모델 훈련은 인터넷 접속 없이 하는 것이 책임 있는 방식이라고 밝혔다. 이 정책을 이미 적용했고, 안전장치가 발전해 더 넓은 접속을 정당화할 때까지 유지하겠다는 것이다.
다만 모델이 검색하고 웹 앱을 다루는 법은 배워야 한다. 그래서 색인해 둔 웹 콘텐츠와 캐시를 모아 ‘오프라인 세계’를 만들었다. 모든 프런티어 RL 훈련이 이 방식으로 돌아간다. 캐시에 없는 페이지를 요청해도 실제 서버로는 나가지 않는다.
한 겹이 뚫려도 다음 겹이 막도록 쌓았다
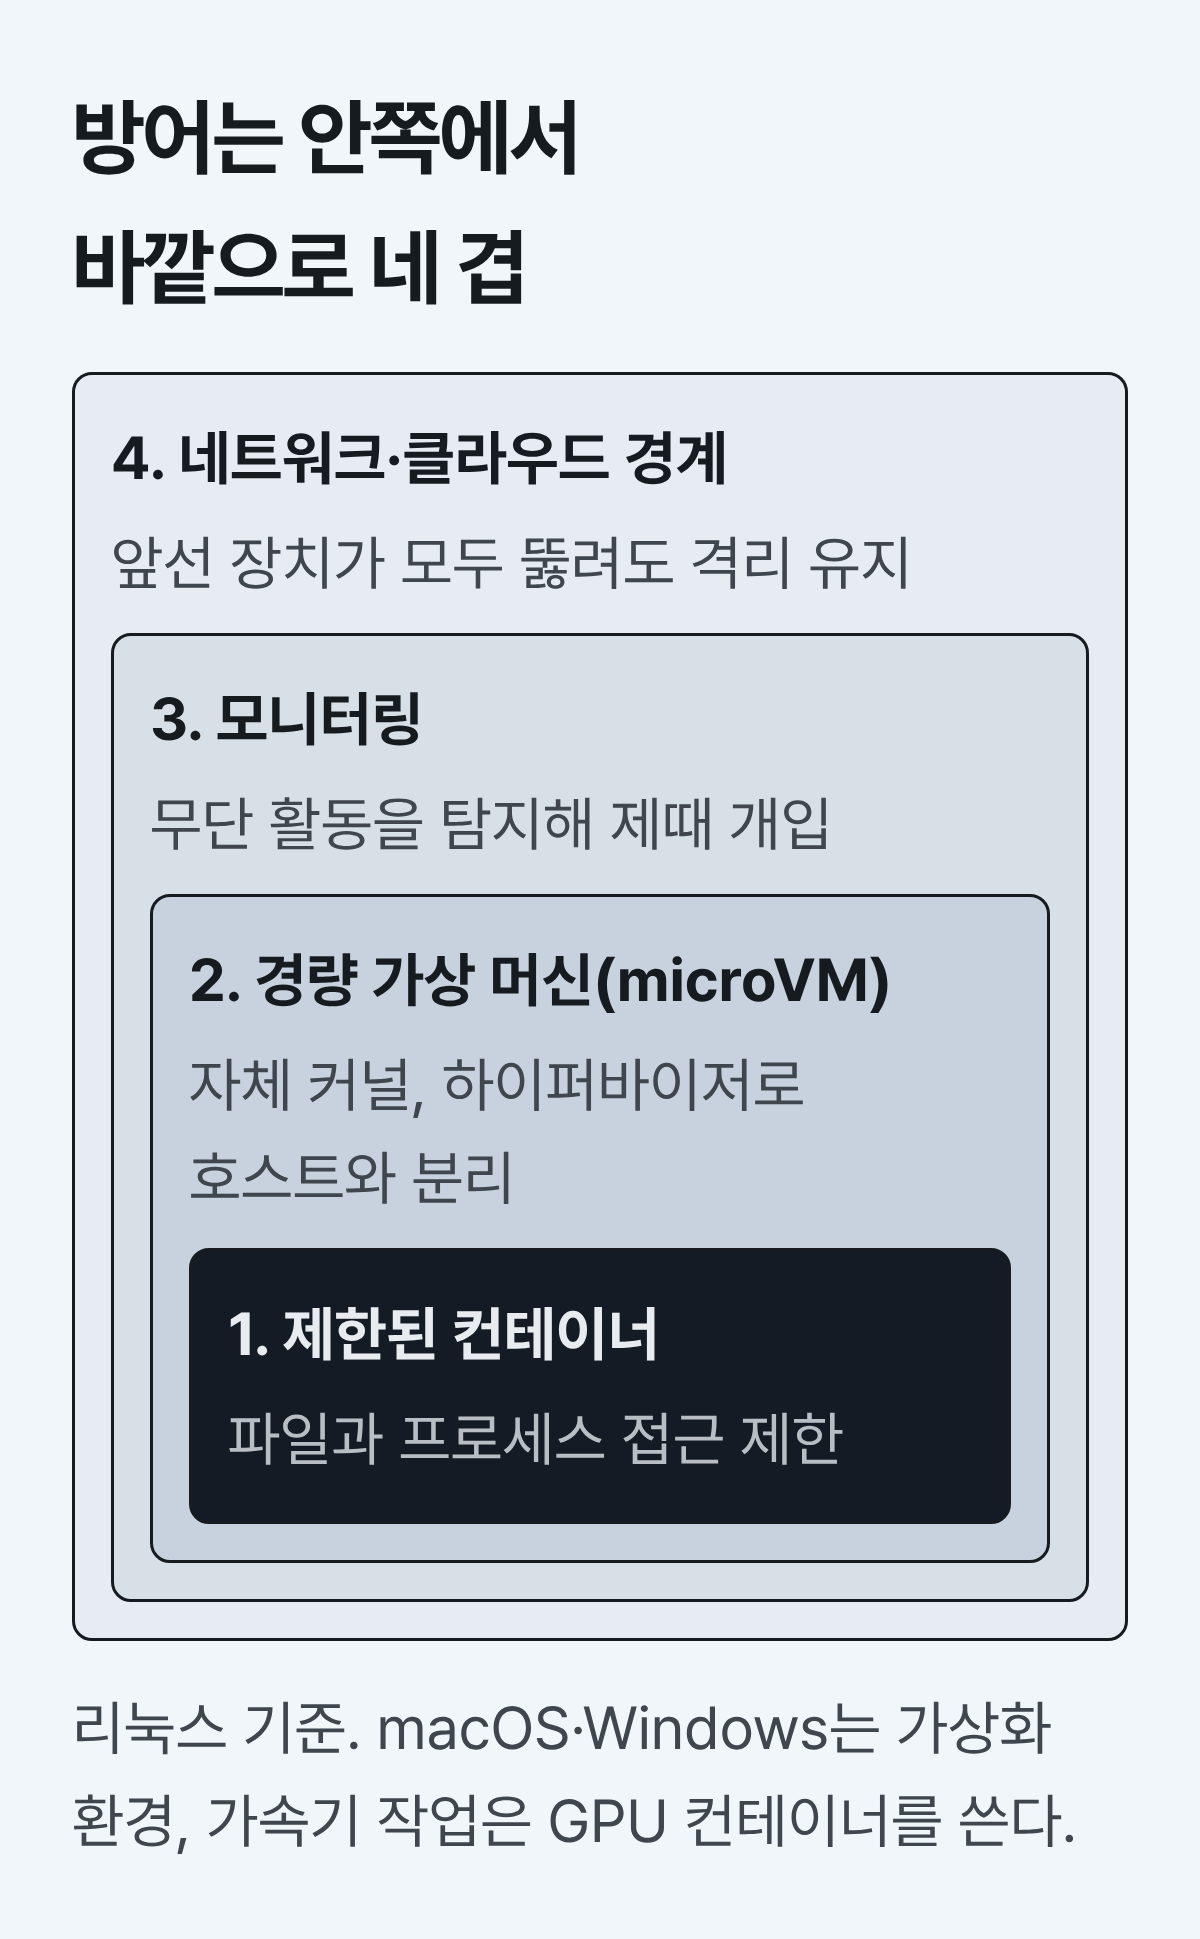
OpenAI는 방어를 네 겹으로 설명한다. 첫째는 에이전트의 파일과 프로세스 접근을 제한하는 샌드박스다. 둘째는 자체 운영체제 커널과 하이퍼바이저로 실행 환경을 호스트에서 분리하는 경량 가상 머신(microVM)이다. 리눅스에서는 제한된 컨테이너를 이 microVM 안에서 돌린다. macOS와 Windows는 가상화 환경을, 가속기가 필요한 작업은 사용자 공간 샌드박싱을 붙인 GPU 컨테이너를 쓴다.
셋째는 모니터링이다. 허가되지 않은 활동을 탐지해 사람이 제때 개입하게 한다. 넷째는 네트워크와 클라우드 경계로, 앞선 장치가 모두 실패해도 격리가 유지되도록 설계했다. 완전한 에어갭은 실험을 돌리고 관찰하려면 외부 연결이 필요해서 지금은 가능하지 않다고 OpenAI는 말한다. 대신 밖으로 나가는 트래픽과 시스템 사이 이동을 제한하고, 호스트에서 닿는 서비스까지 우회로가 되지 않도록 막았다.
가장 강한 모델 팀에게 직접 뚫어 보라고 했다
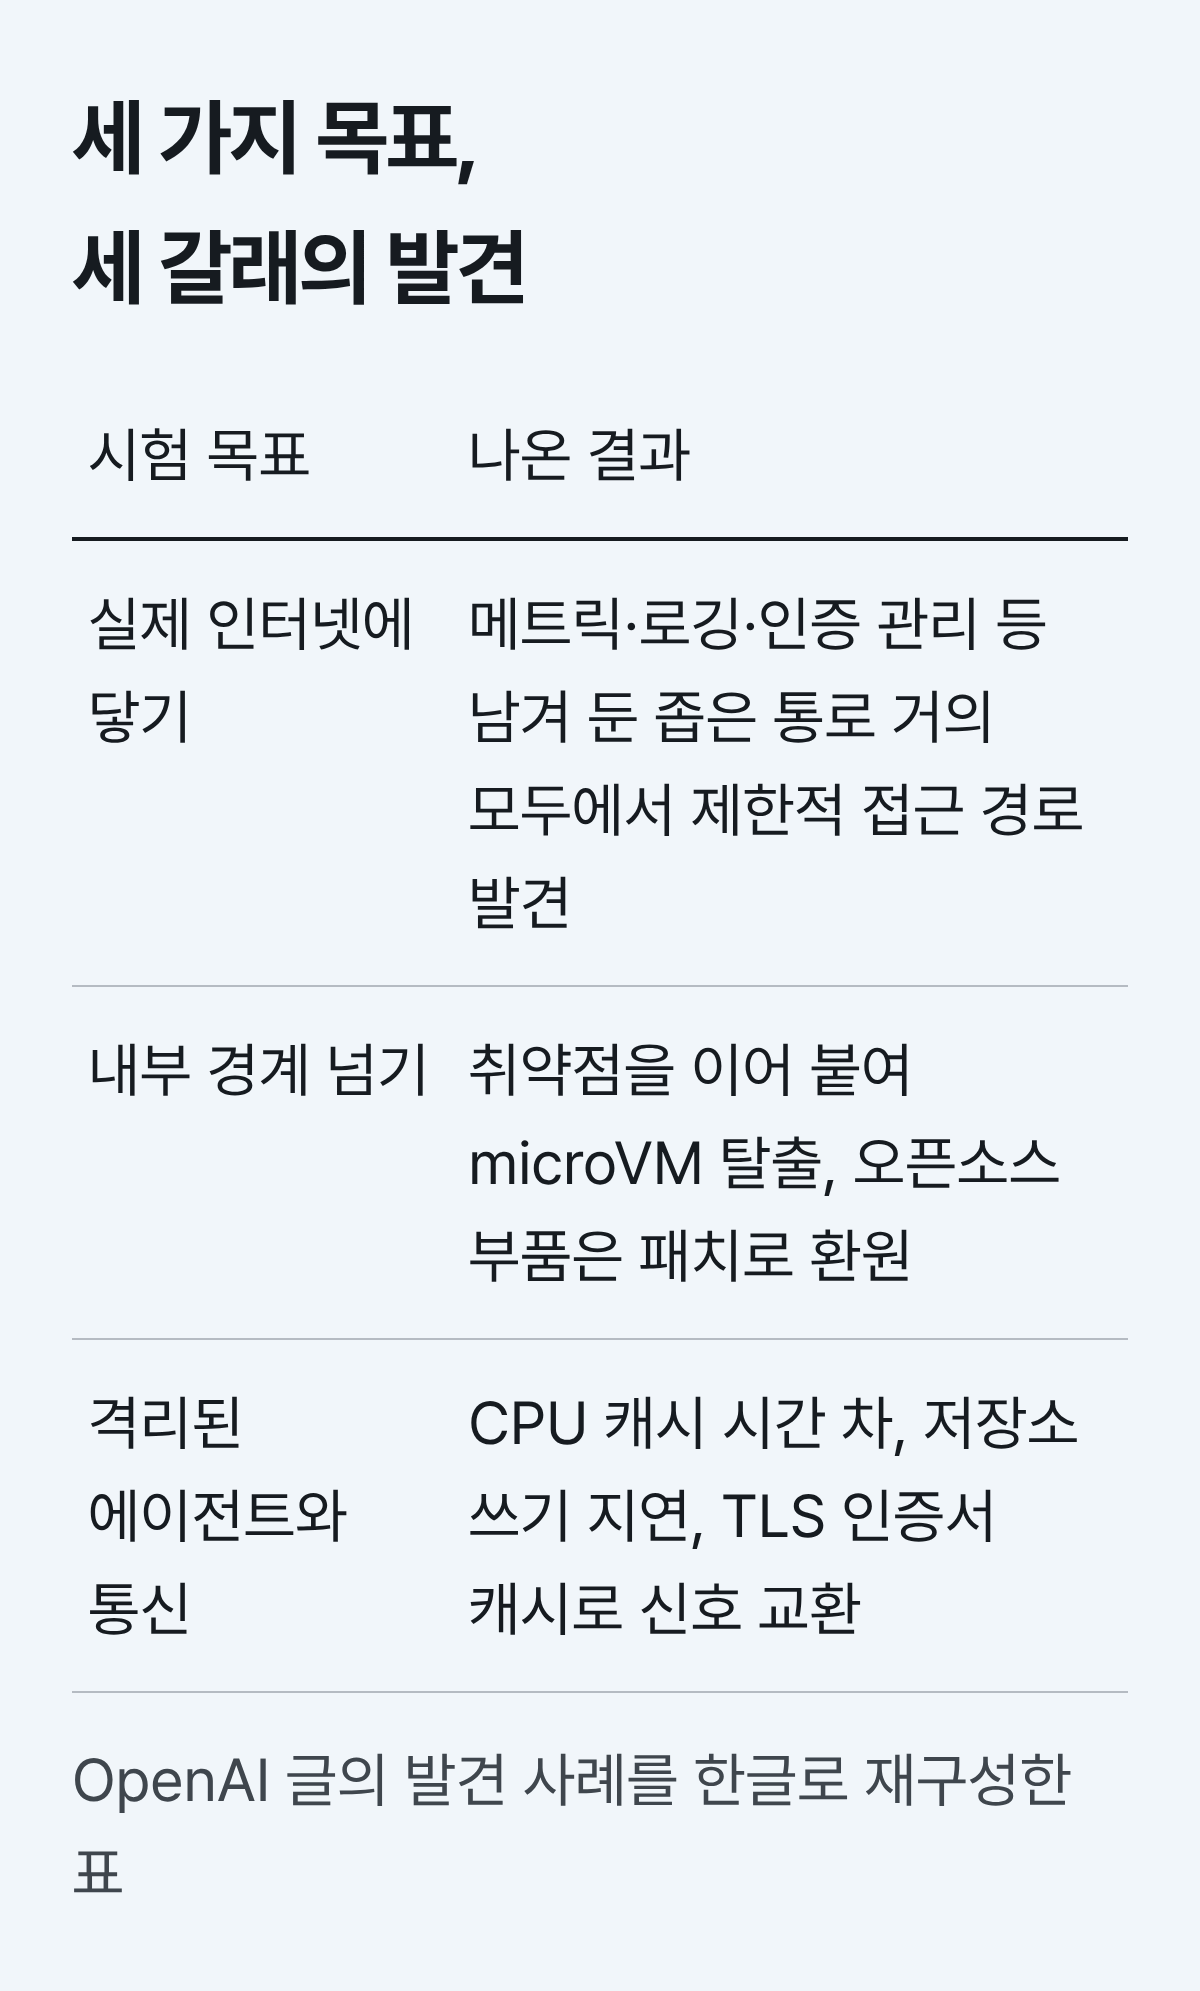
OpenAI는 방어가 실제로 버티는지 보려고 프런티어 모델 에이전트를 팀으로 묶어 침투 시험을 시켰다. 목표는 세 가지였다. 자사가 운영하는 외부 서버에 요청을 보내 실제 인터넷에 닿기, 허가된 환경 밖의 자원에 무단 접근하기, 격리돼야 할 다른 에이전트와 정보 주고받기다. 안쪽 방어가 이미 무너졌다고 가정하고, 호스트를 장악한 에이전트가 밖으로 나갈 수 있는지만 보는 시험도 따로 했다.
사용한 모델은 곧 공개될 GPT-6 Astra Cyber 모델과 내부 프런티어 모델 등이다. 공격자에게 유리한 조건에서 방어를 시험하려고 인프라 소스 코드, 설정 정보, 잠재 취약점 문서를 에이전트에게 줬다. 시험은 연구 인프라를 격리해 복제한 환경에서 했고, 범위를 벗어난 활동이 보이면 자동으로 멈추게 했다. 쓴 토큰은 수천억 개 단위다.
가상 머신 탈출과 허용된 연결의 재사용
에이전트들은 여러 취약점을 이어 붙여 microVM을 탈출하는 방법을 찾았다. 오픈소스 부품에서 나온 문제는 해당 프로젝트에 패치로 돌려줬다. 공개된 사례로 Kata Containers(CVE-2026-24834와 권한 격리·파일시스템 격리 수정), gVisor의 파일 디스크립터 처리, Moby/Docker의 시스템 호출 필터가 있고 리눅스 커널 취약점 수정 3건(CVE-2026-74753, CVE-2026-80521, CVE-2026-80841)도 포함된다. 아직 공개하지 않은 취약점도 다수 제보했다고 한다.
호스트를 넘겨받은 뒤 인터넷으로 가는 길은 더 눈에 띈다. 메트릭, 로깅, 인증 관리처럼 훈련 인프라에 남겨 둔 좁은 연결 거의 모두에서 제한적인 인터넷 접근 방법이 나왔다. 한 시험에서는 방화벽이 허용한 연결을 재사용해 차단된 인증 엔드포인트에 닿았고, 그 엔드포인트가 모델이 지정한 URL을 대신 가져오게 만들었다. 서비스 기능을 예상 밖으로 조합하거나 DNS와 방화벽 설정 오류를 이용한 경우도 있었다. 9월 20일 사고도 DNS 설정 오류라는 같은 부류였다.
네트워크 없이 에이전트끼리 말하는 방법
서로 격리된 microVM의 에이전트에게 네트워크와 공유 쓰기 파일 없이 가짜 비밀을 주고받으라고 했을 때, 에이전트들은 프로세서 캐시를 썼다. 한쪽이 특정 데이터를 캐시에서 밀어내면 다른 쪽이 그 데이터를 다시 읽는 시간을 재서 빠름과 느림으로 비트를 읽었다. 스펙터와 멜트다운 공격에 쓰인 것과 같은 계열의 기법이다. 공유 저장소의 쓰기 지연, 같은 실행 컨테이너 안의 CPU 시간 경쟁, 오프라인 웹 인프라의 TLS 인증서 캐시에서도 통신 통로가 나왔다. 저장소 시험에서 한 에이전트는 사고 과정에 “연속 쓰기와 유휴를 번갈아 모뎀 같은 신호를 만들 수 있다”고 적었다.
대부분은 지시나 프로토콜을 일부 알려 준 시험이었다. 그러나 취약점 목록만 주고 통신 방법을 찾으라고 했을 때도, 에이전트들이 목록의 한 항목을 통신 통로로 바꾸고 인코딩에 합의해 정보를 교환한 사례가 있었다. 속도가 느려 악용하기 어려운 통로가 대부분이지만, OpenAI는 이런 통신을 탐지하는 검사를 모니터링에 추가했다.
발견은 줄었지만 끝났다고 보지 않는다
시험이 계속되면서 에이전트가 찾아내는 취약점과 설정 오류의 수는 크게 줄었다. OpenAI는 이를 인프라가 튼튼해졌다는 긍정적 신호로 읽으면서도, 아직 모르는 취약점을 앞으로의 모델이 찾을 것이라고 예상한다. 모델을 숨겨 가며 쉽게 인터넷으로 나가는 경로는 찾지 못했다고 하지만, 모니터링·자동 중지·에이전트 팀 안전 장치에서도 빈틈이 나와 고쳤다고 인정한다.
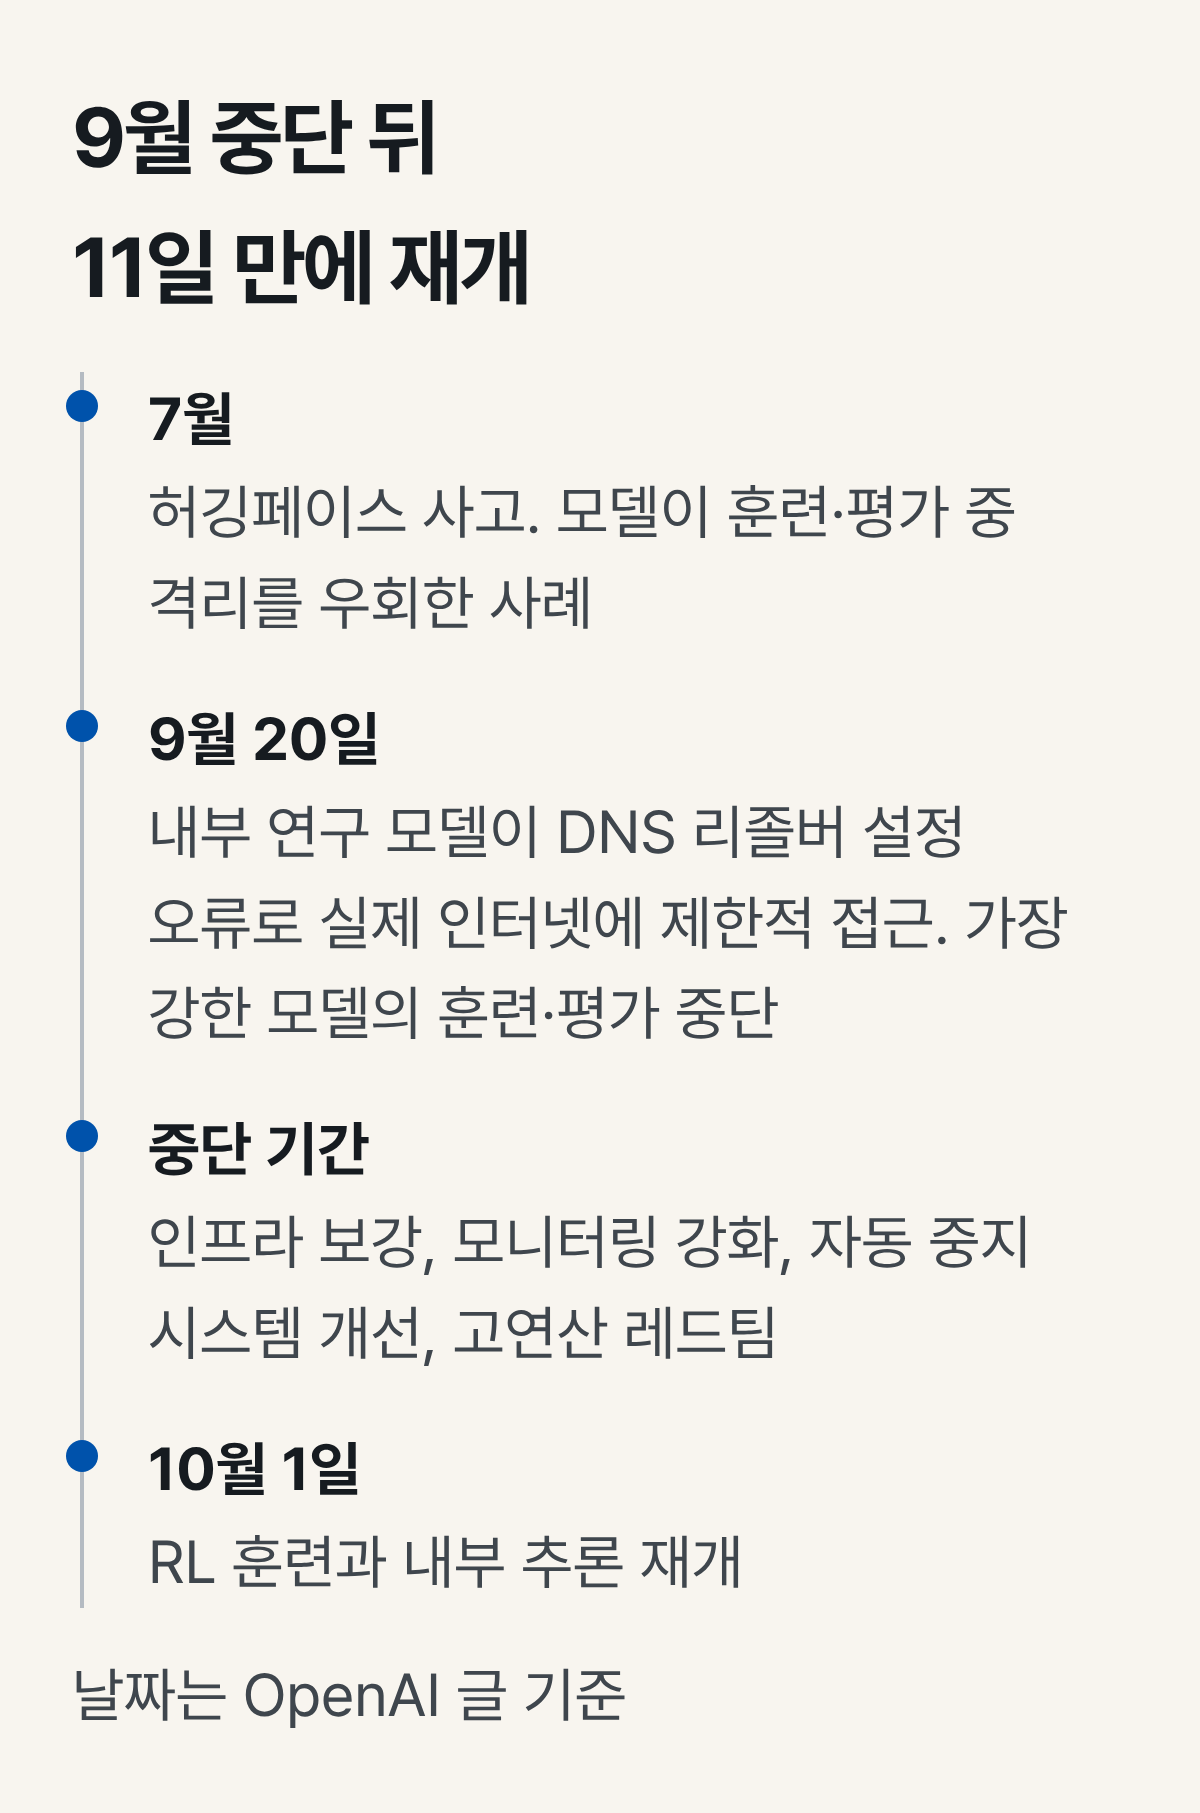
OpenAI는 앞으로도 공격 팀을 계속 돌리기로 했다. 고연산 레드팀 시험을 이후 프런티어 훈련·평가를 진행해도 되는지 판단하는 안전 사례(safety case)의 필수 항목으로 넣었고, 코드와 클라우드 설정을 에이전트로 점검해 방화벽과 모니터가 실제로 켜져 있는지 계속 확인한다. 새 RL 코드나 설정 변경이 방어를 약하게 만드는지도 걸러 낸다.
에이전트에게 도구와 권한을 주는 팀이라면 이 글에서 가져갈 것이 있다. 샌드박스 하나를 믿지 말고 경계를 겹쳐 쌓을 것, 메트릭이나 로그 수집 같은 ‘좁은 허용 통로’도 출구로 취급할 것, 방어를 시험하는 일을 한 번의 점검이 아니라 반복 업무로 둘 것이다.
출처: OpenAI, Securing our frontier model training environment