
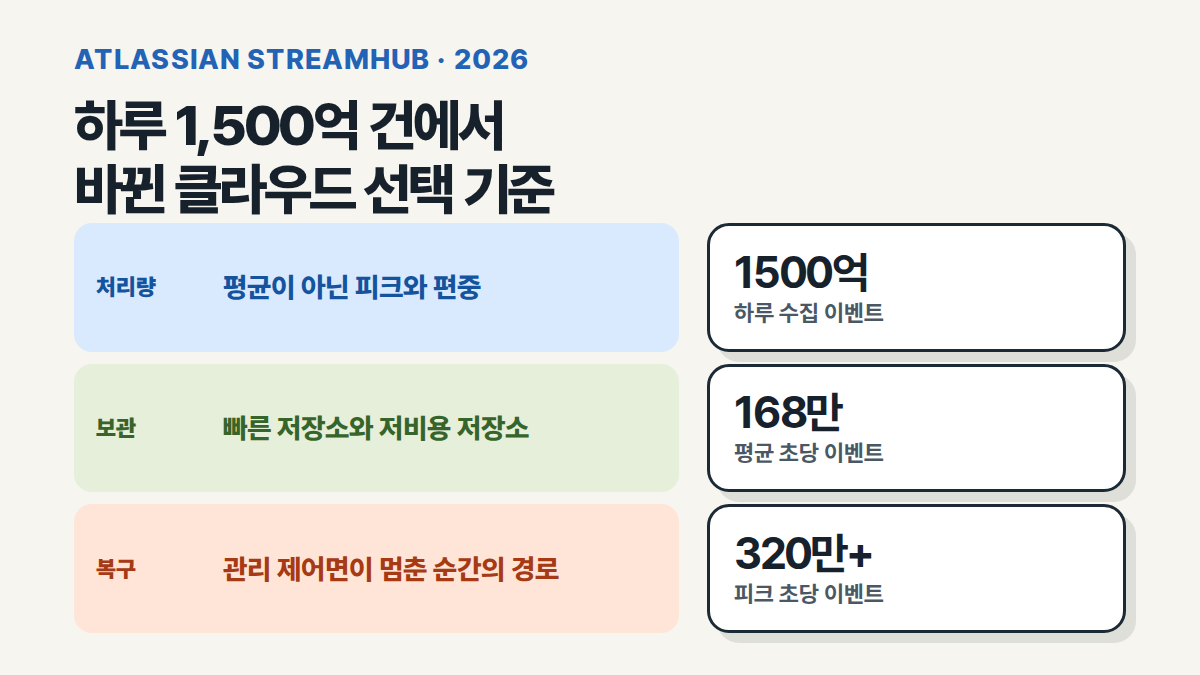
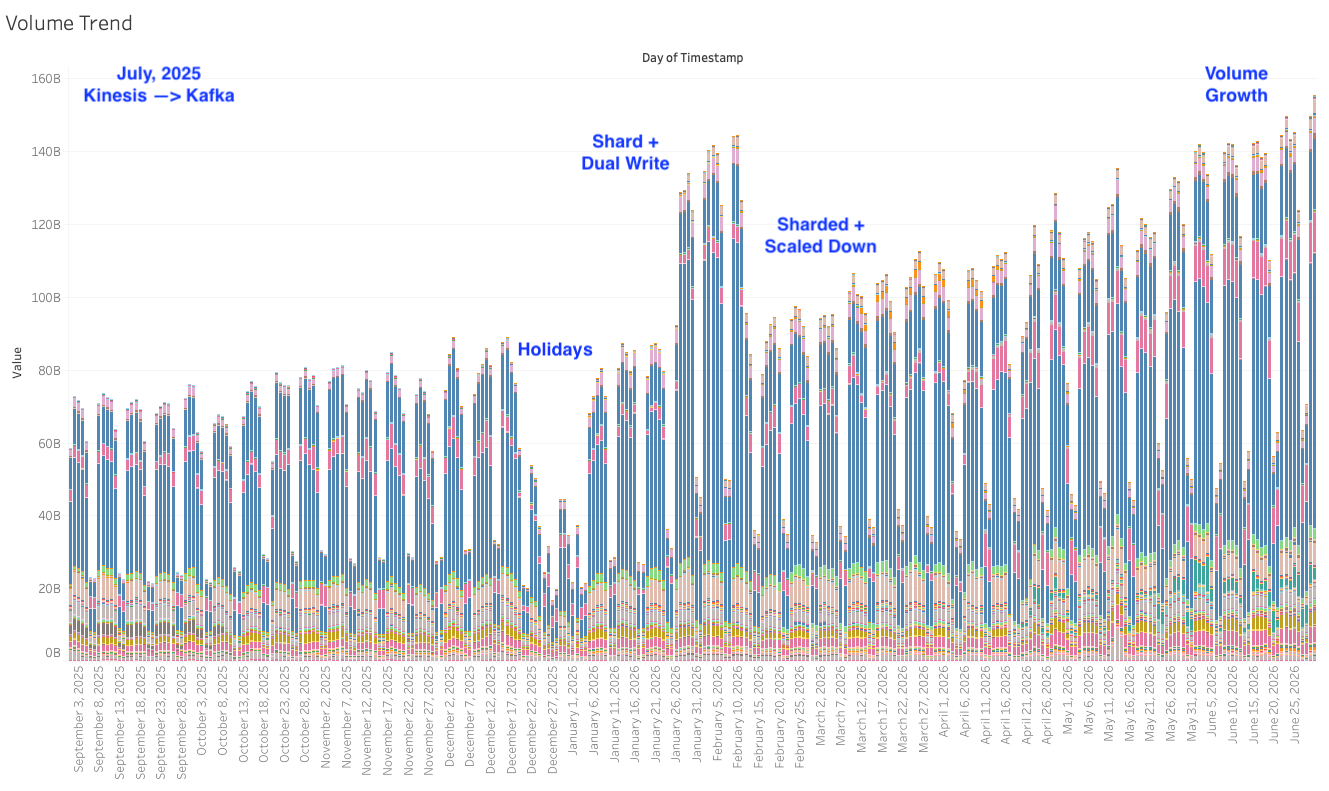
Atlassian은 2026년 7월 28일 자사 이벤트 플랫폼 StreamHub가 하루 1,500억 건을 수집하고 2,250억 건을 전달한다고 공개했다. 평균은 초당 약 168만 건, 피크는 초당 320만 건을 넘는다. 이 수치가 중요한 이유는 단지 Kafka가 Kinesis보다 낫다는 결론 때문이 아니다. 이 규모에서는 클라우드 서비스를 고르는 기준이 기능 목록이나 평균 비용에서, 가장 바쁜 브로커·보관 계층·장애 때 쓸 회복 경로로 옮겨간다.
StreamHub는 클릭, 노출, API 호출, 변경 데이터 캡처(CDC), 텔레메트리를 실시간으로 흘려보낸다. Atlassian은 예전의 하루 220억 건에서 현재 규모로 커지면서, 관리형 서비스가 일상적인 운영 부담을 줄여도 병목과 복구 결정을 없애 주지는 않는다는 경험을 얻었다.
Kinesis의 문제는 전송량 하나가 아니었다
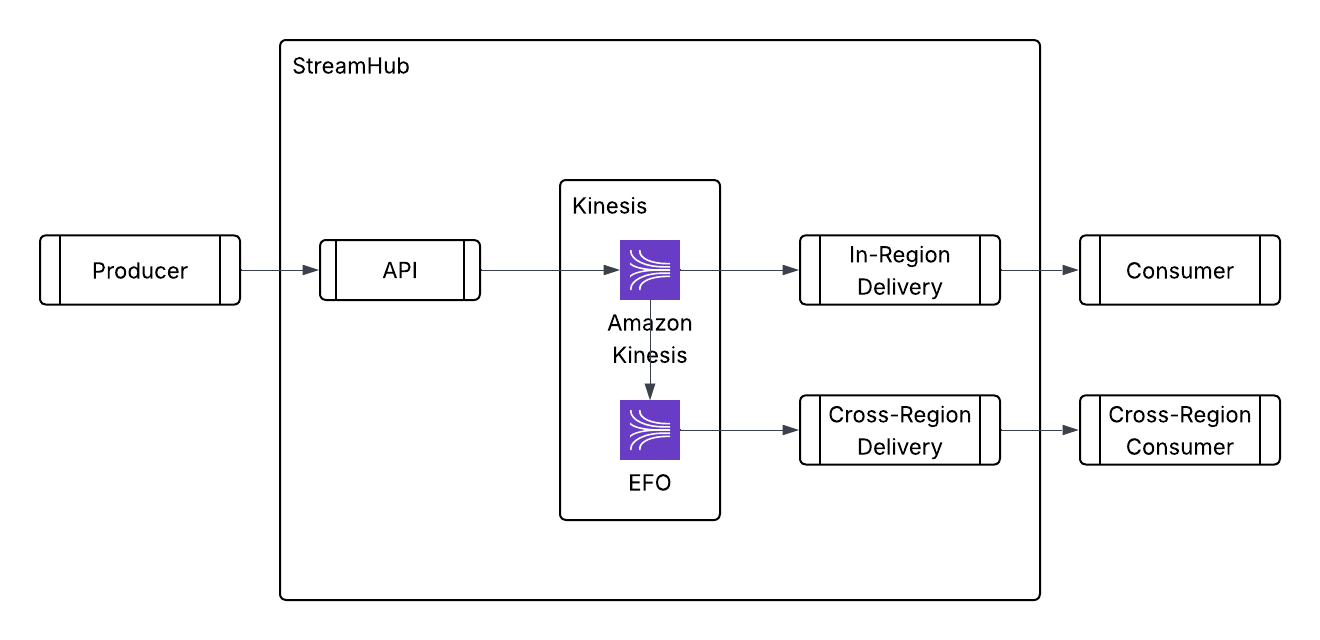
Atlassian은 Kinesis가 하루 200억~300억 건 수준까지는 운영 부담이 작은 수집 계층으로 잘 작동했다고 설명한다. 그러나 피크 처리량을 맞추려면 샤드를 계속 늘려야 했다. 원문이 제시한 샤드당 한도는 수집 초당 1MB, 전송 초당 2MB다. 활성 샤드 수에 크게 좌우되는 비용 구조에서는 트래픽이 늘수록 월 비용도 거의 직선으로 늘어난다.
소비자 쪽도 같은 샤드의 전송 용량을 나눠 쓴다. StreamHub는 지역 내 전달 2초 미만, 지역 간 전달 3초 미만을 목표로 했고, 고용량·저지연 소비자를 위해 Enhanced Fan-Out(EFO)을 사용했다. 여러 독립 소비자 그룹과 긴 보관 기간이 필요한 상황에서는 API, 샤드, 소비자 전달, 보관 비용이 한꺼번에 얽힌다.
Kafka 전환이 바꾼 것은 저장소의 역할이다
Atlassian은 이 조건에서 Apache Kafka를 선택하고, 인프라 운영 부담을 줄이기 위해 AWS MSK를 사용했다. 작은 플랫폼 팀이 서버 패치나 장애 하드웨어 교체보다 스트림 구조, 클라이언트 라이브러리, 신뢰성에 집중하려는 선택이었다. Kafka는 소비자 그룹이 늘어도 Kinesis처럼 같은 샤드 전송량을 직접 나눠 쓰지 않으며, 며칠 단위 보관과 여러 클라우드로의 확장 가능성도 열었다.
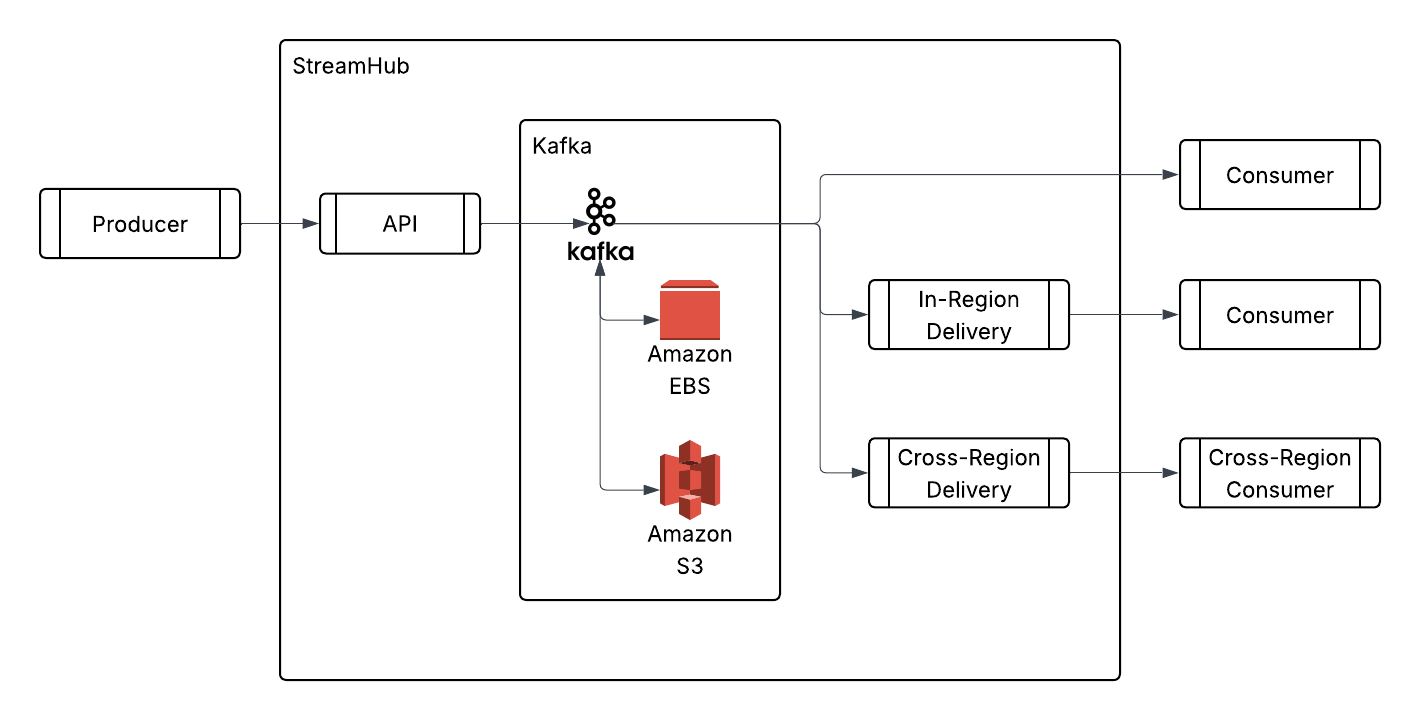
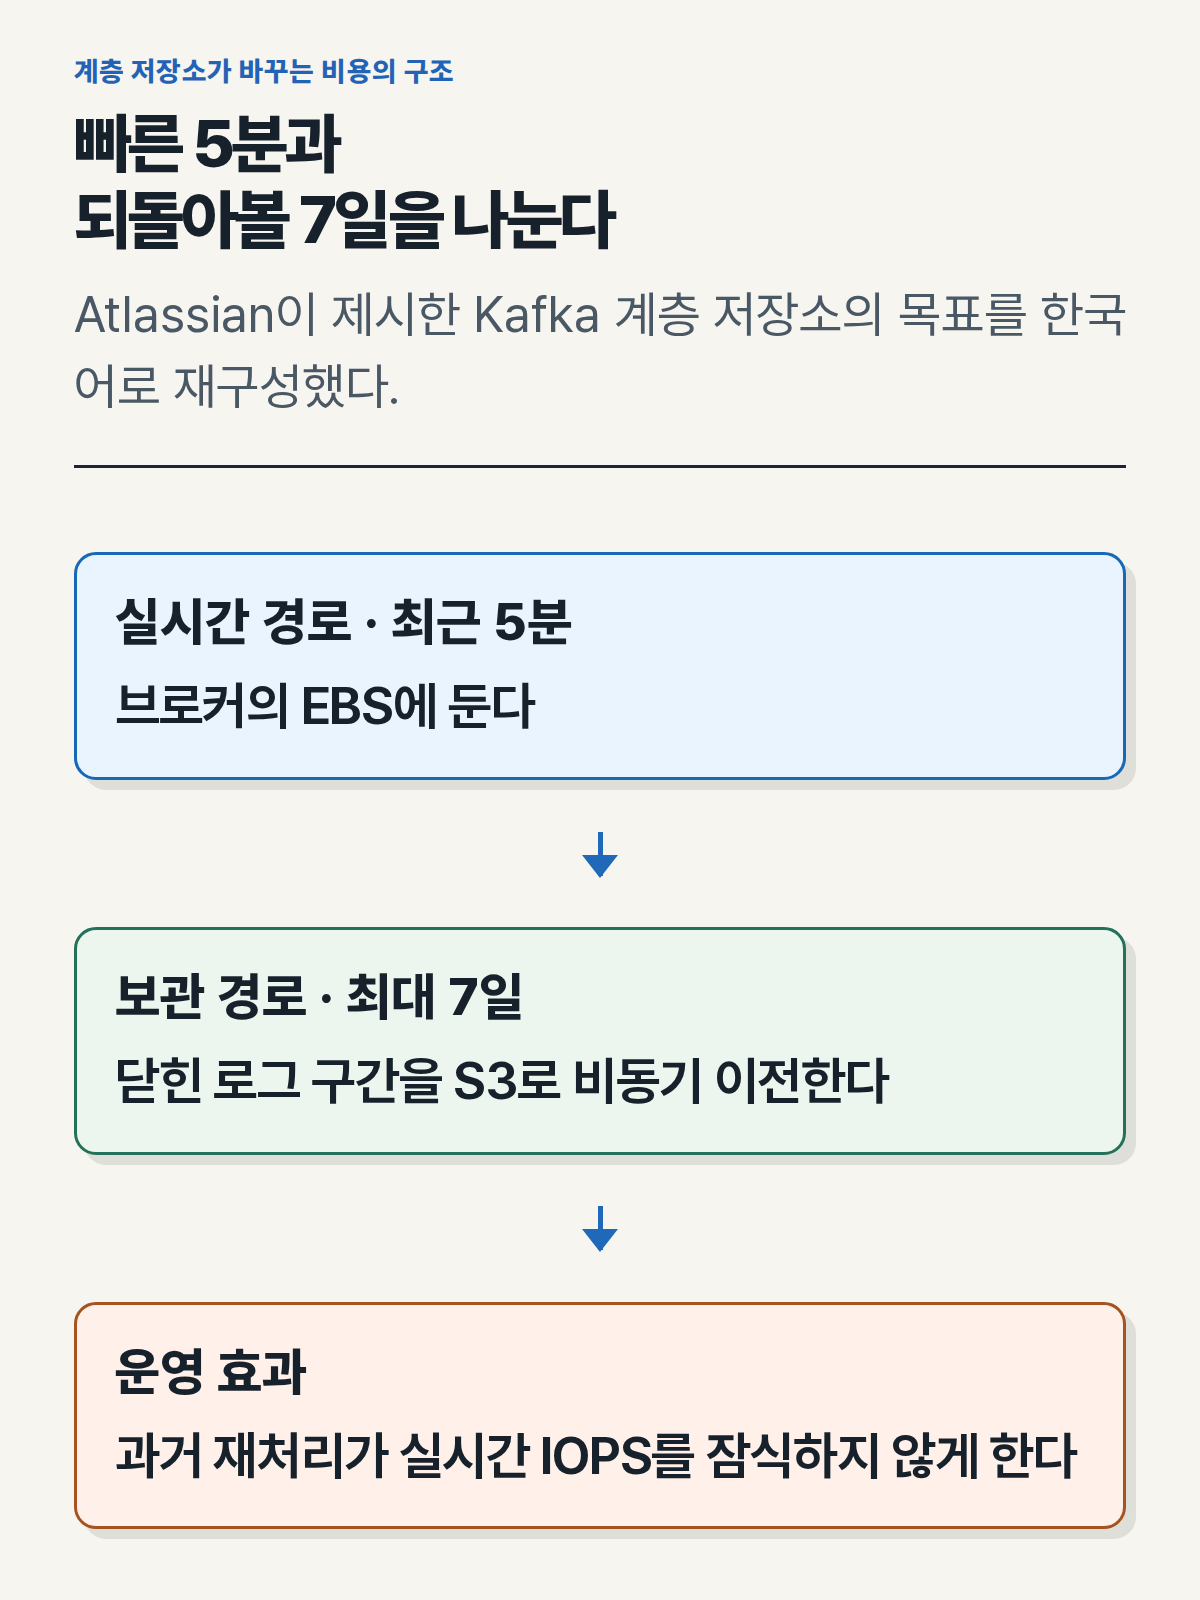
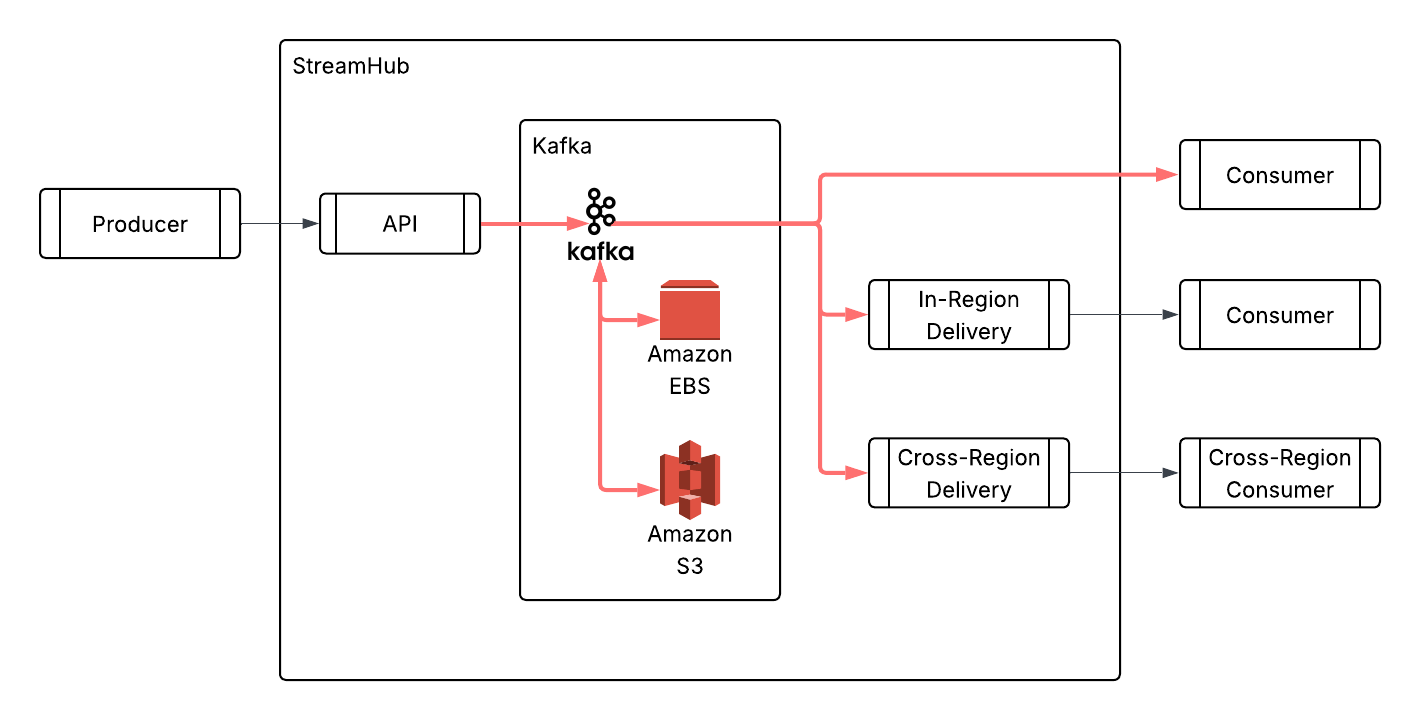
핵심은 계층 저장소였다. 최근 5분의 뜨거운 데이터는 브로커의 EBS에 두고, 닫힌 로그 구간은 S3로 비동기 이전해 최대 7일을 보관했다. 몇 분 이상 뒤처진 소비자의 과거 읽기는 S3에서 발생하므로, 대규모 재처리가 실시간 소비자의 IOPS를 빼앗지 않는다. 고성능 디스크를 최악의 보관 기간만큼 미리 사 두지 않아도 되는 구조다.
저비용 보관은 로컬 여유 용량을 대신하지 않는다
계층 저장소는 데이터가 먼저 로컬에 기록된 뒤 백그라운드 작업자가 S3로 옮기는 방식이다. 쓰기, 복제, 소비자 읽기, 원격 복사가 같은 브로커 자원을 경쟁한다. 원격 복사가 밀리면 옮겨야 할 데이터가 로컬 디스크에 계속 쌓인다. Atlassian은 7일 보관을 조사 목적으로 21일까지 늘렸다가 다시 7일로 낮춘 때, 대량 삭제 요청이 평소 원격 쓰기와 경쟁해 복사를 늦추고 로컬 디스크 사용량을 빠르게 올린 사례를 들었다.
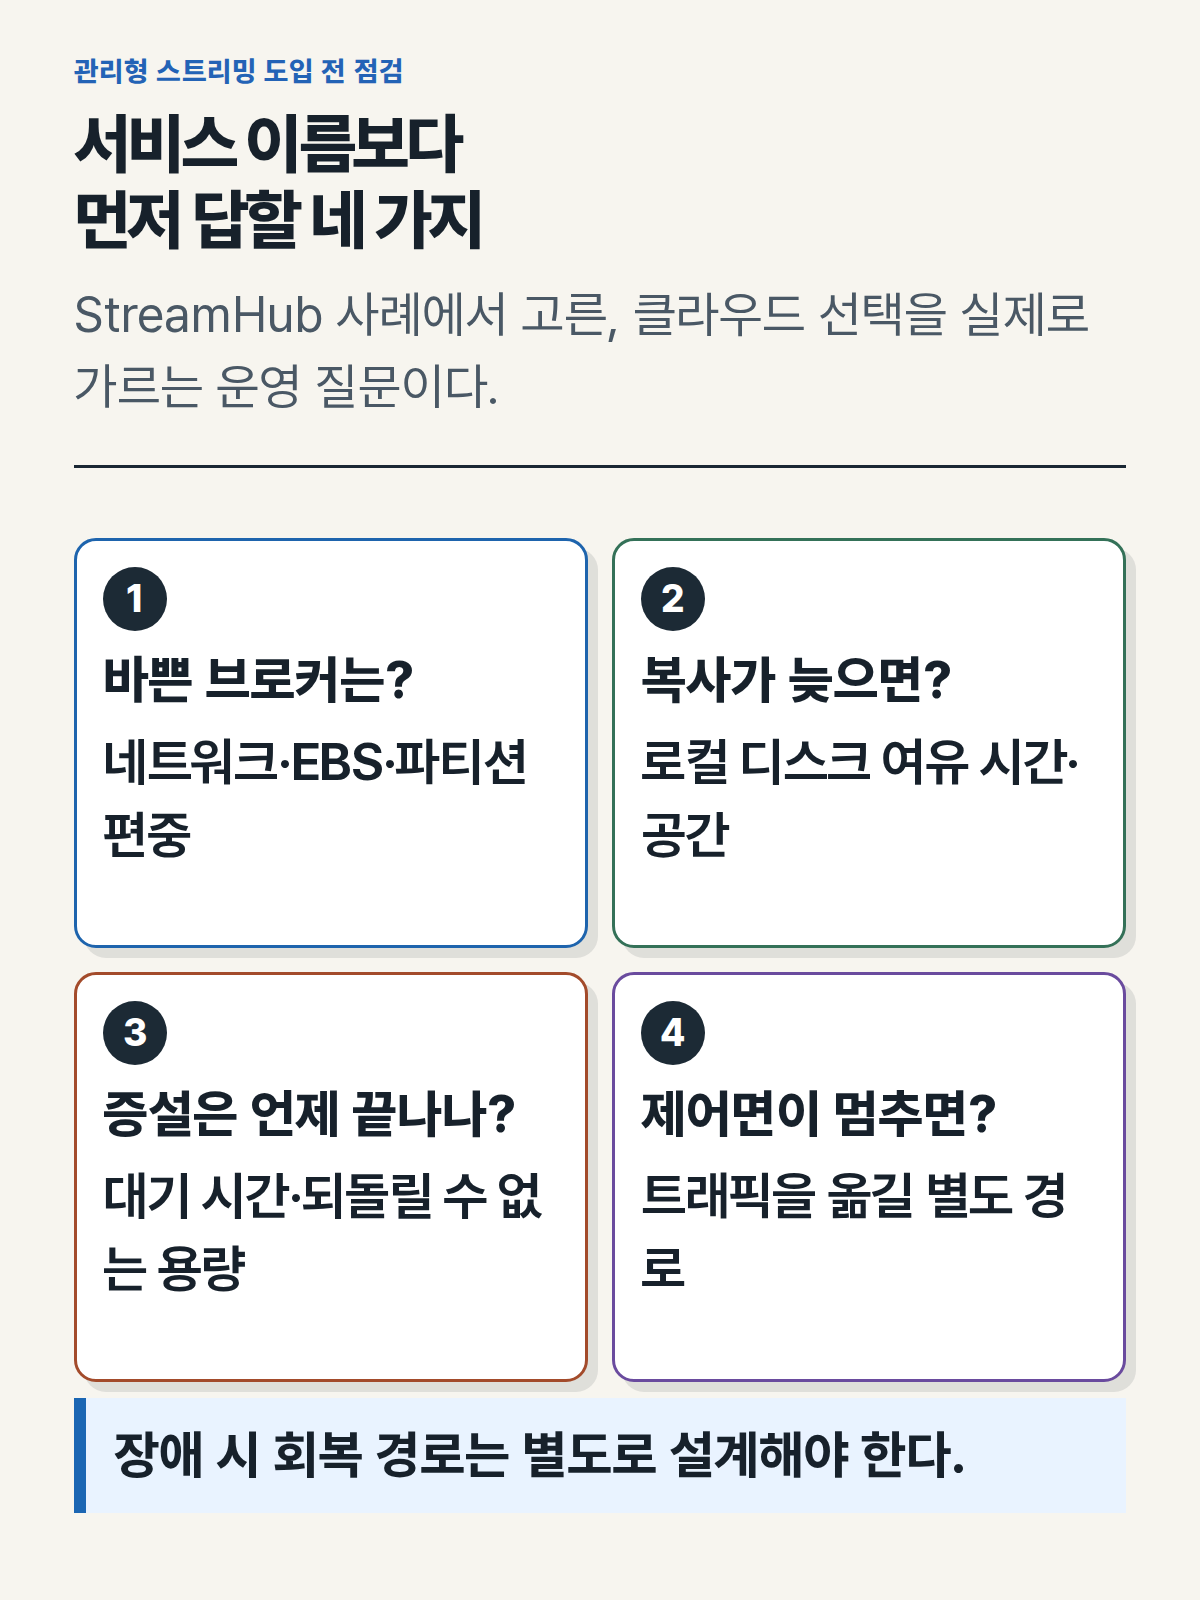
그래서 팀은 CPU 평균만으로 브로커를 고르지 않는다. 브로커별 수신·송신 바이트, EBS 처리량, 디스크 증가, 원격 복사 지연, 파티션 편중, 소비자 지연을 함께 본다. 유휴 용량은 낭비가 아니라 피크와 재시도, 장애 조치 트래픽을 흡수하는 신뢰성 기능이 된다.
관리형 서비스의 마지막 경계는 제어면이다
장애 때는 확장 자체가 충분히 빠른 해결책이 아닐 수 있다. 원문에 따르면 MSK 디스크 증설에는 다음 변경 전 대기 구간이 생길 수 있고, 늘린 디스크는 줄일 수 없다. 인스턴스 상향은 브로커별 순차 재시작이 필요하며, 새 브로커를 더해도 파티션과 리더를 재배치하기 전에는 뜨거운 토픽의 부담이 그대로 남는다.
가용 영역 장애 때 데이터 평면이 남아 있어도 관리 제어면의 상태가 부정확해지면 재시작, 확장, 디스크 증설, 자동 재배치가 막힐 수 있다. Atlassian은 이 경계를 줄이기 위해 큰 클러스터를 여러 샤드로 나누고, 심각한 열화가 지속되면 별도 Kafka 클러스터를 병렬로 준비하는 장애 조치 런북을 마련했다. 클라우드 선택에서 확인할 질문은 ‘관리형인가’가 아니라 ‘관리 기능이 막힌 순간에도 어디로 트래픽을 옮길 수 있는가’가 된다.
출처: Atlassian, “Scaling StreamHub: Transitioning from Kinesis to Kafka for 145 Billion Daily Events” (2026-08-10 확인)