
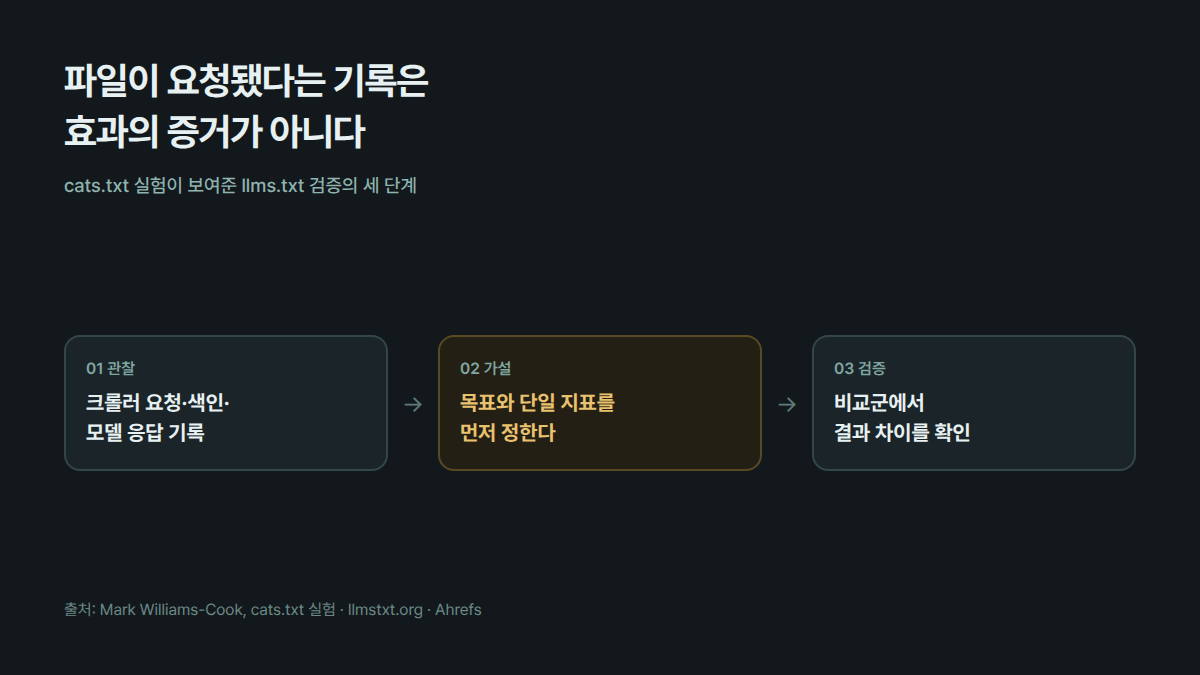
고양이 파일이 통과한 네 가지 ‘증거’
llms.txt는 사이트의 짧은 개요와 중요한 Markdown 문서 링크를 정리해, 에이전트가 필요한 정보를 찾도록 돕자는 제안이다. 2024년 공개된 제안서는 파일을 사이트 루트나 하위 경로에 두고, 사람과 언어 모델이 함께 읽을 수 있는 Markdown 형식으로 안내한다. 문서 탐색의 출발점으로 쓸 수 있다는 목적과, 검색이나 AI 답변의 노출을 높인다는 주장은 구분해야 한다.
Mark Williams-Cook은 이 구분이 흐려진 사례를 보이기 위해 가짜 표준 cats.txt를 만들었다. 사이트의 고양이 이름, 직책, 품종, 애정도를 적는 파일을 만든 뒤 사양과 소개 글을 공개하고, 다른 사람들이 참여하게 했다. 이어 llms.txt의 효과를 말할 때 자주 제시되는 네 가지 관찰을 같은 파일에 적용했다. AI 크롤러가 파일을 요청했고, Google에 색인됐고, 모델이 파일에만 있던 고양이 정보를 답했고, ChatGPT는 검색과 LLM 노출에 도움이 될 수 있다고 답했다.
이 실험의 요점은 llms.txt가 절대로 쓸모없다는 선언이 아니다. 파일 요청, 색인, 모델의 답변, 모델 자신의 권고가 각각 어떤 결과를 증명하는지 다시 묻자는 데 있다. 공개 웹에 놓인 텍스트 파일은 일반 크롤러가 가져갈 수 있고, 색인된 페이지라면 검색 기반 답변에 인용될 수도 있다. 그 관찰만으로 파일 형식이 특별한 신호로 처리됐다고 결론 내릴 수는 없다.

파일을 요청했다는 기록이 왜 효과를 뜻하지 않나
로그에는 누가 어느 URL을 언제 요청했는지가 남는다. 그 뒤에 파일 내용을 읽었는지, 검색 후보를 고를 때 가중치를 줬는지, 답변에 인용할 때 다른 페이지보다 우선했는지는 로그 한 줄로 알 수 없다. Googlebot이 특정 텍스트 파일을 가져간 사실도 URL을 발견해 수집했다는 뜻과 먼저 연결된다.
Google Search Central은 AI Overviews와 AI Mode에 나타나기 위해 새 기계 판독 파일이나 특수 마크업을 만들 필요가 없다고 안내한다. 지원 링크가 되려면 일반 Google Search에서 색인되고 스니펫 표시 대상이어야 한다. 즉 Google의 AI 검색을 목표로 한다면, 파일 존재 여부를 독립된 순위 신호처럼 다루기보다 페이지가 검색의 기본 요건과 유용한 콘텐츠 기준을 충족하는지부터 봐야 한다.
Ahrefs가 2026년 5월 트래픽을 받은 13만 7,210개 도메인의 로그를 분석한 결과도 이 구분을 뒷받침한다. 표본 중 약 28%가 유효한 llms.txt를 냈지만, 그 파일의 97%는 한 달 동안 요청을 받지 않았다. 요청이 있었던 소수 파일에서조차 요청은 감사 도구, 일반 크롤러, 기술 프로파일링 도구 등 여러 범주에서 왔다. 이 표본은 Ahrefs 분석 도구를 쓰는 기술·SEO 친화적 사이트에 치우쳐 있어, 28% 채택률은 웹 전체의 비율이 아니라 그 표본 안의 수치다.
인용 증가와 문서 탐색은 다른 목표다
llms.txt의 제안서가 설명하는 직접적인 효용은 압축된 사이트 안내와 상세 Markdown 문서로 이어지는 길이다. 개발자 문서가 넓고 복잡한 경우, 코딩 에이전트가 API 참조와 튜토리얼을 찾는 시간을 줄일 수 있다는 가설은 실제 작업으로 시험할 수 있다. 같은 질문 묶음에 대해 정답 문서를 고르는 비율, 올바른 문서에 도달하는 시간, 잘못된 링크를 택한 횟수를 비교하면 된다.
반대로 목표가 AI 답변의 인용 증가라면 측정 대상은 답변 결과다. 쿼리 묶음, 확인 날짜, 답변형 검색 서비스, 인용 URL과 유입을 미리 정하고 비교해야 한다. 파일을 추가한 날 이후 인용이 늘었다고 해도 동시에 새 글을 발행했거나 페이지 구조를 바꿨다면 원인을 파일 하나에 묶을 수 없다. 이 두 목표를 하나의 ‘AI 최적화’ 지표로 합치면, 어떤 투자가 실제로 도움이 됐는지 판단하기 어려워진다.
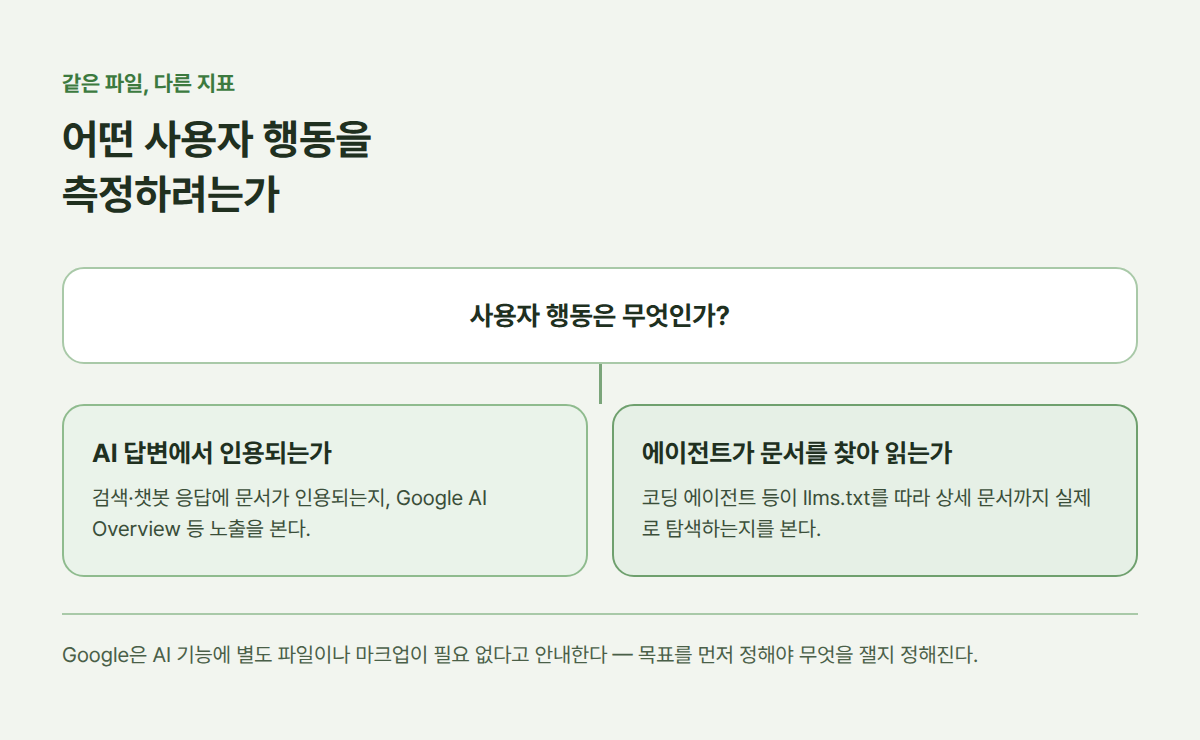
효과가 보이는 실험은 무엇부터 정하나
먼저 “에이전트가 필요한 API 문서를 더 빨리 찾는가”처럼 목표를 한 문장으로 적는다. 이어 정답 링크 선택률이나 문서 도달 시간처럼 목표와 바로 맞닿은 지표 하나를 고른다. 인용 수, 세션 수, 작업 완료 시간을 한꺼번에 성공 기준으로 놓으면 결과가 좋거나 나빴을 때 무엇을 배웠는지 흐려진다.
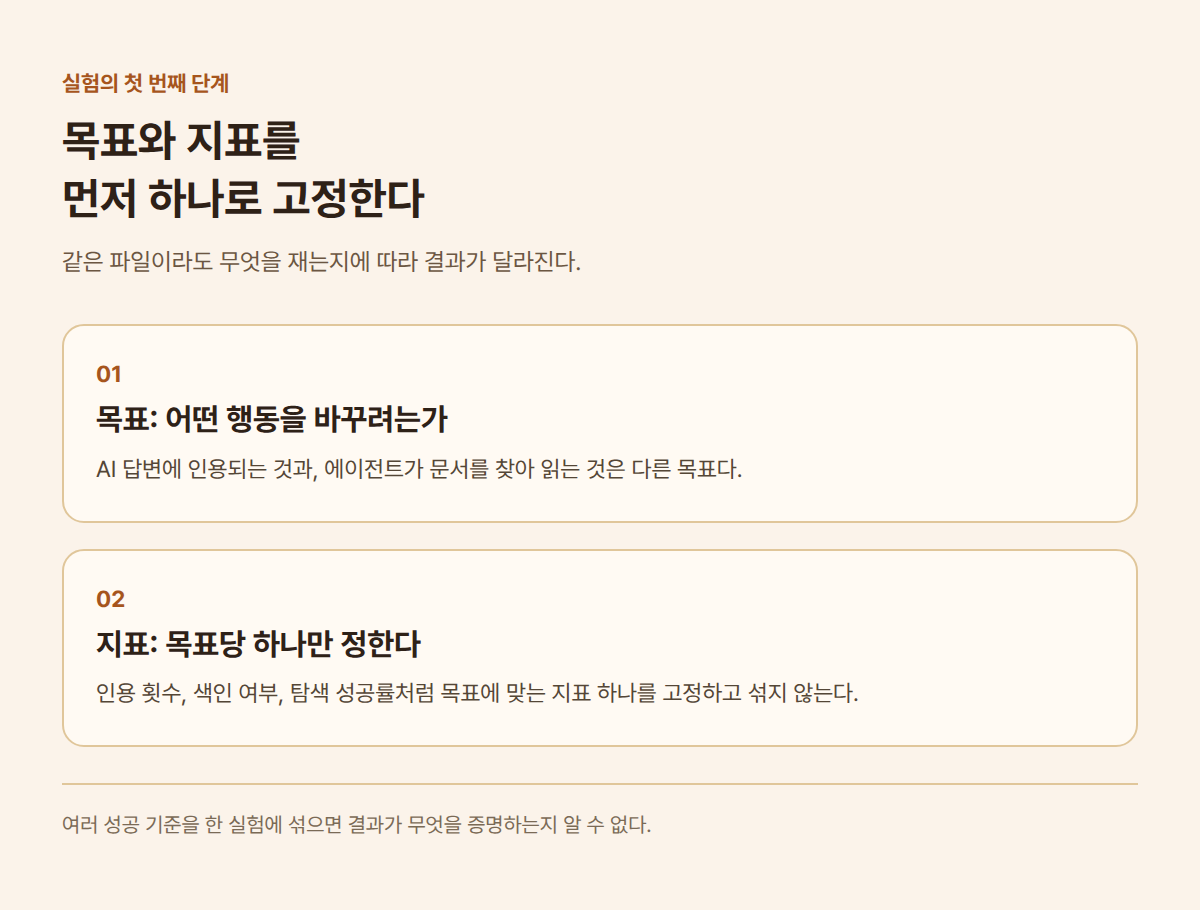
그다음 주제와 유입량이 가까운 문서 묶음, 비교 기간, 파일 외 변경 사항을 함께 기록한다. llms.txt를 추가하면서 Markdown 사본, 내부 링크, 구조화 데이터, 문서 개편을 동시에 배포하면 결과가 달라져도 어느 변화가 작동했는지 분리할 수 없다. 효과가 없을 때 끝낼 날짜나 최소 변화 폭도 정해 두면, 애매한 관찰을 반복해서 성공으로 읽는 일을 줄일 수 있다.
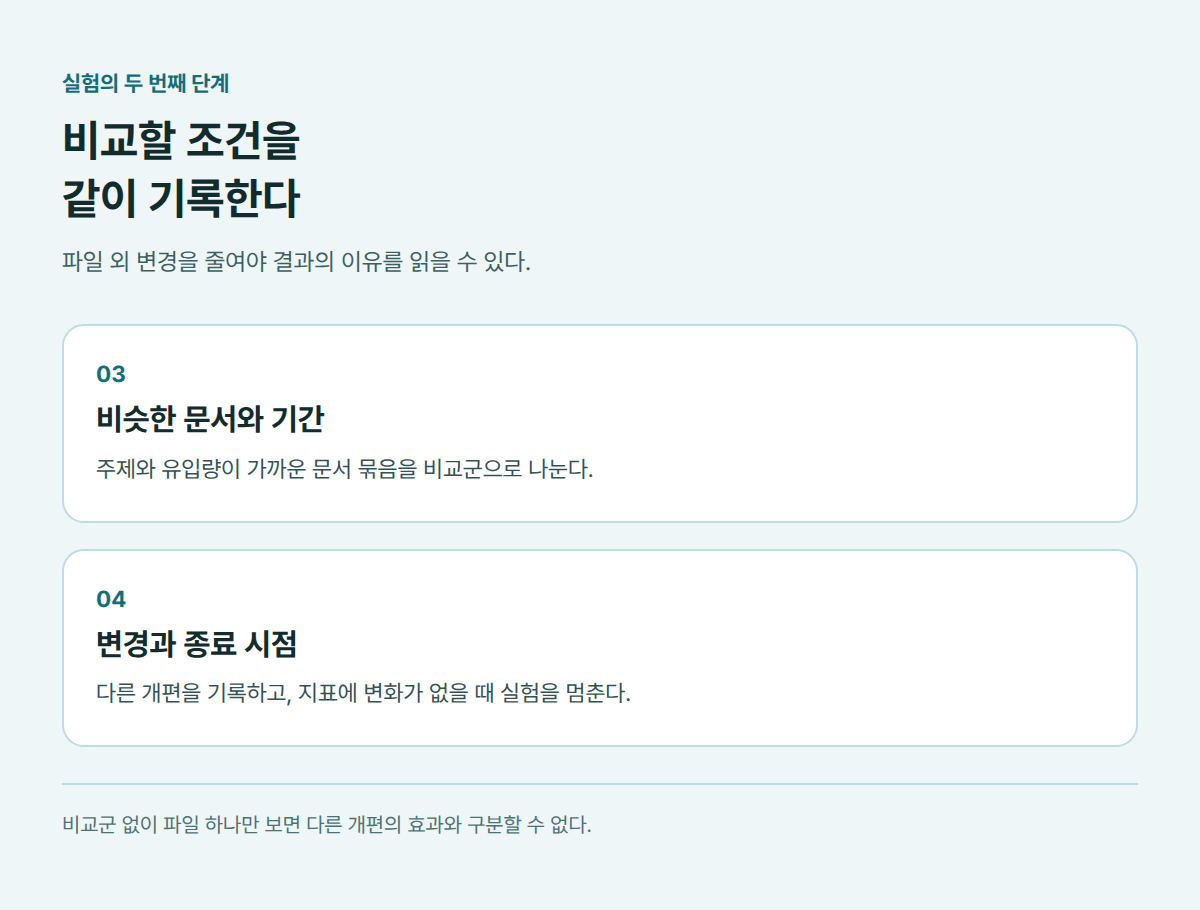
작은 파일도 운영 기준 없이 늘리지 않는다
llms.txt를 만드는 비용 자체는 작을 수 있다. 그러나 생성 규칙, 링크 최신성, 번역본, 문서 개편 때의 갱신까지 운영 범위에 들어오면 파일 하나가 지속적인 업무가 된다. 그래서 파일을 추가하기 전에 어떤 사용자 행동을 바꾸려는지, 그 행동을 어떤 비교로 확인할지, 변화가 없을 때 무엇을 중단할지 정하는 편이 낫다.
고양이 파일이 보여 준 것은 새 형식의 가능성을 비웃는 일이 아니라, 그럴듯한 관찰과 사업상 효과를 분리하는 방법이다. 검색 최적화 투자는 크롤러의 요청 기록이나 모델의 자신감보다, 사전에 정한 결과가 비교 조건에서 실제로 달라졌는지로 판단해야 한다.
출처: Mark Williams-Cook, How cats.txt showed llms.txt evidence is GEO astrology · llms.txt 제안서 · Google Search Central, AI features and your website · Ahrefs, We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read