
챗봇의 답변과 링크된 페이지에 같은 숫자가 적혀 있어도, 그 숫자의 조사 근거까지 확인된 것은 아니다. 10월 28일 공개된 Trakkr의 조사에서는, 인용된 통계 1,285건 중 원연구까지 찾아갔을 때 같은 내용을 확인한 비율이 약 40%였다.
Trakkr는 챗GPT, Perplexity, Gemini, Claude, 구글 AI Overviews에 수치로 답할 질문 200개를 던졌다. 일상적인 질문 160개와 널리 퍼진 유명 통계에 관한 질문 40개를 구분했고, 전체 비율은 일상 질문 답변에서 출처가 달린 통계를 표본 추출해 계산했다. 숫자를 발견한 웹페이지와 그 숫자를 처음 조사한 자료 사이에 어떤 차이가 생기는지 살펴본 연구다.
원연구를 못 찾은 통계가 모두 거짓은 아니다
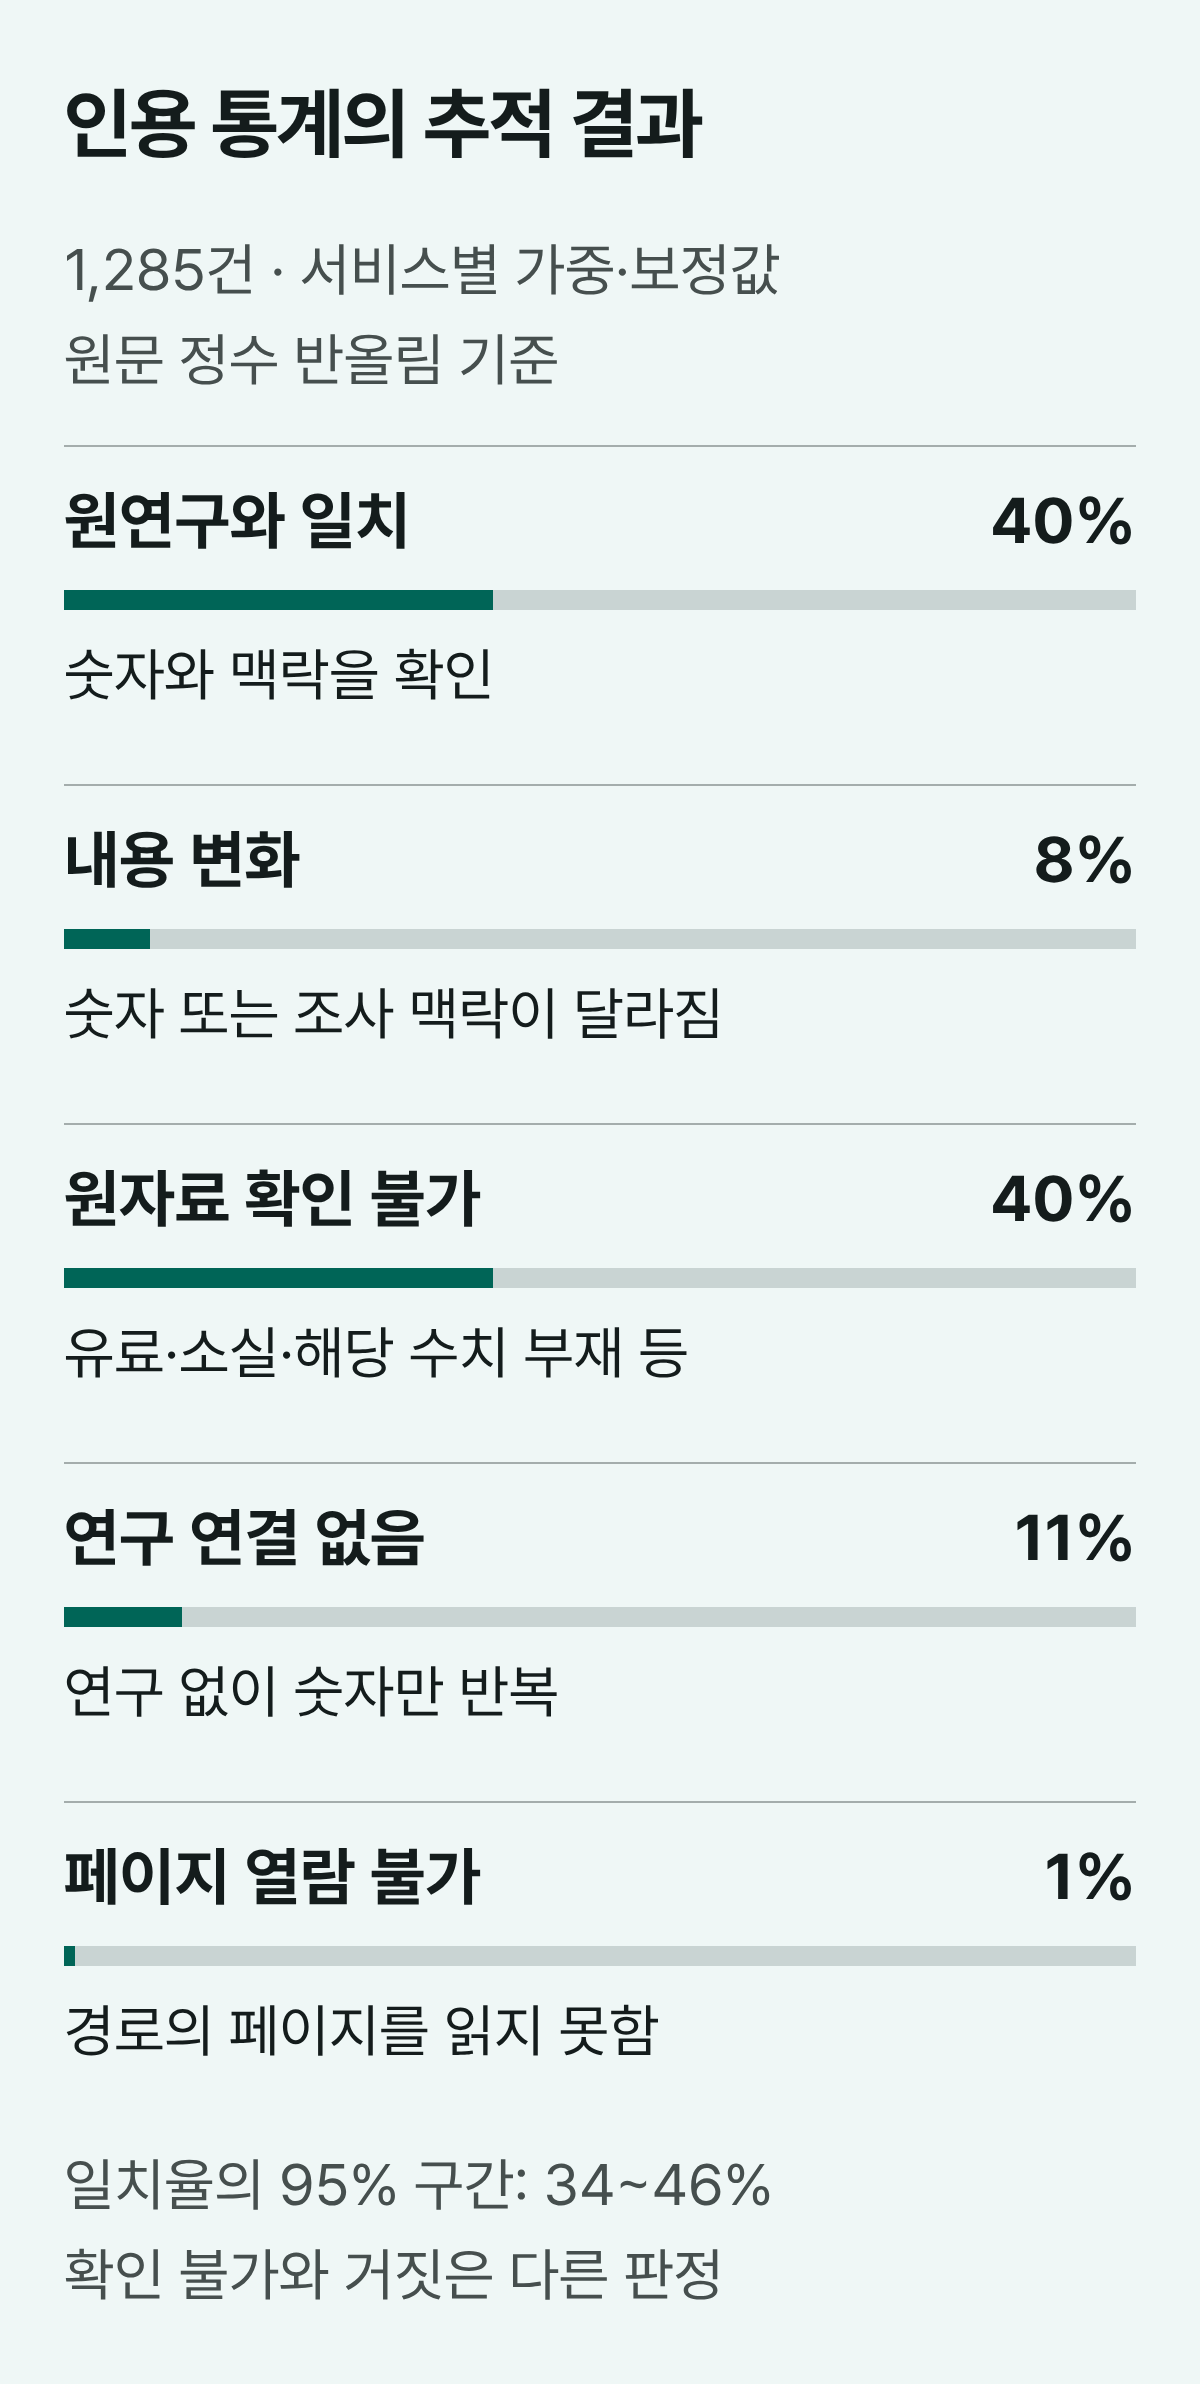
연구진은 인용 페이지에서 시작해 최대 다섯 페이지 깊이까지 출처를 따라갔다. 링크 없이 연구 이름만 적혀 있으면 별도로 검색했다. 약 40%는 원연구의 내용과 일치했고, 8%는 원연구를 찾았지만 수치나 조사 대상 같은 맥락이 달라져 있었다. 40%는 유료 장벽, 사라진 자료, 출처에 해당 수치가 없는 경우 등으로 확인이 끝나지 않았다. 연구를 가리키지 않고 숫자만 반복하는 경로가 11%, 페이지 자체를 읽지 못한 경우가 약 1%였다.
확인이 끝나지 않았다는 것과 근거 없는 숫자라는 것은 다른 판정이다. 이 결과를 “챗봇 통계의 60%는 거짓”으로 옮기면 조사 결과를 다시 왜곡하게 된다. 약 40%라는 값도 단순 건수 비율이 아니라, 서비스별 인용 통계량을 반영하고 사람이 재검토한 결과로 보정한 추정치다. 원연구와 일치한 비율의 95% 구간은 34~46%로 제시됐다.
처음에는 모델이 경로를 판정했고, 그중 300건을 더 강한 모델로 다시 평가했다. 이어 무작위로 고른 150건을 사람이 재검토해 비율을 보정했다. 모델 판정만 썼을 때 원연구와 일치한 비율은 23%였지만, 사람이 모델이 놓친 원자료를 찾으면서 약 40%로 올라갔다. 답변은 2026년 10월 25일 미국 위치와 웹 검색을 설정한 API로 한 번씩 수집했으므로, 소비자용 앱 전체의 고정된 정확도를 뜻하지 않는다.
같은 숫자가 있는 페이지와 원출처는 다르다
인용된 페이지에 답변의 숫자가 실제로 들어 있는 경우는 약 82%였다. 반면 첫 인용 페이지가 원연구였던 비율은 약 21%에 그쳤다. 답이 링크 내용을 충실히 옮겼더라도, 링크된 글이 다른 글의 통계를 재인용했다면 근거 확인은 끝나지 않은 셈이다.
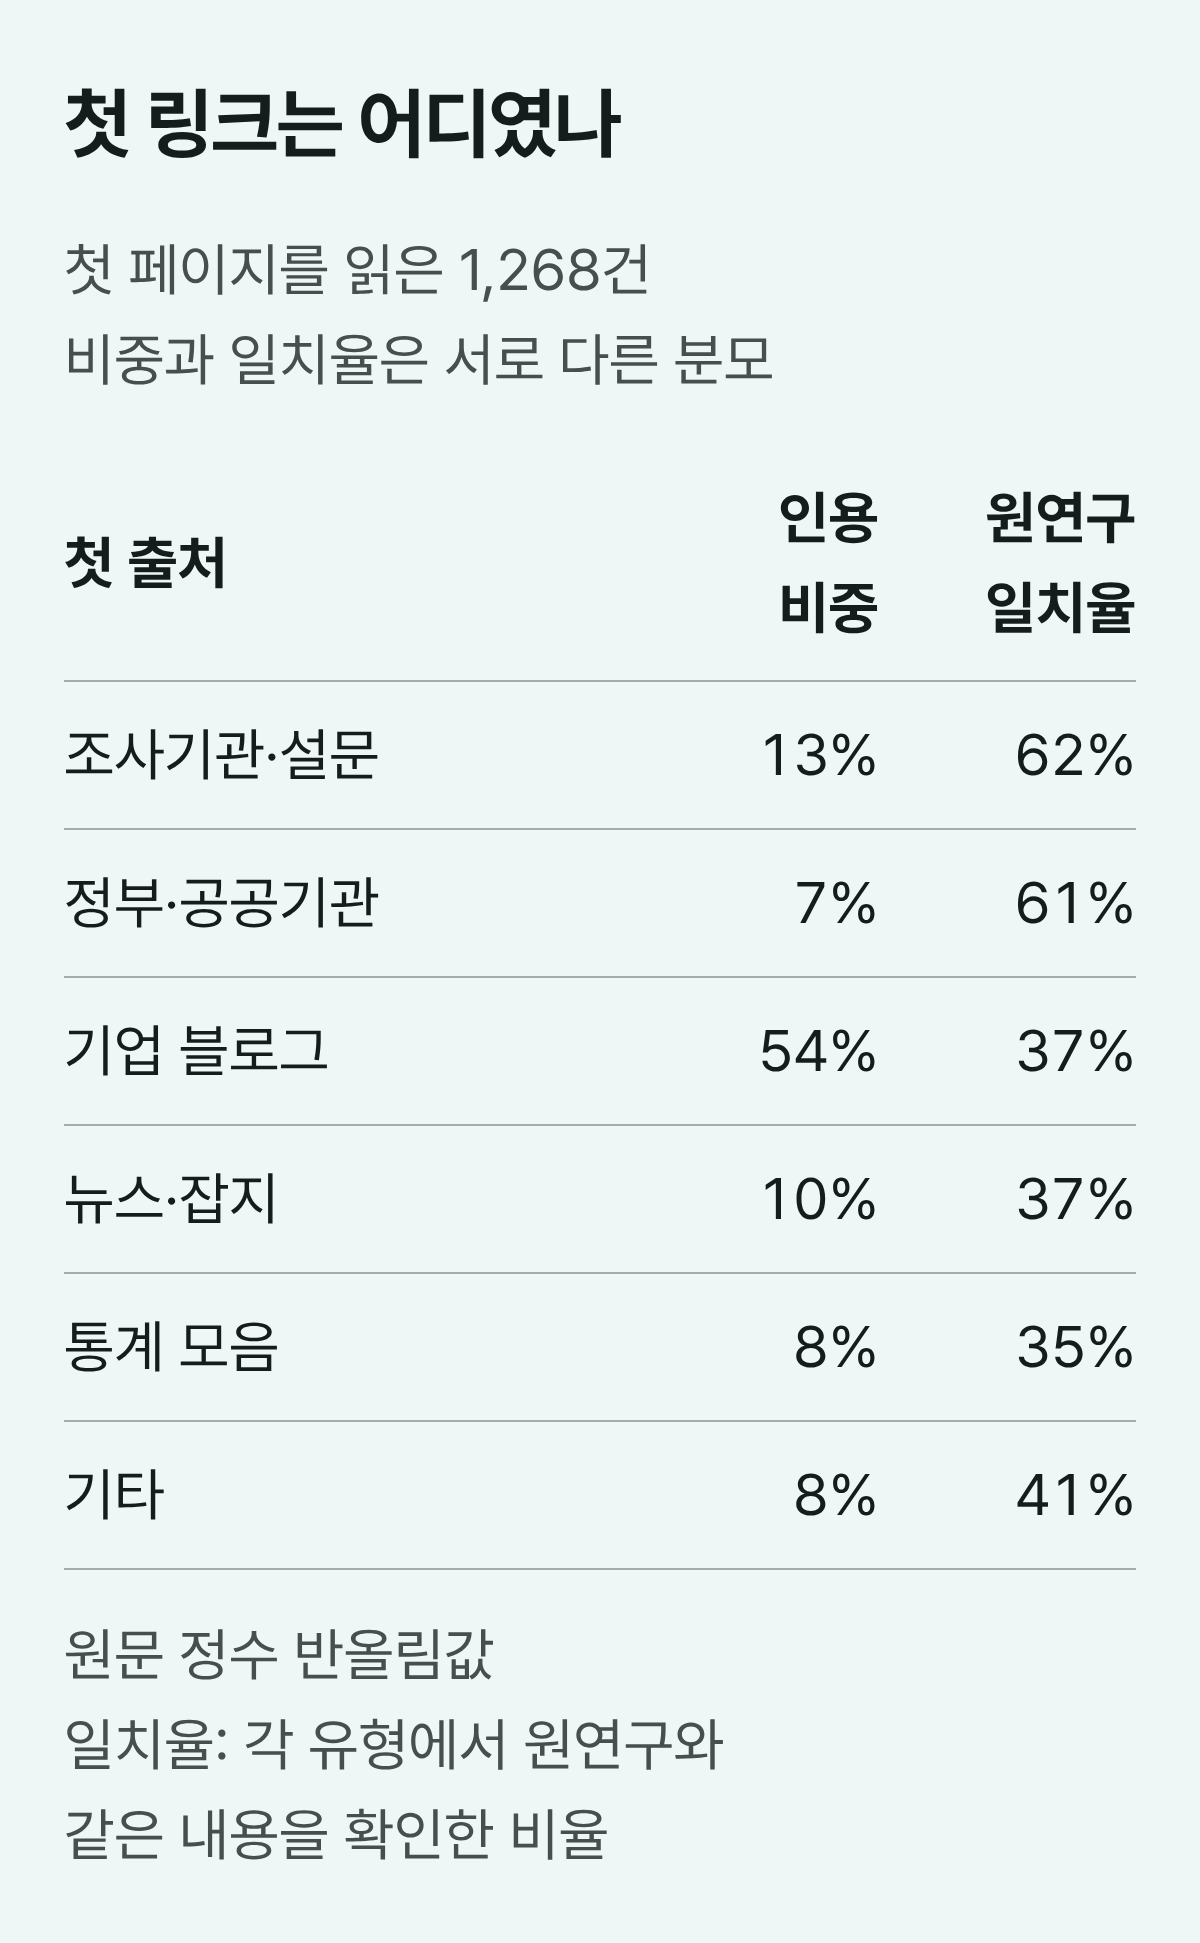
첫 출처의 54%는 기업 블로그였다. 여기에서 출발해 원연구와 일치하는 내용을 찾은 비율은 37%였다. 조사기관·설문 페이지는 첫 인용의 13%를 차지했고 일치 비율은 62%, 정부·공공기관은 각각 7%와 61%였다. 출처의 종류는 어디부터 확인할지 정하는 데 도움이 되지만, 기관 이름만으로 개별 수치가 검증되지는 않는다. 조사기관에서도 보고서가 입력 양식 뒤에 있어 추적이 멈추는 사례가 있었다.
68이라는 숫자를 그대로 두고도 뜻은 바뀐다
숫자 자체보다 숫자가 가리키는 대상이 달라진 사례도 있었다. BrightEdge가 2019년 발표한 68%는 추적 가능한 웹사이트 방문 유입 중 자연 검색과 유료 검색에서 온 비중이다. 그런데 Trakkr가 추적한 재인용 경로에서는 “온라인 경험의 68%가 검색엔진에서 시작한다”는 문장으로 바뀌었다. 사이트로 들어온 방문의 출처를 측정한 결과가, 온라인에서 하는 모든 경험의 시작점을 설명하는 말로 확장됐다.
웹사이트 첫인상에 관한 94%도 비슷했다. Trakkr가 확인한 출발점은 2004년 영국 여성 15명이 건강정보 웹사이트를 평가한 연구다. 그들이 사이트를 거부하거나 불신하면서 한 의견 중 94%가 디자인에 관한 것이었다. 이후 재인용을 거치며 모든 웹사이트의 첫인상 중 94%가 디자인에 달렸다는 주장으로 변했다. 비율은 남았지만, 무엇을 세었는지와 누구를 관찰했는지가 빠졌다.
다섯 서비스가 같은 답을 해도 출처는 하나일 수 있다
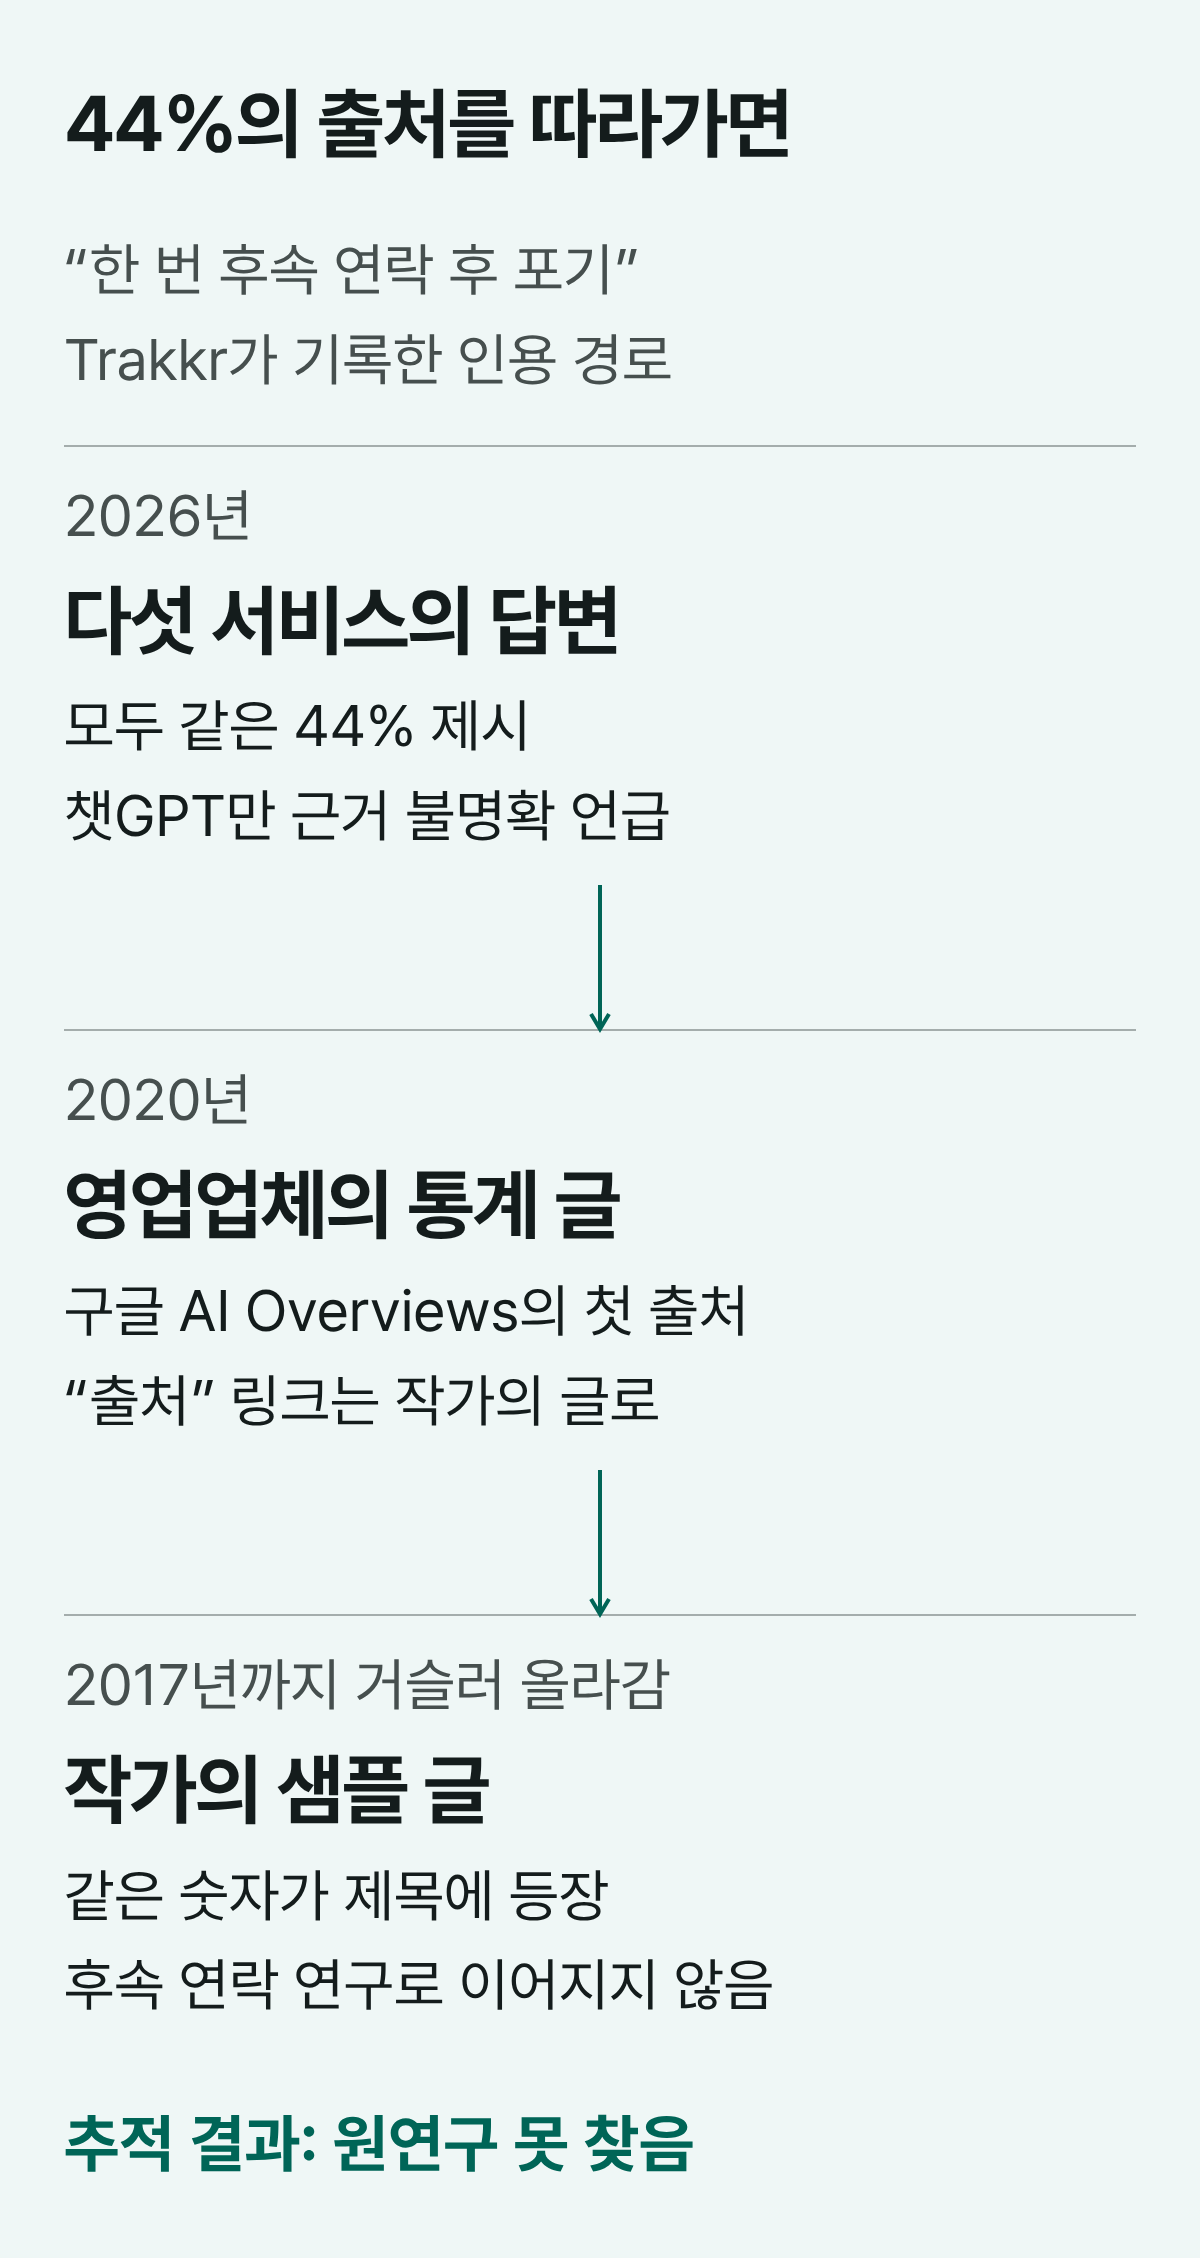
“영업사원의 44%가 한 번 후속 연락한 뒤 포기한다”는 수치는 다섯 서비스가 모두 제시했다. 구글 AI Overviews가 인용한 2020년 영업업체의 통계 글을 따라가자, 2017년까지 거슬러 올라가는 프리랜서 작가의 샘플 글이 나왔다. 그 글의 제목에도 44%가 있었지만, 연구진이 확인한 참고자료는 후속 연락에 관한 원연구로 이어지지 않았다. 챗GPT만 근거가 불명확하다는 설명을 붙였다.
여러 서비스의 답을 맞춰 보는 일은 서로 다른 수치나 조건을 발견하는 데 쓸 수 있다. 하지만 같은 숫자가 나온다는 이유로 독립된 연구가 여러 개 있다고 볼 수는 없다. Trakkr가 세 서비스 이상에서 반복된 통계 29개를 따로 추적했을 때 원연구와 일치한 것은 11개였다.
기획서나 기사에 숫자를 넣을 때는 첫 링크의 재인용 출처까지 열고, 원자료에서 분모와 조사 시점을 먼저 확인하는 편이 낫다. 방문 횟수를 사람 수로, 특정 국가의 설문을 전 세계 이용률로 바꾸지 않았는지 살펴야 한다. 원연구에 도달했다면 숫자 옆에 대상과 시점을 함께 남긴다. “2019년 추적 가능한 웹사이트 방문 중 검색 유입 68%”라고 적으면, 다음 사람이 인용할 때도 무엇을 측정했는지 확인할 수 있다.
출처: Trakkr Research: Zombie stats · BrightEdge: 2019년 웹사이트 유입 조사