
Canva는 수억 명 사용자의 로그인 상태를 처리하는 게이트웨이에서 세션 무효화 목록을 메모리에 둔다. 사용자가 로그아웃하거나 권한이 바뀌면, 암호화된 브라우저 쿠키만으로 매 요청을 통과시키던 구조에 예외를 넣어야 하기 때문이다. 문제는 이 빠른 조회용 목록을 새 게이트웨이 파드가 배포 때마다 MySQL에서 다시 채우면서 생겼다. 파드 수백 개가 각각 100만 건이 넘는 무효화 기록을 가져오면, 배포가 데이터베이스에 동시 읽기 폭주를 만드는 구조였다.
Canva가 2026년 7월 공개한 설계는 이 읽기 병목을 S3의 압축된 이진 청크로 옮기는 방식이다. 요청 경로의 메모리 조회는 유지하고, 시작 시 내려받는 데이터와 최신화 경로만 바꿨다. 핵심은 ‘세션을 즉시 검증하는 서비스’가 아니라, 무효화 데이터를 어떤 형태로 배포하고 갱신해야 대규모 배포가 데이터베이스를 공격하지 않는가에 있다.
쿠키 기반 인증에서 무효화 목록은 왜 따로 필요한가
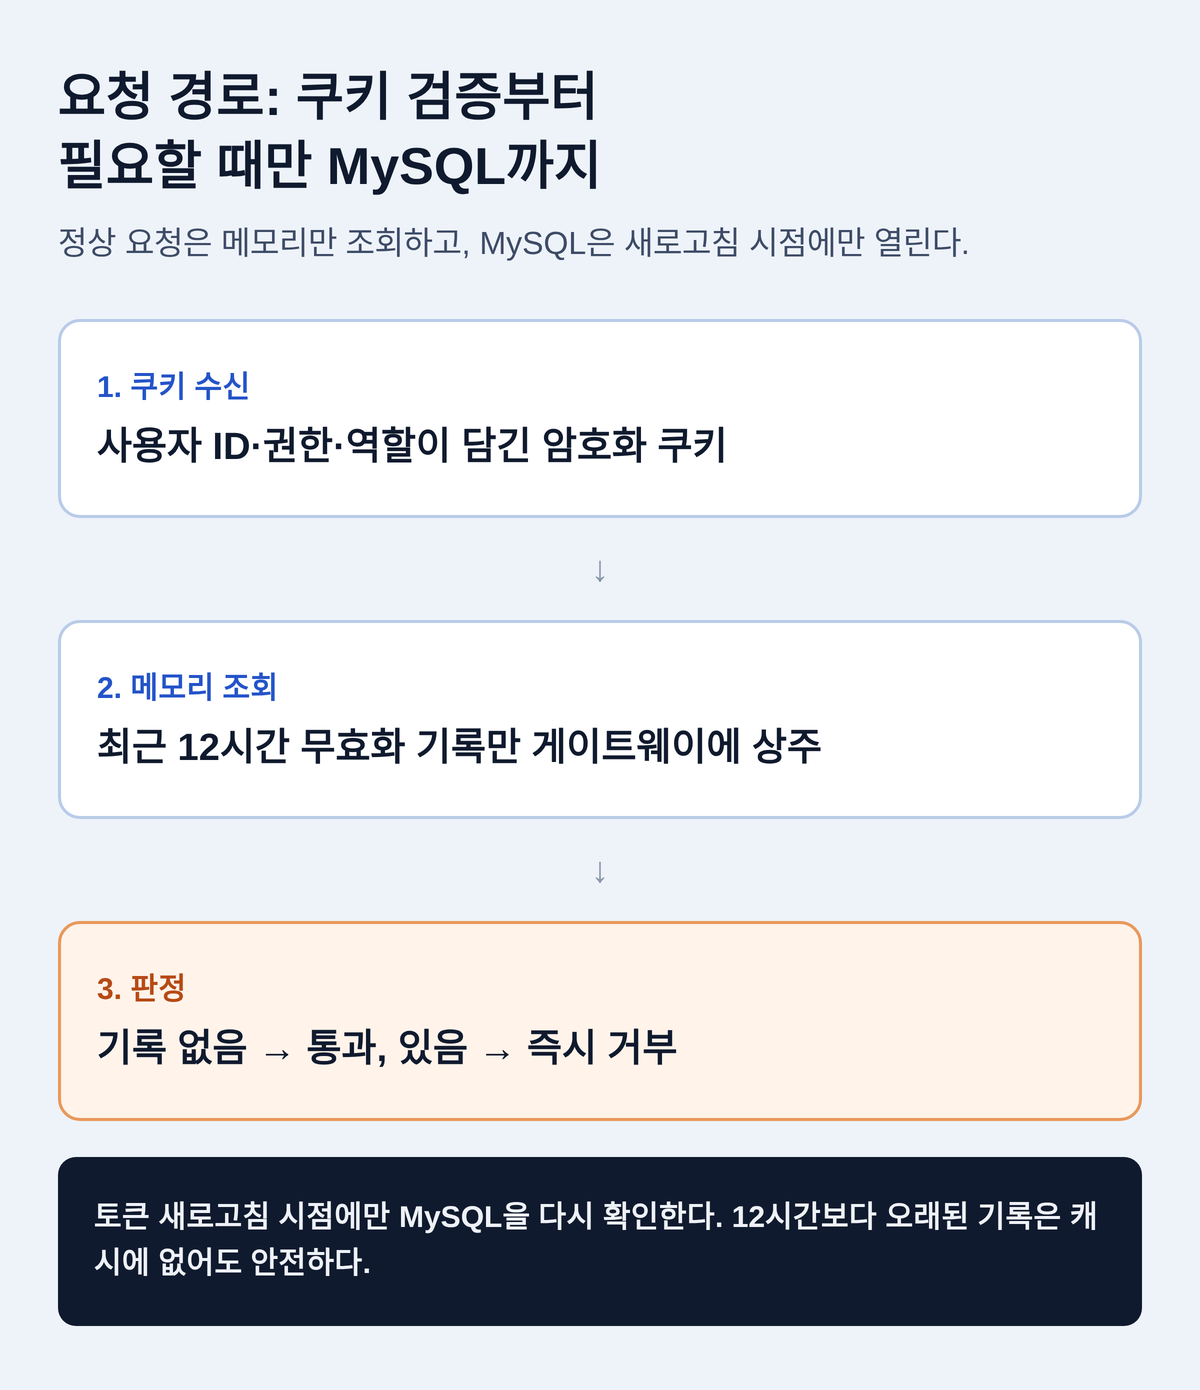
Canva의 쿠키에는 사용자 ID, 권한과 역할처럼 게이트웨이가 요청을 판단하는 데 필요한 정보가 암호화되어 들어 있다. 따라서 정상 요청은 네트워크 데이터 저장소에 매번 물어보지 않아도 된다. 그러나 로그아웃, 권한 변경, 쿠키 안의 일부 캐시 정보 갱신 같은 사건이 발생하면 이미 발급된 쿠키를 계속 신뢰할 수 없다. 게이트웨이는 해당 사용자 또는 브랜드와 그보다 이른 로그인 시각에 적용되는 무효화 기록을 찾아야 한다.
이 기록은 요청마다 메모리에서 조회한다. 쿠키는 주기적으로 새로고침되며, Canva는 최근 12시간의 무효화 기록을 메모리에 보관한다. 새로고침 대상 토큰은 MySQL에서 다시 확인하므로, 12시간보다 오래된 무효화 기록을 게이트웨이 캐시에 계속 들고 있을 필요가 없다. 빠른 정상 경로와 더 느린 갱신 경로를 시간 창으로 나눈 셈이다.
12시간 창을 30분짜리 S3 파일로 나눈 이유
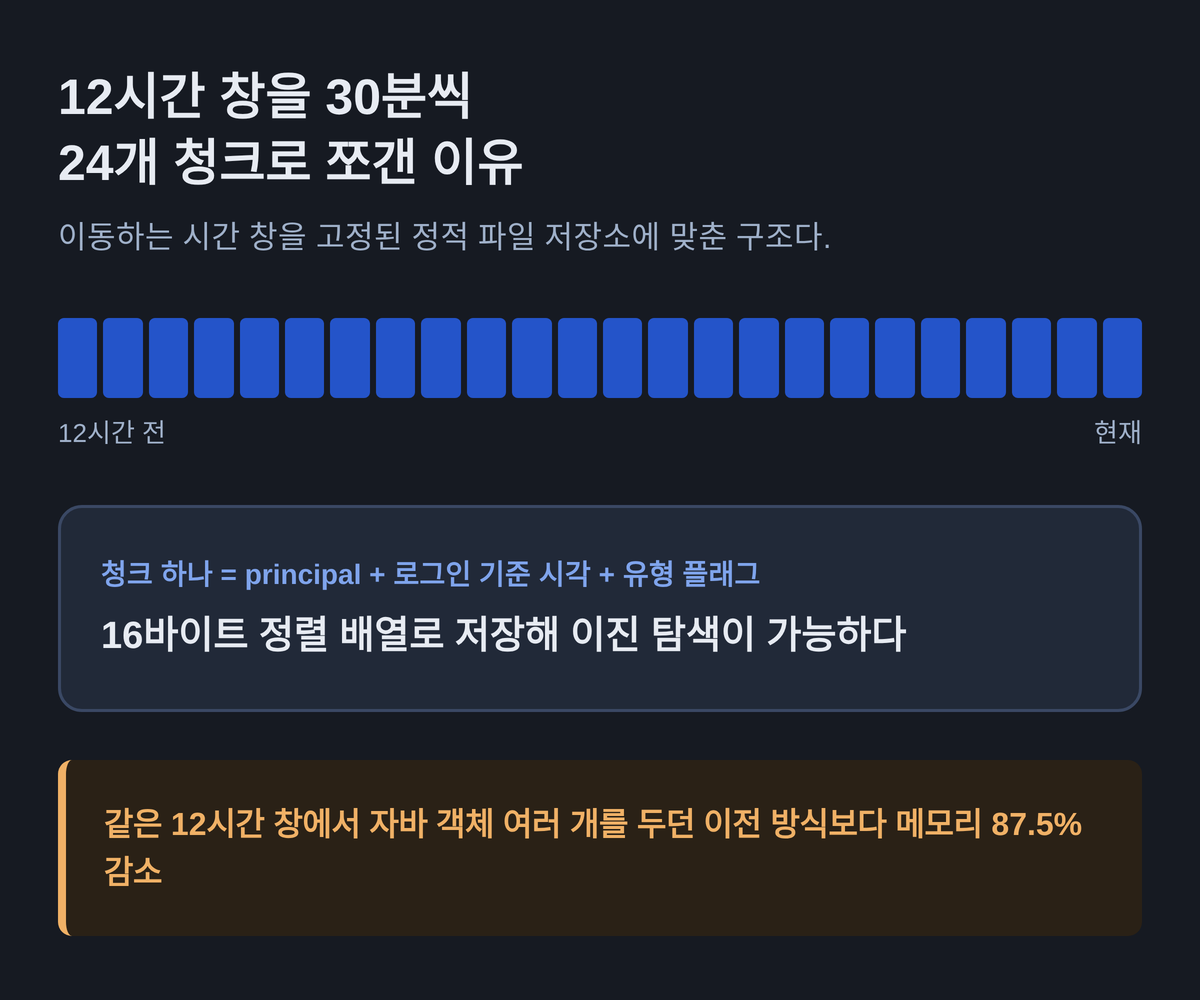
기존 방식의 문제는 조회 연산이 아니라 캐시를 처음 채우는 일이다. Canva는 Redis를 중간 캐시로 검토했지만, 전체 데이터를 네트워크로 읽고 새 무효화를 폴링해야 하며 Redis 클러스터의 내구성과 일관성을 따로 관리해야 했다. 대신 큰 파일을 내구성 있게 싸게 내려주는 S3를 선택했다. 이동하는 무효화 창을 정적 파일 저장소에 맞추기 위해 30분마다 하나의 객체를 만들고, 게이트웨이는 시작할 때 최근 12시간에 해당하는 청크만 가져온다.
각 무효화 레코드는 대상 주체(principal)와 적용 기준 로그인 시각을 담아 16바이트로 패킹한다. 청크는 이 16바이트 항목을 정렬한 평면 배열이므로, 게이트웨이는 내려받은 바이트를 별도 객체로 다시 만들지 않고 이진 탐색할 수 있다. 같은 12시간 창에서 자바 객체 여러 개를 보관하던 이전 방식보다 메모리 사용량을 8분의 1로 줄였고, Canva는 이를 87.5% 감소라고 설명한다. 플래그 비트를 남겨 사용자 전체 로그아웃, 쿠키 정보만 무효화, 브랜드 단위 무효화처럼 여러 유형도 같은 배열에 넣는다.
여러 작업자가 같은 청크를 고쳐도 기록을 잃지 않는 방법
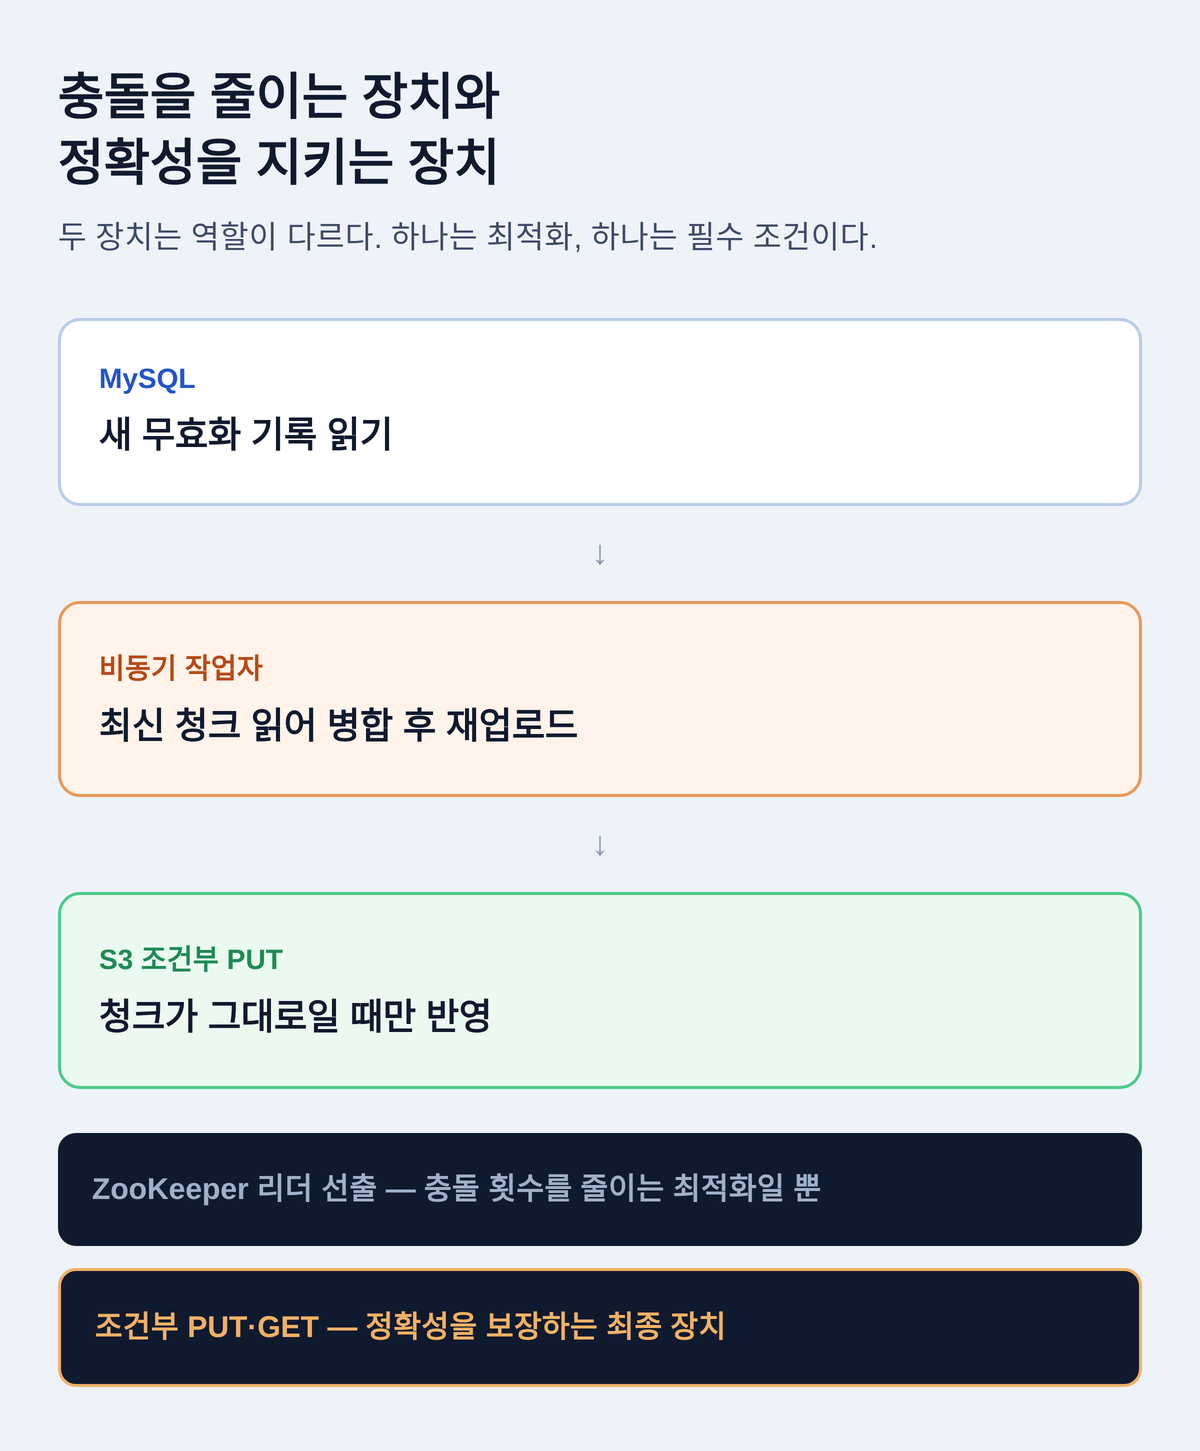
S3 객체는 데이터베이스 행처럼 항목 하나를 추가할 수 없다. 무효화가 생길 때마다 청크를 내려받아 정렬 배열에 삽입한 뒤 다시 올려야 한다. Canva는 이 일을 비동기 작업자에게 맡긴다. 작업자는 아직 S3에 반영되지 않은 기록을 MySQL에서 큰 묶음으로 가져오고, 최신 청크를 읽어 반영한 뒤 업로드한다.
여러 작업자를 실행하면 두 작업자가 같은 청크를 읽고 서로의 결과를 덮어써 기록을 잃을 수 있다. 이를 막는 최종 장치는 리더 선출이 아니라 S3의 조건부 PUT이다. 읽은 뒤 청크가 바뀌지 않았다는 조건을 PUT에 붙이고, 새 청크를 만들 때도 이미 같은 키가 생기지 않았다는 조건을 둔다. ZooKeeper 리더 선출은 충돌 횟수를 낮추는 최적화일 뿐이다. 리더였던 노드가 쓰기 직전에 멈췄다가 늦게 깨어나는 상황에서도 조건부 PUT이 실패하게 해야 무효화 기록이 사라지지 않는다.
게이트웨이는 최신 청크를 조건부 GET으로 다시 받아, 파일이 달라졌을 때만 메모리를 갱신한다. 30분 동안 무효화가 100만 건 생겨도 16바이트 형식이면 청크 하나는 16MB다. Canva는 이를 분당 몇 차례 받는 트래픽이 게이트웨이의 일반 프록시 트래픽에 비해 작다고 봤다. 청크가 12시간 창 밖으로 밀려나면 메모리에서 버린다.
배포 부하의 단위가 ‘과거 기록 수’에서 ‘새 쓰기’로 바뀌었다
새 게이트웨이도 시작할 때 같은 수의 무효화 데이터를 내려받는다. 달라진 것은 수백 개 파드가 MySQL에 각각 질의하던 읽기를 S3의 조밀한 파일 다운로드로 바꿨다는 점이다. 게이트웨이 하나에는 수십 MB지만, 전체 플릿에서는 수십 GB가 동시에 이동할 수 있다. 따라서 이 설계는 데이터를 없애는 최적화가 아니라, 그 대량 전송을 데이터베이스 질의가 아닌 객체 저장소 다운로드에 맞춘 설계다.
Canva는 새 구조로 배포 속도를 개선하고 세션 무효화 데이터베이스의 읽기 복제본을 이중화를 위한 2개만 남겼다고 밝혔다. 작업자는 청크 안의 정렬 배열을 반복 처리하므로 이론상 청크 크기에 대해 O(N²) 시간이 걸릴 수 있다. 그러나 한 번에 수백 건씩 처리한 측정에서 초당 2,000건 이상을 반영했고, 병목은 배열 정렬보다 네트워크 지연 시간이었다고 설명한다. 이 사례가 보여 주는 판단 기준은 분산 시스템의 알고리즘 표기만이 아니다. 요청 경로에는 메모리 조회를 남기고, 배포 때 몰리는 대량 읽기는 내구성 있는 파일 전송으로 분리하며, 정확성은 리더 선출이 아니라 쓰기 조건으로 보장해야 한다.
출처: Canva Engineering, “Session revocations at scale” (2026-07-22)