
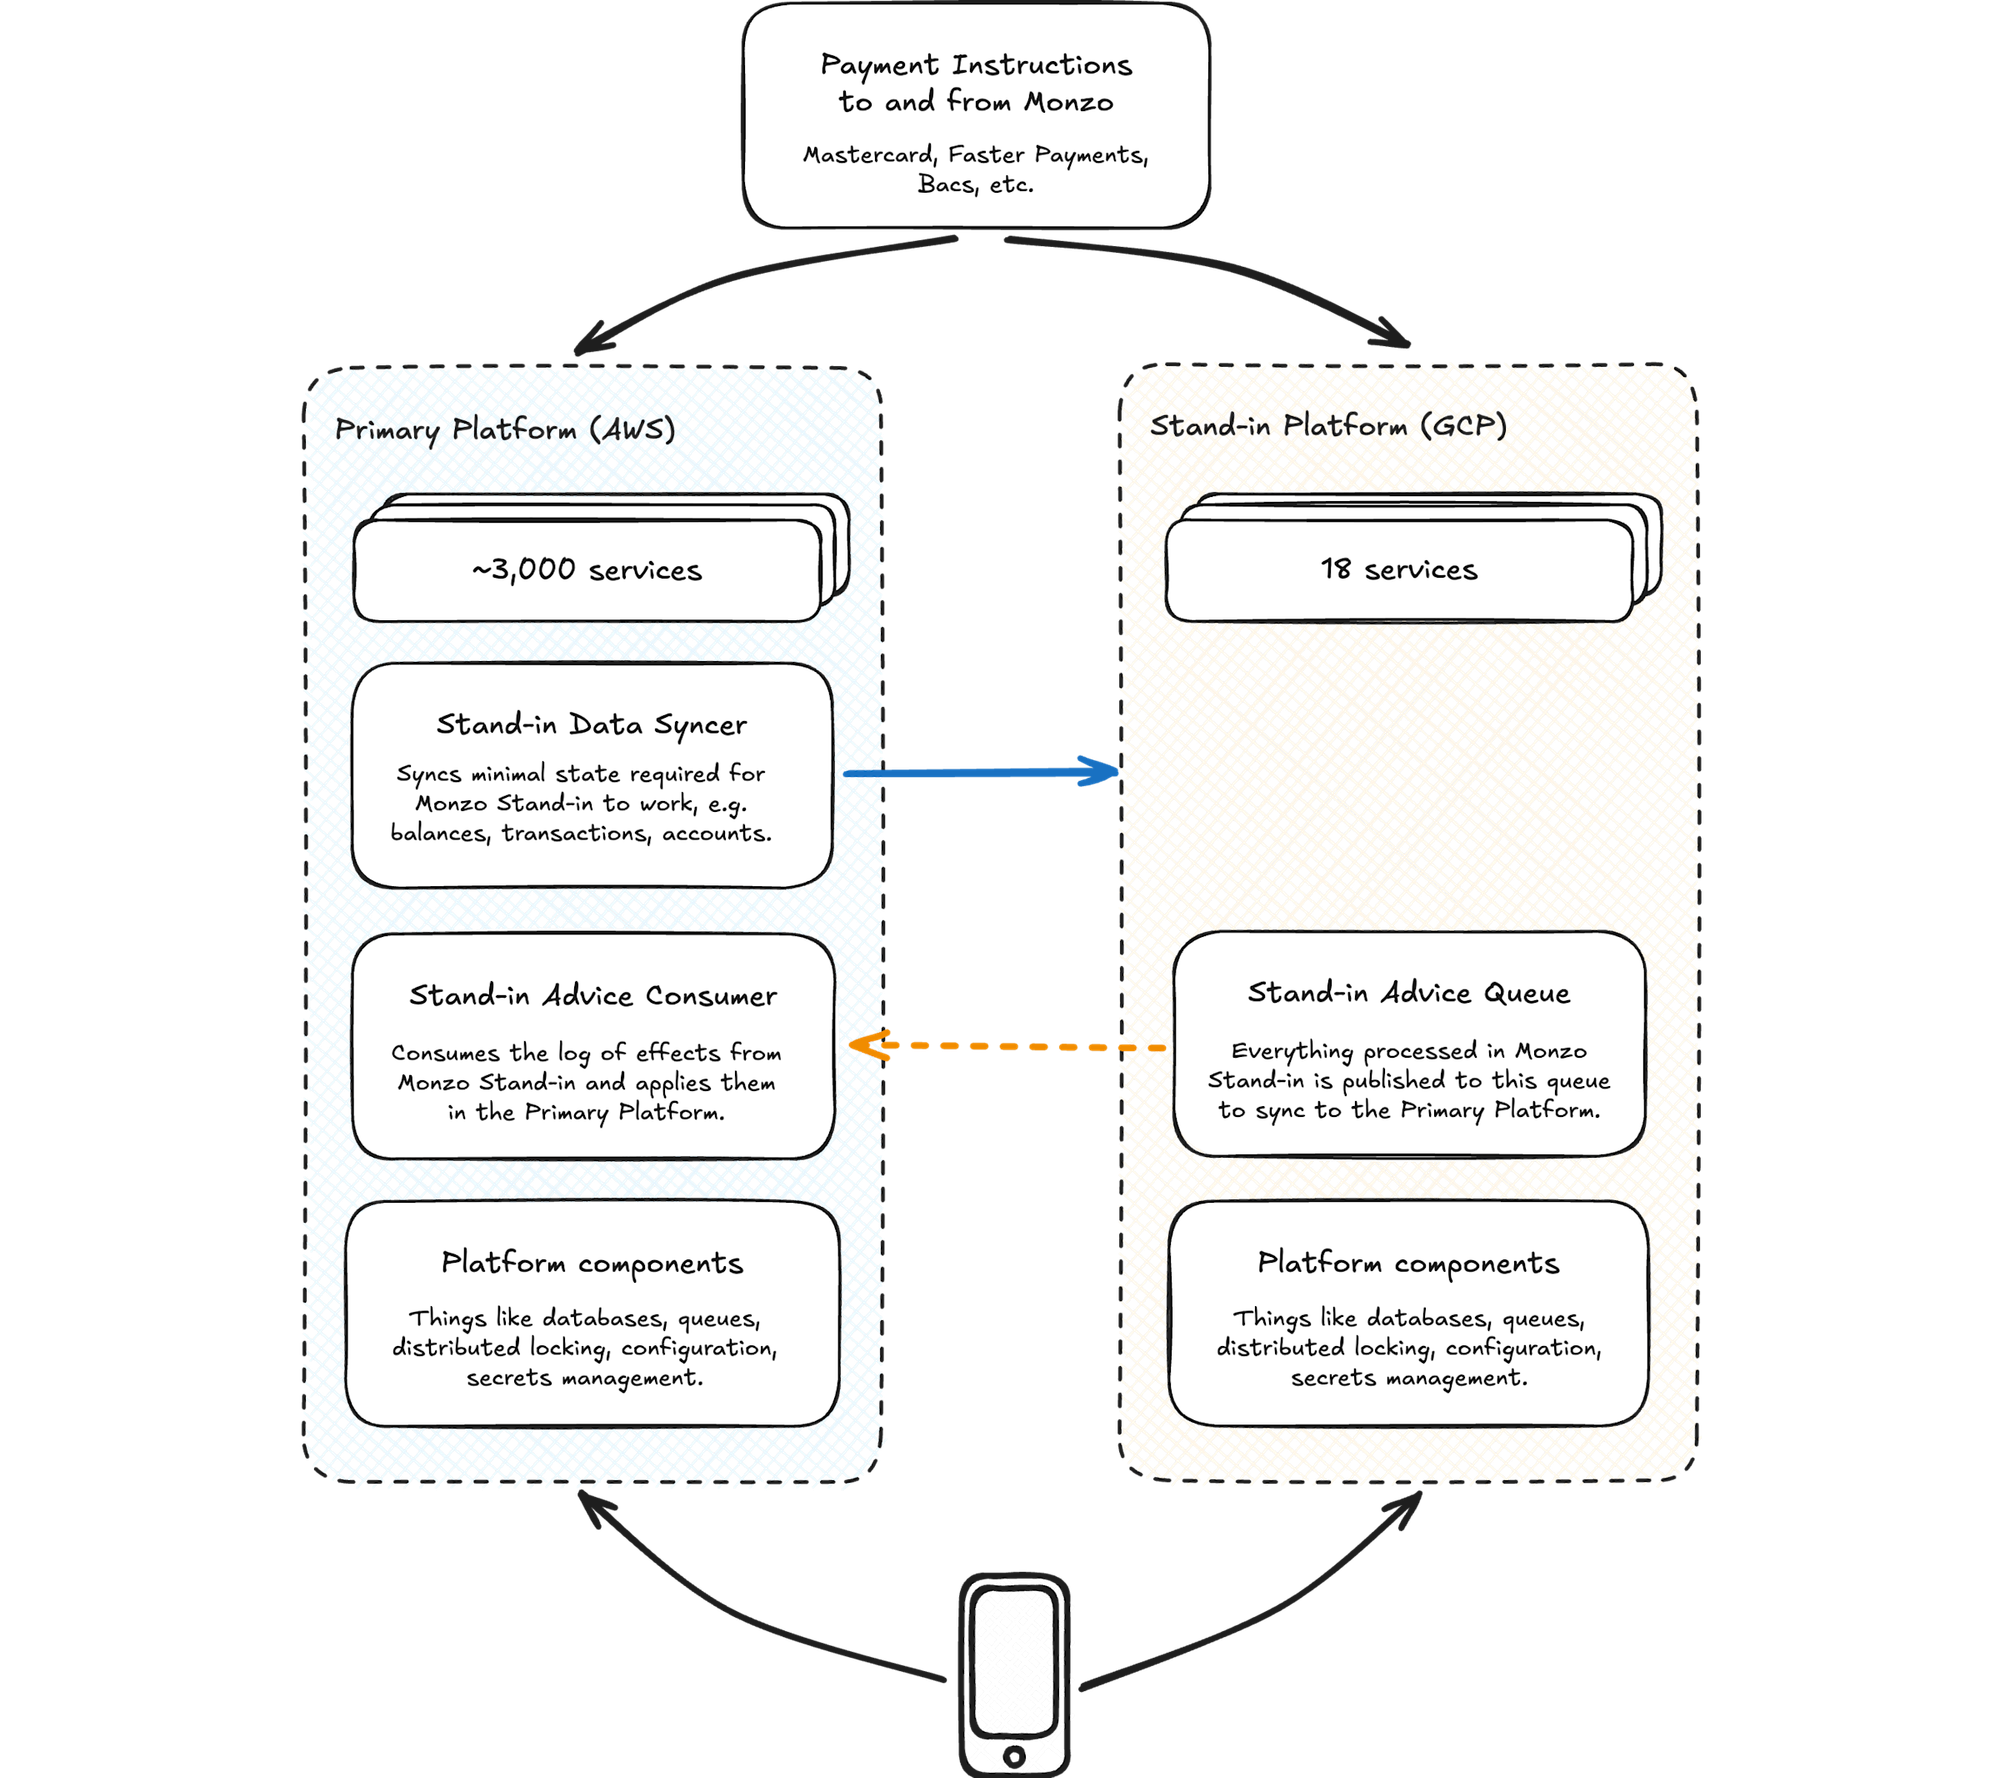
클라우드 한 곳이 통째로 멈추는 상황에서도 카드 결제와 이체를 이어가려면, 대기 환경을 주 시스템의 복사본으로 만들면 안 된다. 영국 은행 Monzo는 AWS에서 운영하는 주 플랫폼과 별개로, GCP에서 작동하는 Monzo Stand-in을 만들었다. 이 시스템은 2025년 2월 공개된 설계이며, 2024년 8월 약 1시간의 대형 장애 때 전 고객을 대상으로 가동됐다.
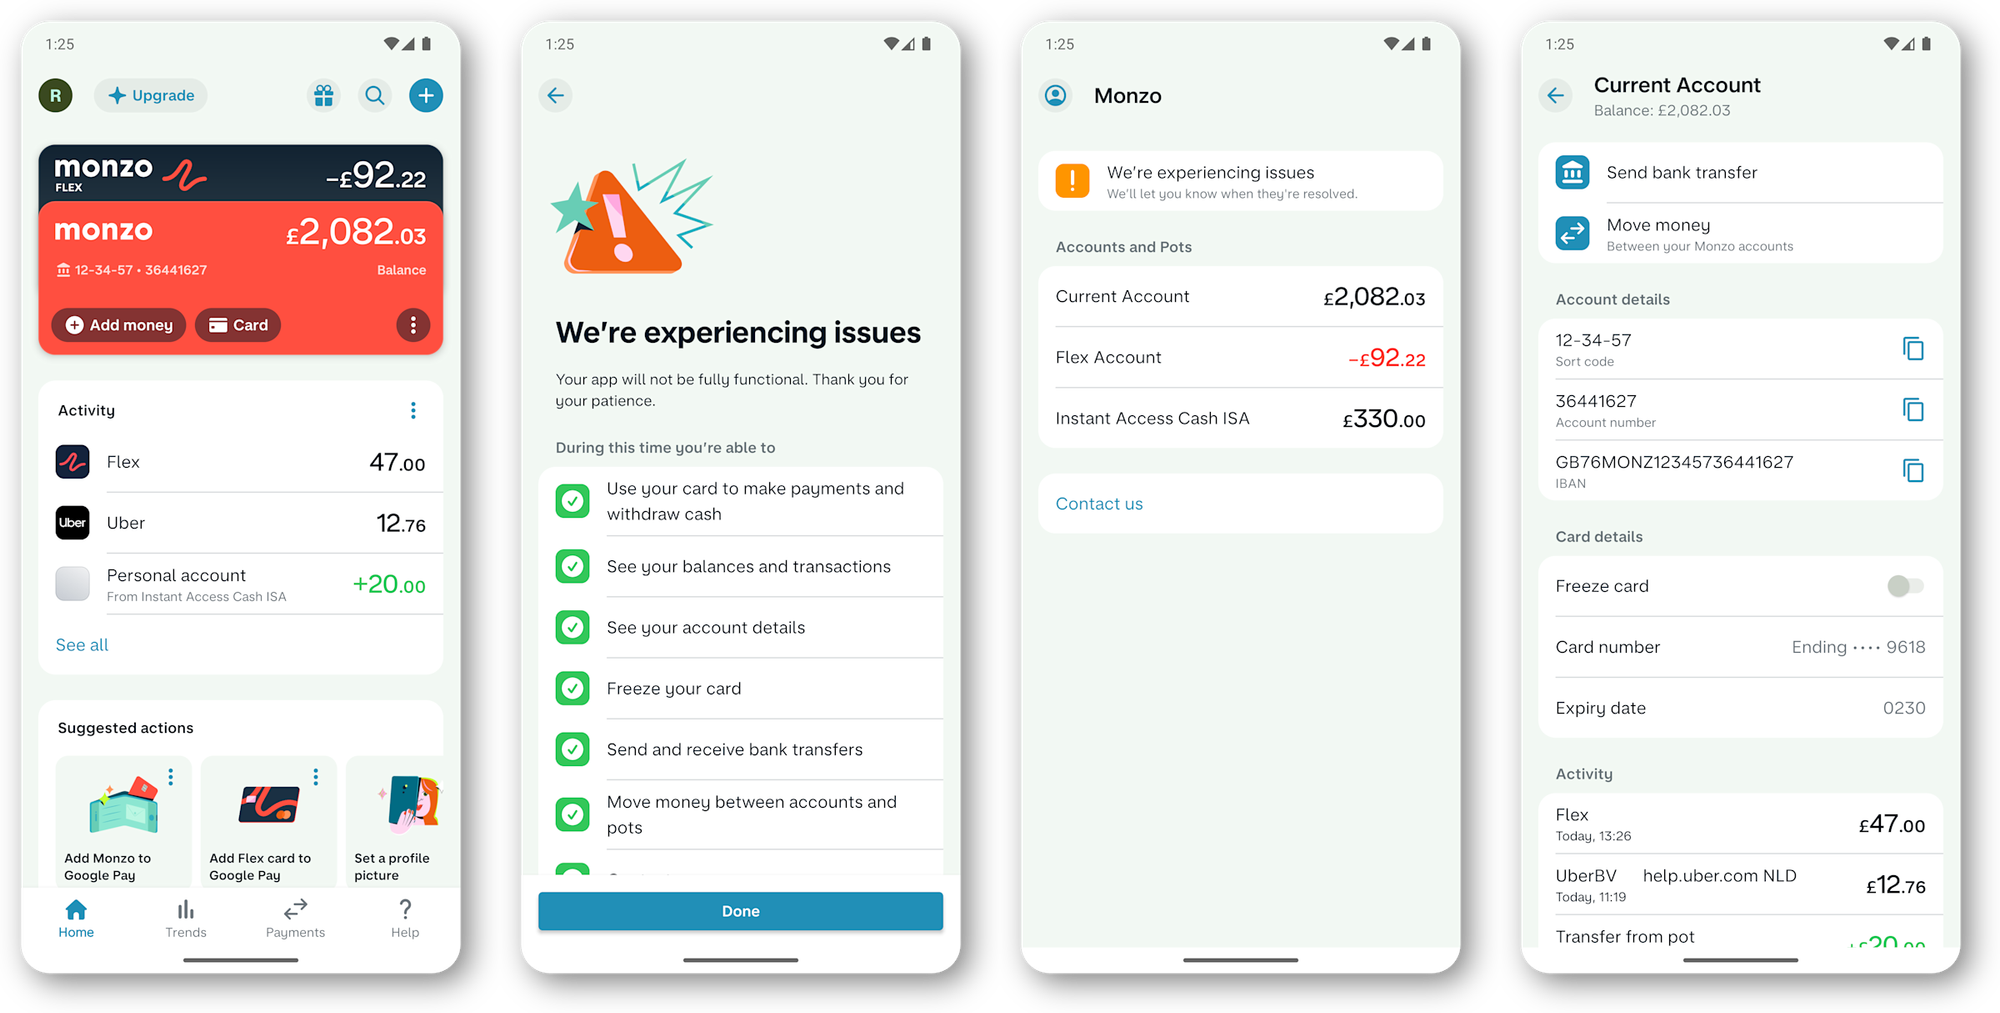
Stand-in이 맡는 일은 의도적으로 좁다. 카드 사용과 현금 인출, 이체 송수신, 잔액·거래내역 조회, 카드 동결·해제가 대상이다. 앱도 배경에서 Stand-in 활성화 여부를 확인하다가 장애 모드로 전환하면 이 기능만 남긴 단순한 화면을 보여 준다. 모든 기능을 평소처럼 제공하겠다는 약속보다, 고객이 돈을 쓰고 확인하는 핵심 동작을 남기는 쪽을 택한 것이다.

AWS 장애를 GCP로 피하는 것만으로는 부족한 이유
재해 복구를 다른 리전이나 다른 클라우드에 같은 소프트웨어로 복제하는 일로 생각하기 쉽다. Monzo가 겨냥한 위험은 클라우드 사업자 장애에만 있지 않다. 배포 과정의 실수, 공통 라이브러리의 결함, 운영 절차의 오류도 주 플랫폼을 멈출 수 있다. 같은 코드와 같은 서비스 구성을 다른 데이터센터에 복제했다면, 그 오류도 같이 옮겨 간다.
그래서 두 플랫폼은 서로 독립된 Kubernetes 클러스터, 데이터베이스, 큐, 잠금 장치 위에서 움직인다. 카드 결제를 승인하는 기능처럼 결과는 비슷해야 하는 부분도 별도 코드로 구현한다. Stand-in에는 18개 서비스만 둔다. Stand-in은 주 플랫폼의 축소판과 다른 별도 시스템이다. 장애 중 반드시 필요한 행위만 다시 정의했다.
이 선택은 데이터 복제 방식도 바꾼다. 두 환경에 모든 데이터를 강한 일관성으로 동시에 기록하면, 둘 중 하나가 멈춘 순간 쓰기를 성공으로 처리할 수 없다. 가용성을 높이려고 만든 이중화가 오히려 쓰기를 막는다. Monzo는 Stand-in에 필요한 잔액, 제한된 거래 이력, 카드·계좌 정보, 수취인 같은 최소 상태만 비차단 방식으로 동기화한다. 원장의 정확한 기록을 맡는 시스템까지 최종 일관성 데이터로 대체하지는 않는다.
고객에게 남기는 기능은 어떻게 달라지는가
평소 Monzo 앱은 AWS의 주 플랫폼을 본다. Stand-in이 켜지면 앱은 제한된 API를 통해 간소화된 계좌·거래 화면을 표시한다. 앱은 장애가 났다는 사실과 지금 쓸 수 있는 기능의 범위를 분명히 보여 준다. 결제와 이체처럼 우선순위가 높은 작업에 동작을 집중시키는 방식이다.
결제 경로도 두 겹이다. 주 플랫폼이 일부 살아 있으면 결제 메시지를 먼저 받은 뒤 Stand-in으로 프록시해 어떤 고객과 어느 범위를 넘길지 세밀하게 조절한다. 주 플랫폼이 완전히 멈추면 GCP의 Stand-in이 물리 데이터센터를 거쳐 결제 네트워크와 직접 연결할 수 있다. 직접 연결은 고객별 전환 제어가 줄어드는 선택이지만, 주 플랫폼을 거치지 않고 결제를 승인할 경로를 남긴다. 두 경로는 운영 환경에서 지속적으로 시험한다.
장애 중 처리한 결제는 원장에 어떻게 돌아오는가
Stand-in은 주 시스템의 원장을 대체하지 않는다. 장애 중 승인한 결제와 상태 변경은 Stand-in의 별도 상태에 기록하고, 그 효과를 내구성 있는 큐에 Monzo Advice로 남긴다. 주 플랫폼이 돌아오면 Advice Consumer가 이 기록을 읽어 원장과 하위 서비스에 그 효과를 그대로 적용한다.
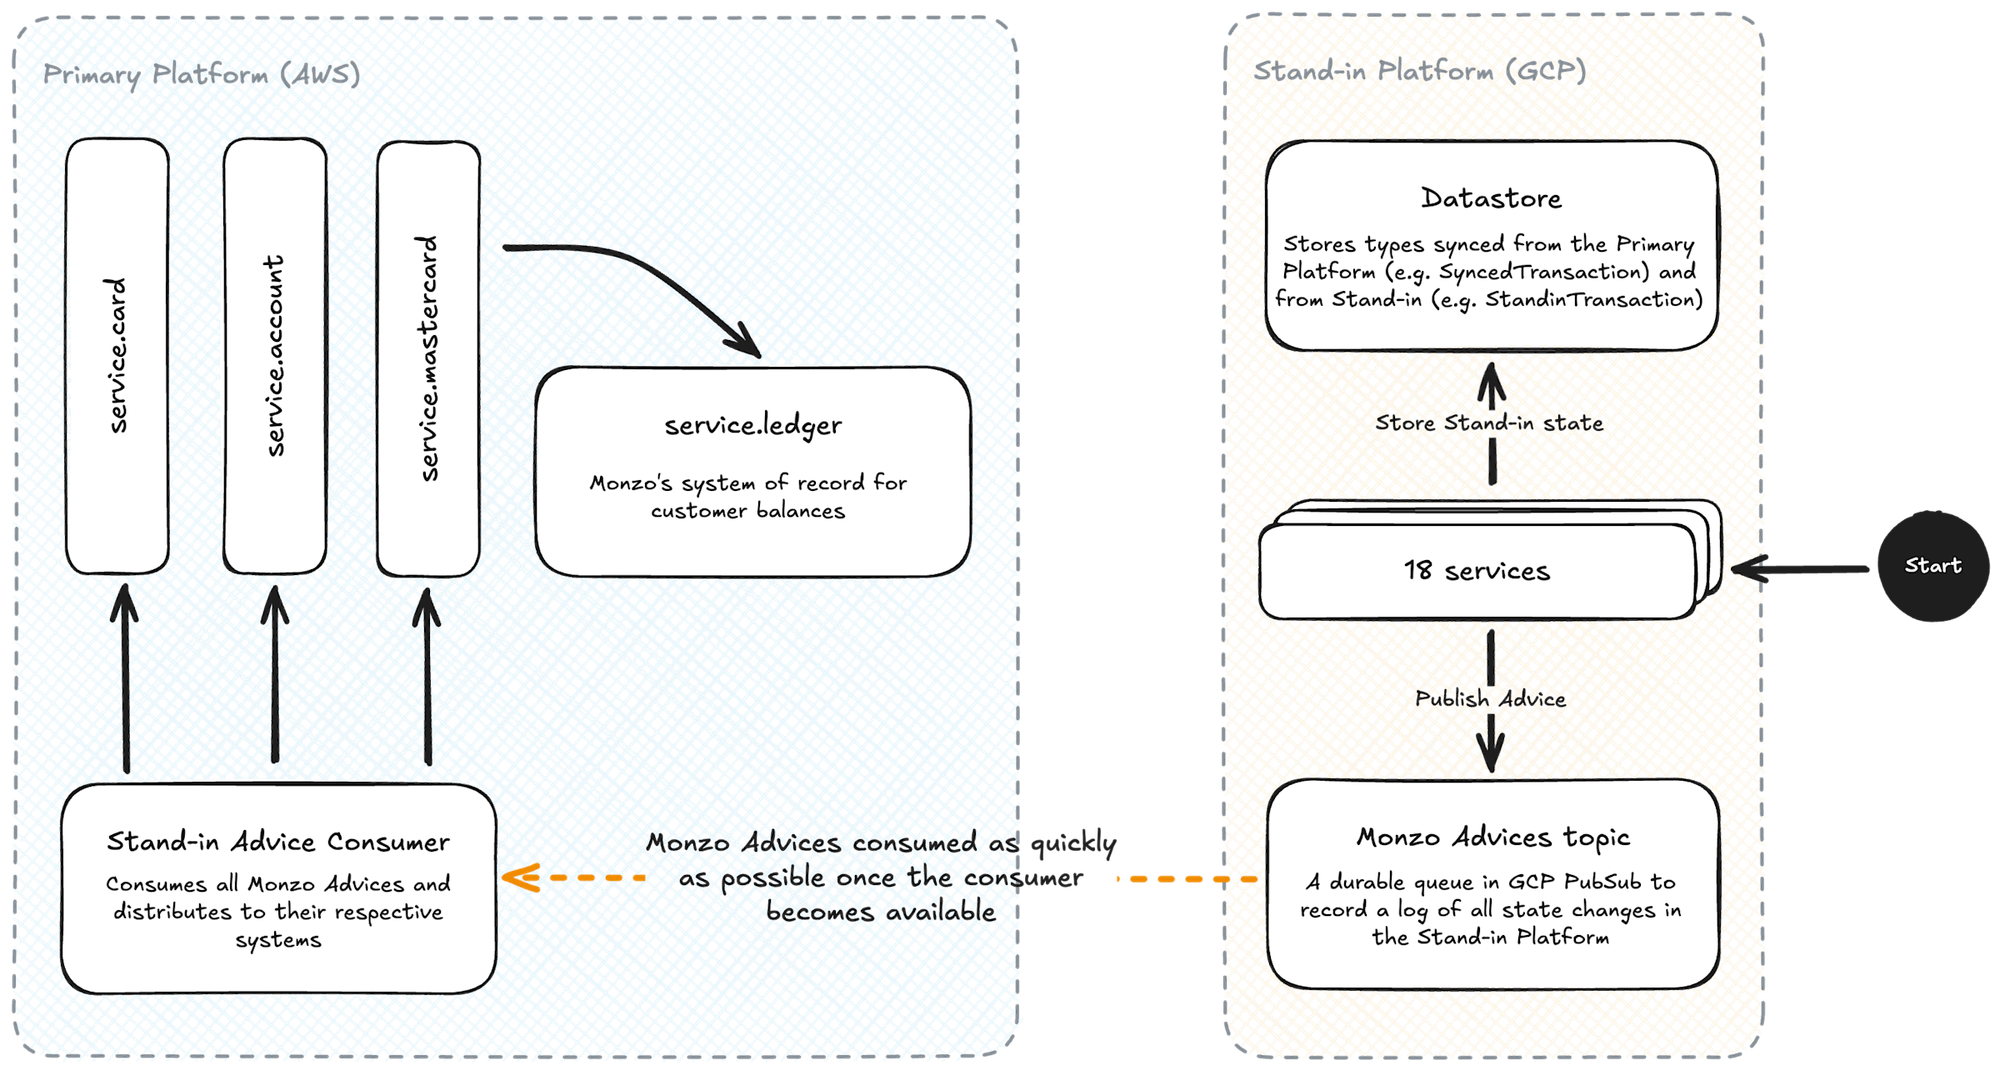
이 구조에는 의도된 비대칭이 있다. Stand-in의 잔액은 실시간에 가깝게 동기화되지만 완벽히 같은 시점의 값은 아니다. 따라서 Stand-in이 승인한 거래가 주 플랫폼 기준으로는 잔액 부족으로 보일 수 있고, Monzo는 그 결과를 주 플랫폼에서 그대로 반영한다. Monzo는 장애 중 승인한 결제를 계속 처리하고, 이후 주 플랫폼의 원장에 반영한다. 두 플랫폼의 숫자가 모든 순간 같은 값일 필요는 없다.
운영팀이 분리해야 할 것은 인프라 목록이 아니다
이 설계의 핵심은 같은 실패를 함께 겪지 않게 하는 분리다. 두 번째 클라우드만으로는 이를 보장하지 못한다. 서비스 수를 3,000개에서 18개로 줄인 데에는 비용 절감 외의 목적이 있다. 코드와 데이터, 운영 경로와 고객 경험까지 모두 복제하지 않고 핵심 거래를 계속시킬 영역만 남겼다. Monzo는 이 대기 환경의 상시 비용이 주 플랫폼의 약 1%이며, 전체 시스템을 같은 규모로 복제하면 컴퓨팅 자원과 유지 인력 때문에 총 플랫폼 비용이 두 배 가까이 될 수 있다고 설명한다.
결제·주문·계좌처럼 중단 시간이 바로 고객의 행동을 막는 서비스의 재해 복구 계획은, 장애 때 반드시 지켜야 할 거래를 고르는 데서 시작한다. 그 뒤에 필요한 최소 상태를 정하고 독립된 승인 경로와 복구 뒤 기록을 합치는 절차를 설계해야 한다. 이 사례의 Stand-in은 평소 시스템이 사라졌을 때 가장 중요한 거래를 계속하도록 설계된 작은 운영 체계다.
출처: Monzo, “Tolerating full cloud outages with Monzo Stand-in” (2025-02-13)