
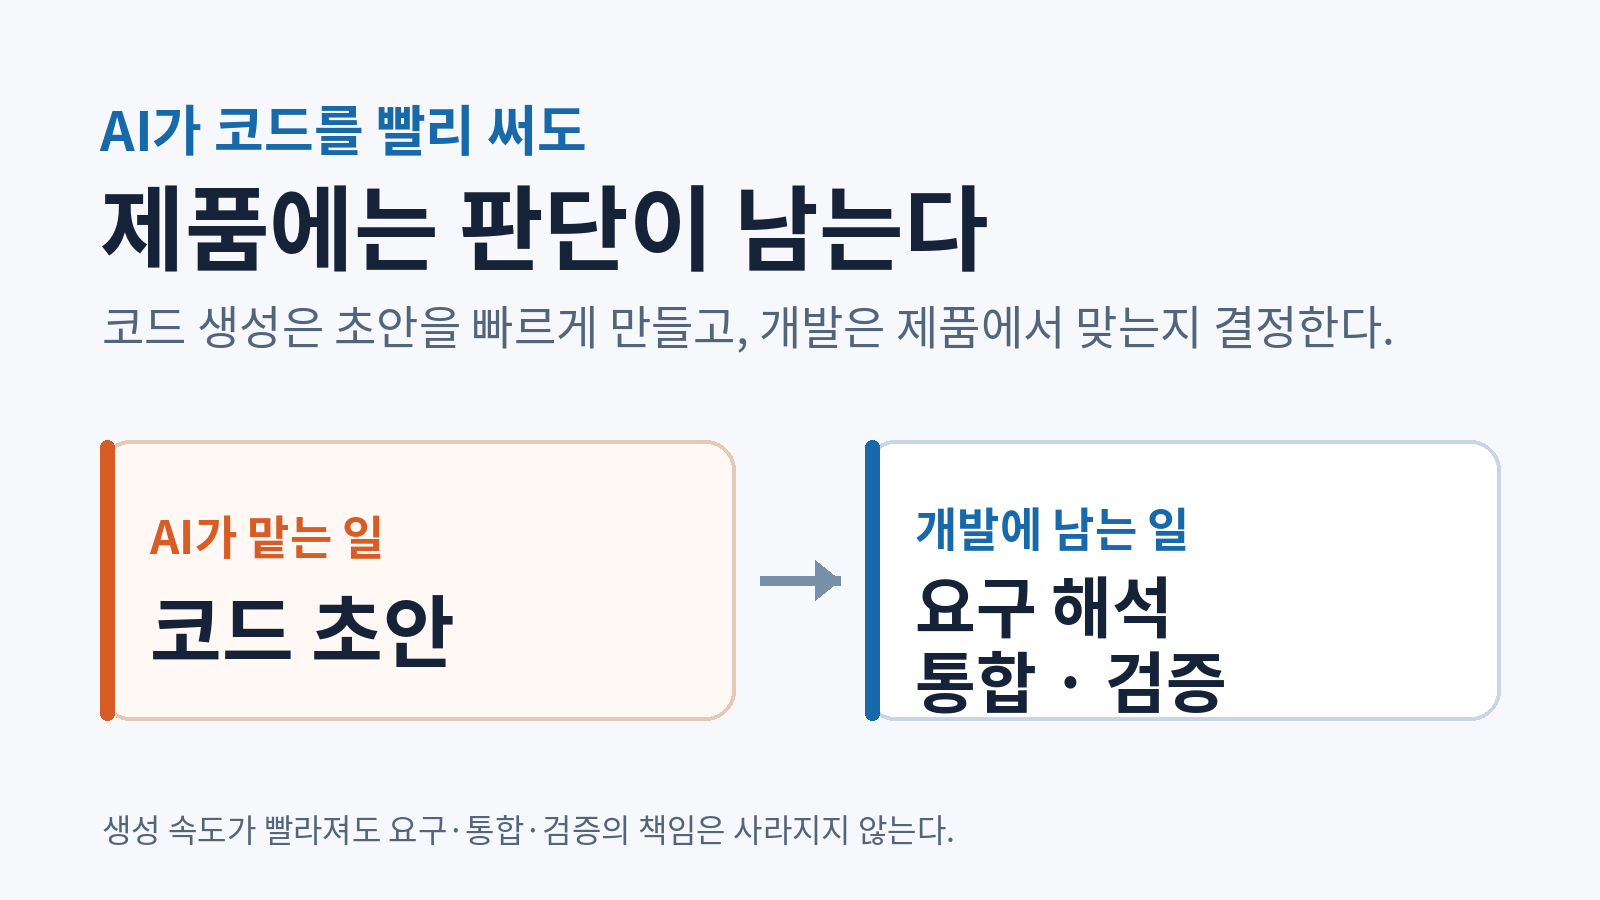
생성형 AI가 함수와 화면 코드를 빠르게 내놓기 시작했지만, 개발의 어려움이 사라진 것은 아니다. 2026년 8월 8일 Senko Rašić는 “무엇을 만들지 정하는 일만 어렵고 코딩은 쉽다”는 식의 말이 개발자가 쌓아 온 기술과 노동을 지워 버린다고 썼다. 이 글이 짚는 핵심은 코드 작성 속도와 소프트웨어를 제대로 만드는 능력을 같은 것으로 취급하면, AI를 쓰는 조직도 더 좋은 결과를 얻기 어렵다는 데 있다.
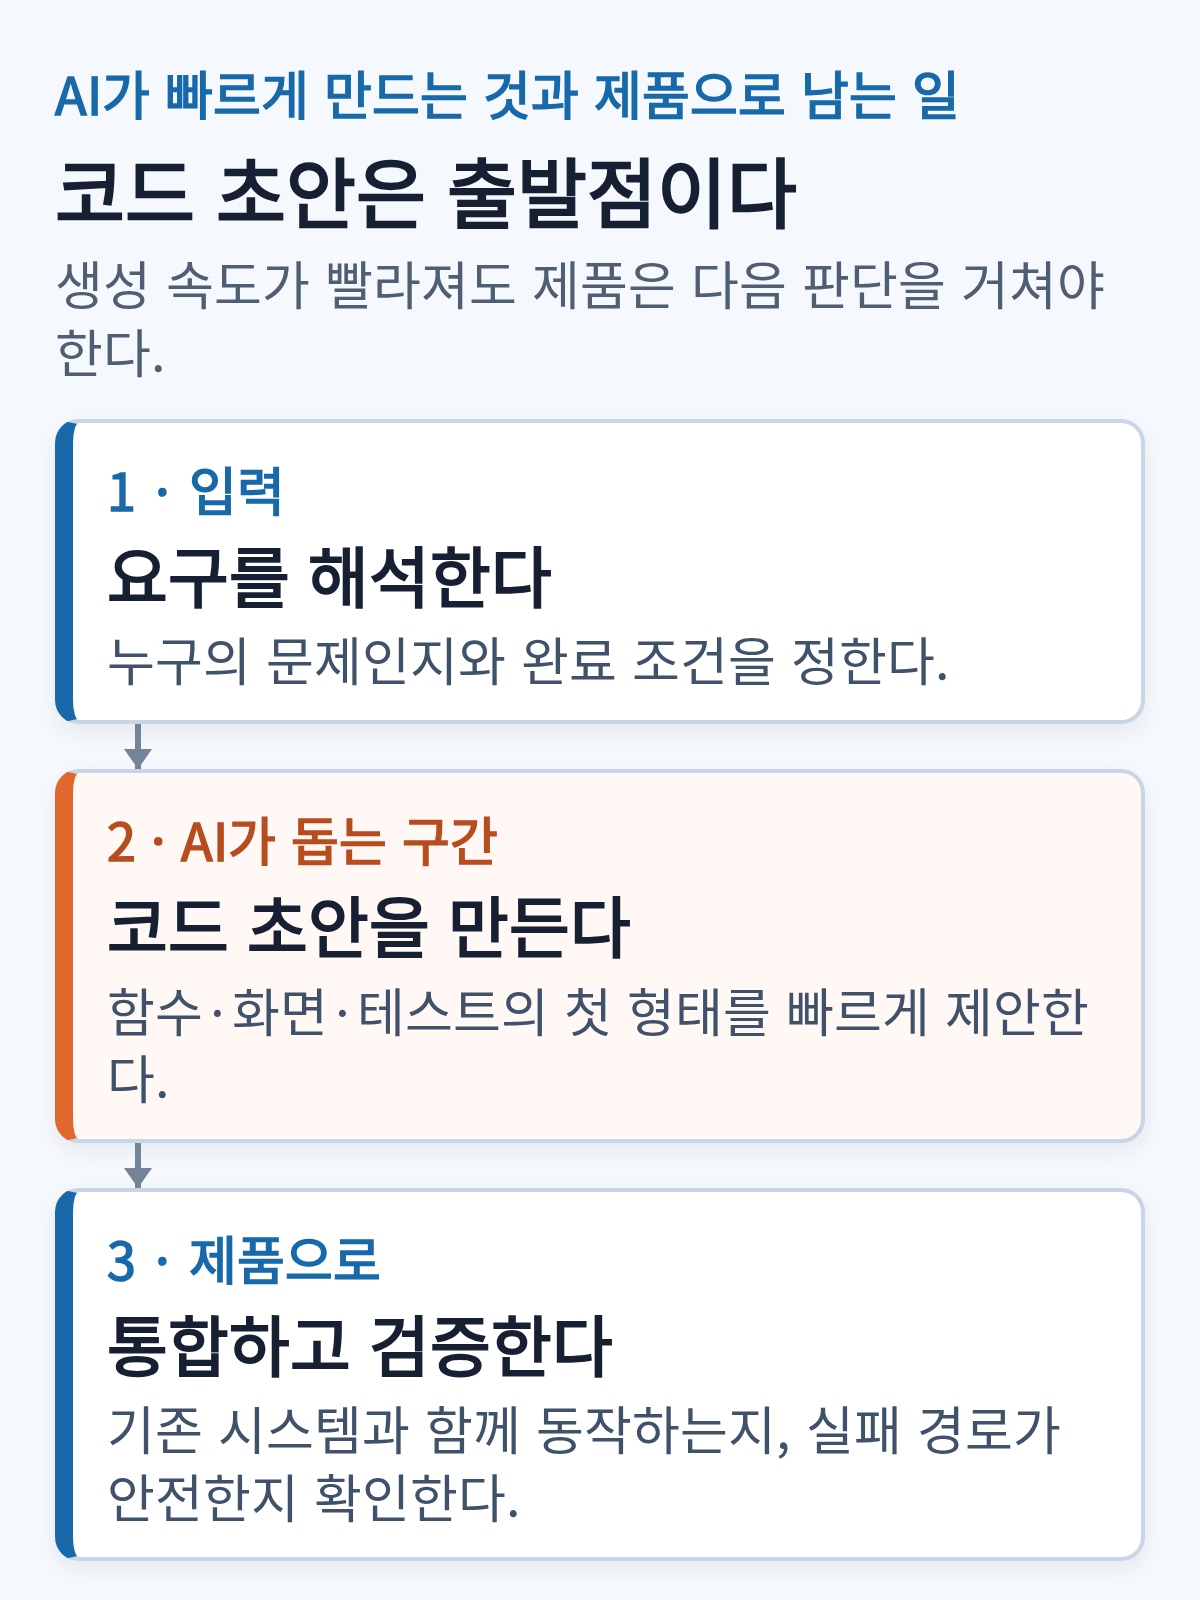
AI는 요구를 코드 조각으로 바꾸는 구간의 마찰을 낮춘다. 그러나 실제 제품은 그 코드가 기존 데이터, 인증, 배포 환경, 다른 팀의 변경과 만나도 의도대로 작동해야 한다. 생성 결과가 길어질수록 사람은 “무엇을 만들었는가”뿐 아니라 “무엇을 깨뜨렸는가”를 추적해야 한다. 코드를 타이핑하는 시간이 줄어도, 판단과 검증의 총량이 자동으로 줄지는 않는 이유다.
코드를 만든 뒤에는 무엇을 판단해야 하나
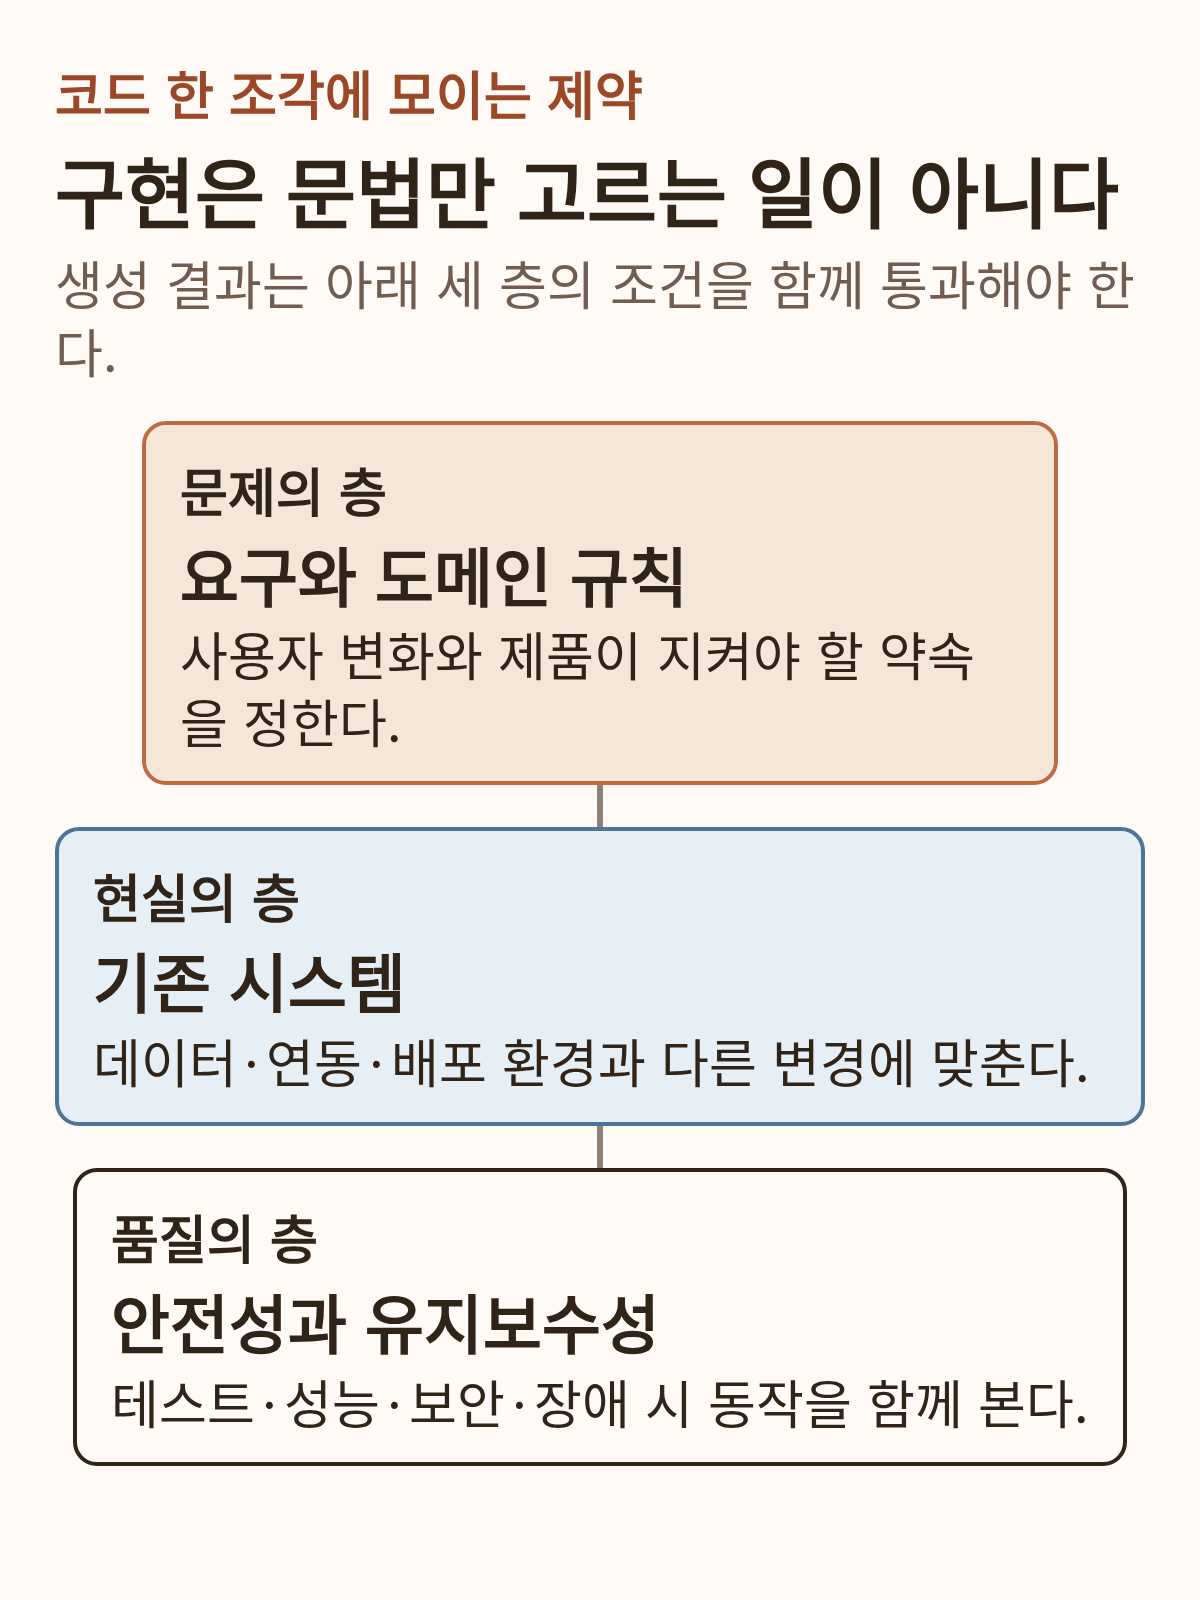
“코딩”에는 문법을 맞춰 문장을 입력하는 일보다 넓은 일이 들어 있다. 함수 하나를 바꿀 때도 기존 규칙을 읽고, 자료의 경계를 정하고, 실패했을 때의 동작을 고르고, 성능과 보안을 점검한다. AI가 제안한 구현은 이 선택들을 압축해 보여 줄 수는 있어도, 서비스가 지켜야 할 규칙을 대신 결정하지는 않는다.
예를 들어 주문 금액을 계산하는 코드를 생성할 수 있다. 그런데 할인 적용 순서, 세금의 반올림 시점, 취소 후 재계산, 여러 통화의 표시 규칙은 한 줄의 프롬프트에 자연스럽게 모두 담기지 않는다. 이 규칙이 코드베이스 여러 곳에 흩어져 있다면, 그중 하나만 맞는 코드도 전체 시스템에서는 버그가 된다. 좋은 구현은 답을 만드는 일인 동시에, 답이 성립하는 범위를 찾는 일이다.
“무엇을 만들지”와 “어떻게 만들지”를 갈라 놓으면 왜 실패하나
Rašić는 고객을 이해하고 우선순위를 맞추는 일이 프로젝트 성공에 중요하다는 사실과, 좋은 코드를 만드는 일이 숙련·인내·세부 주의·경험을 요구하는 기술이라는 사실을 함께 둔다. 둘 중 하나를 다른 하나의 하위 업무로 취급하지 말자는 주장이다. 판매가 약속한 기능이 실제 고객 요구를 겨냥했더라도, 운영 가능한 형태로 만들지 못하면 약속은 제품이 되지 않는다. 반대로 우아한 구조가 사용자 문제와 닿지 않으면 그 구조도 가치를 만들지 못한다.
AI 도구를 도입할 때도 이 구분이 실무의 책임 경계를 흐린다. “AI가 만들었으니 개발자는 검토만 한다”는 역할 정의는 검토의 난도를 과소평가한다. 낯선 변경이 많아질수록 리뷰어는 원래 설계 의도와 새 코드의 가정을 비교해야 하고, 테스트가 놓친 경로를 상상해야 한다. 따라서 AI가 빠르게 초안을 낼수록 작은 변경, 명확한 완료 조건, 실행 가능한 테스트, 되돌릴 수 있는 배포 단위가 더 중요해진다.
AI 시대에 더 값비싸지는 개발 역량은 무엇인가
저자는 프로그래머가 과거의 도구에 머물 이유도, AI가 만든 코드를 무조건 거부할 이유도 없다고 본다. 변화는 받아들이되 호기심과 비판을 같이 가져야 한다는 태도다. 실제로 언어와 도구가 바뀌면 예전의 반복 작업 일부는 사라진다. Rašić가 든 펀치카드, 어셈블리, COBOL, C·C++의 메모리 오류 대응 경험처럼, 한때 필수였던 기술은 새 추상화 뒤로 물러난다.
그럼에도 시스템은 더 복잡해지고 유지보수는 계속된다. 사용자는 더 많은 것을 더 낮은 비용에 원하고, 자신의 요구를 완전히 표현하지 못한다. 사업의 요구와 사용자의 요구도 계속 충돌한다. 이 조건에서는 AI에게 질문을 잘하는 능력만으로 충분하지 않다. 코드가 실행되는 경로를 읽고, HTTP와 데이터 흐름 같은 기반을 이해하고, 결과가 틀렸을 때 원인을 좁히는 능력이 남는다.
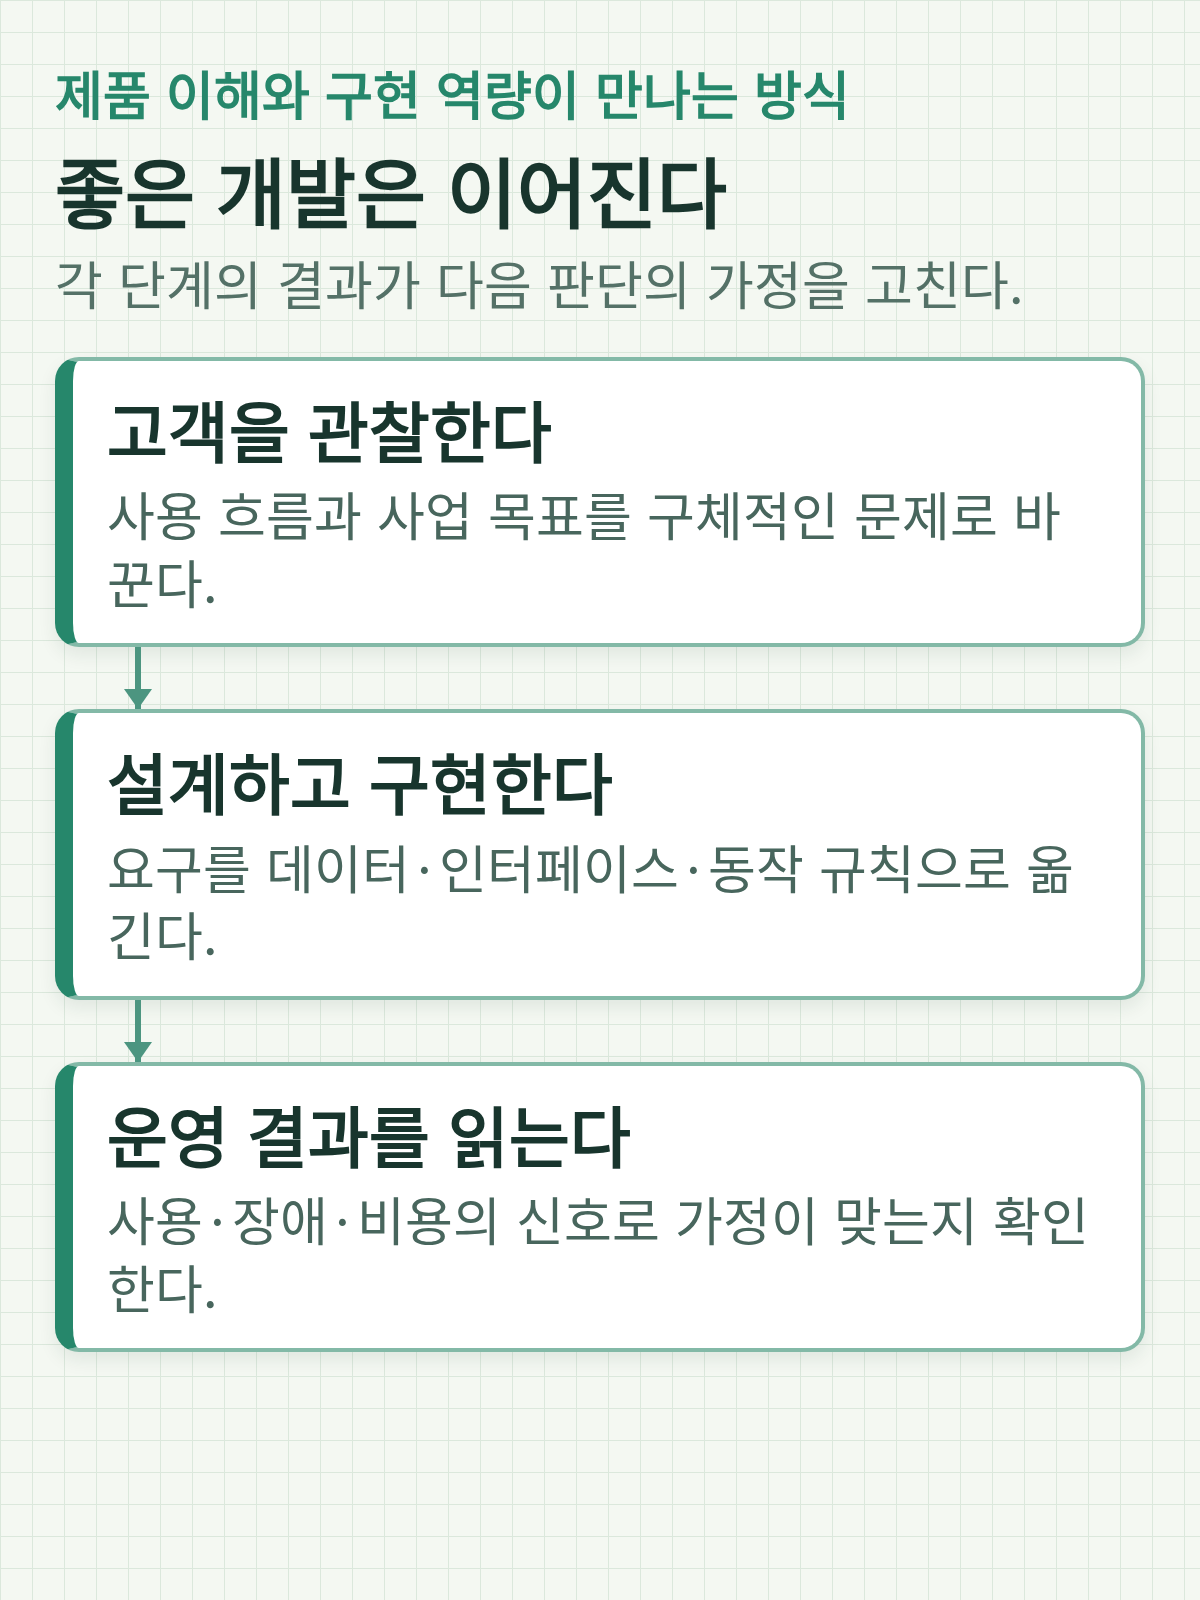
경력 초반 개발자에게는 알고리즘·자료구조와 메모리·네트워크의 기본을 배우라는 저자의 권고가 특히 실용적이다. 경력이 쌓인 개발자에게는 사용자 경험, 고객 인터뷰, 사업 전략처럼 인접한 일을 이해하라는 권고가 이어진다. 전자는 생성된 결과를 평가할 기술적 기준을 만들고, 후자는 어떤 결과를 만들 가치가 있는지 판단할 기준을 넓힌다.
AI를 빠른 작성 도구로 쓰되 판단을 넘기지 않는 방법
팀은 AI에게 큰 기능 전체를 한 번에 맡기기보다, 바꿀 파일과 바꾸지 않을 경계를 먼저 정할 수 있다. 다음으로 기존 동작을 보이는 테스트를 확보하고, 생성 결과를 작은 변경으로 나눠 검토한다. 마지막으로 관측 지표와 되돌리기 절차를 준비해 배포 뒤의 실제 동작을 확인한다. 이 순서는 AI가 만든 코드의 출처를 따지는 절차가 아니라, 어떤 코드든 제품에 넣기 전에 필요한 개발 절차다.
AI가 코드를 더 많이 쓰게 만들수록 개발자의 역할은 줄어들기보다 이동한다. 요구를 구조화하고, 생성물의 가정을 찾아내고, 시스템 전체에서 안전한 변경인지 판정하는 일이 앞에 나온다. 코드는 결코 유일한 어려움이 아니지만, 그렇다고 쉬운 부분으로 밀어낼 수도 없다. 좋은 소프트웨어는 고객을 이해하는 일과 구현을 이해하는 일이 만나는 자리에서 나온다.
출처: Senko Rašić, “Code was never the hard part” is an insult to all programmers (2026-08-08)