
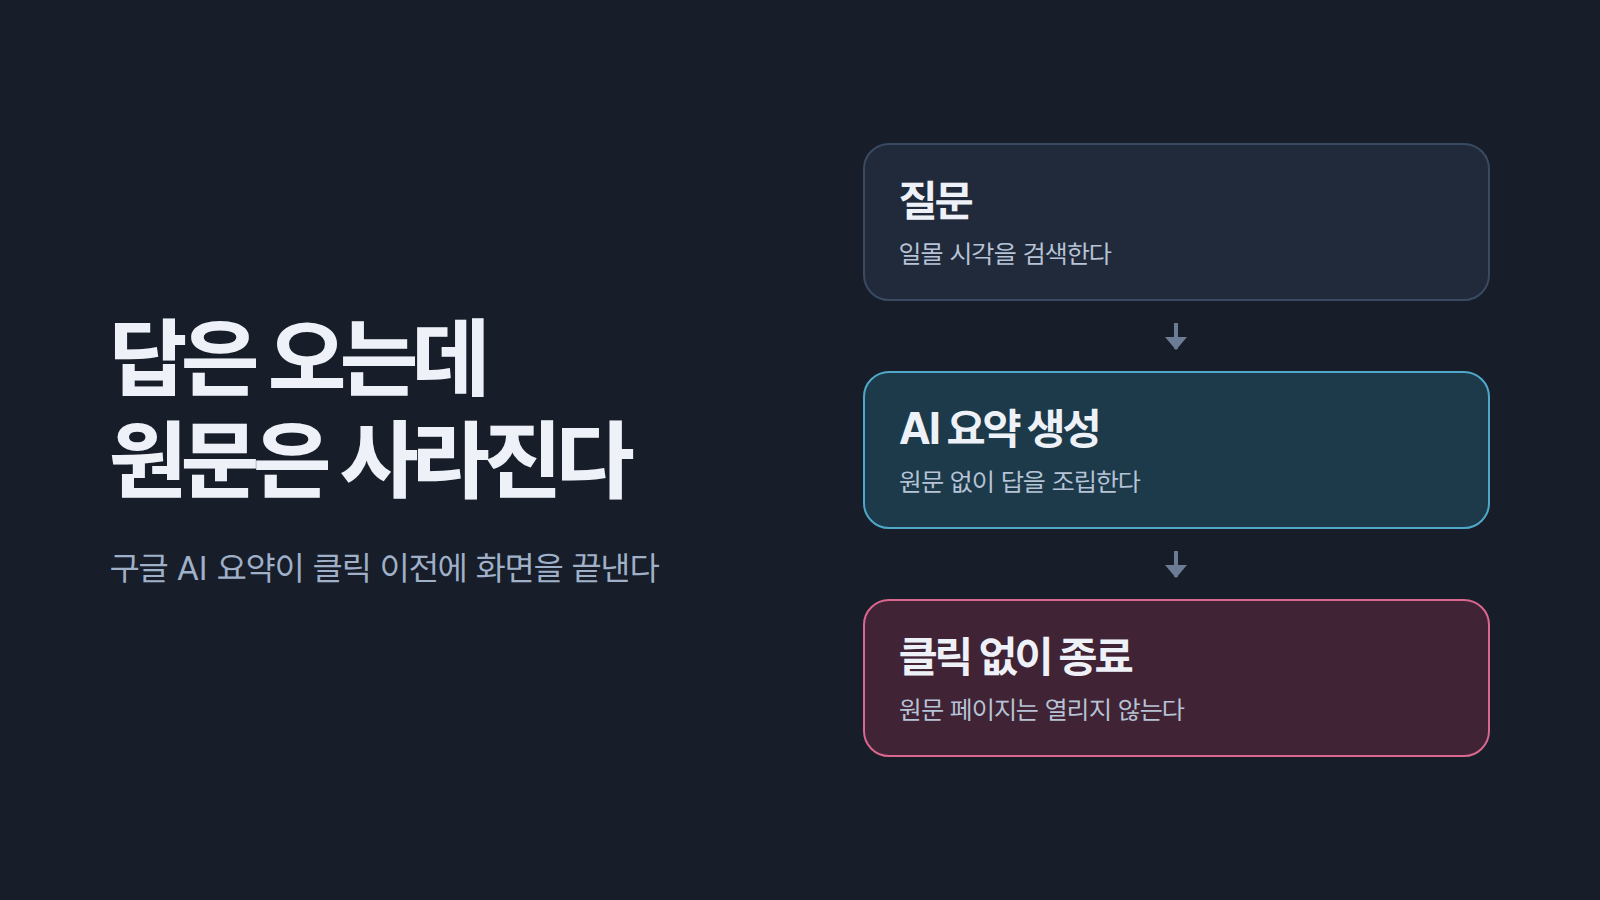
구글에서 일몰 시각을 검색하면 AI 요약이 먼저 답을 보여준다. 최근 몇 주 사이 미국 콜로라도 스프링스를 비롯한 여러 지역 이용자들은 이 요약이 이미 지나간 일몰 시각을 알려주는 것을 목격했다. 사소해 보이는 오류지만, The Walrus는 2026년 8월 10일자 기사에서 이 현상이 검색을 지배해 온 회사가 기본적인 사실조차 놓치기 시작했다는 신호라고 짚었다. 더 큰 문제는 따로 있다. 구글이 원문과 이용자 사이에 오류가 섞인 AI 요약을 끼워 넣으면서, 원문 페이지 자체는 존재해도 사실상 찾아지지 않는 상태가 되고 있다는 점이다.
이 변화는 단순한 검색 품질 저하가 아니다. 원문 클릭 없이 요약만으로 질문이 끝나면, 원문을 만든 언론사·백과사전·아카이브는 트래픽과 그에 따르는 수익을 잃는다. 그 결과 원문 자체가 줄어들거나 사라지고, 다음 AI 요약이 참조할 원문도 함께 줄어드는 순환이 만들어진다.

왜 원문이 있어도 찾을 수 없게 되나
웹은 원래도 링크 부패로 매일 페이지를 잃어 왔다. 미국 의회도서관 웹사이트에서 코딩 오류로 미국 헌법 주요 조항이 한동안 사라졌던 사례처럼, 마모는 늘 있었다. 하지만 지금 벌어지는 일은 다르다. 구글이 오류가 섞이기 쉬운 AI를 원문과 이용자 사이에 끼워 넣으면서, 원문 페이지가 살아 있어도 검색 결과에서 사실상 발견되지 않는 상태를 만든다는 것이다. 여기에 더해 정보 오염은 상류로도 번지고 있다. 404 Media는 기업들이 AI 검색이 만드는 답변에 영향을 주려고 Reddit에 콘텐츠를 심고 있다고 보도했는데, 이는 AI 요약이 참조하는 공개 기록 자체를 오염시키는 방식이다.
도서 금지는 눈에 보이는 절차를 거친다. 학교운영위원회 회의, 반대 여론, 언론 보도가 뒤따르고 금지된 책도 다른 경로로 찾을 수 있다. 반면 디지털 페이지 하나가 조용히 지워지면, 그 페이지가 존재했다는 사실조차 아는 사람이 거의 남지 않는다.
이미 사라졌거나 흔들리는 기록들은 무엇인가
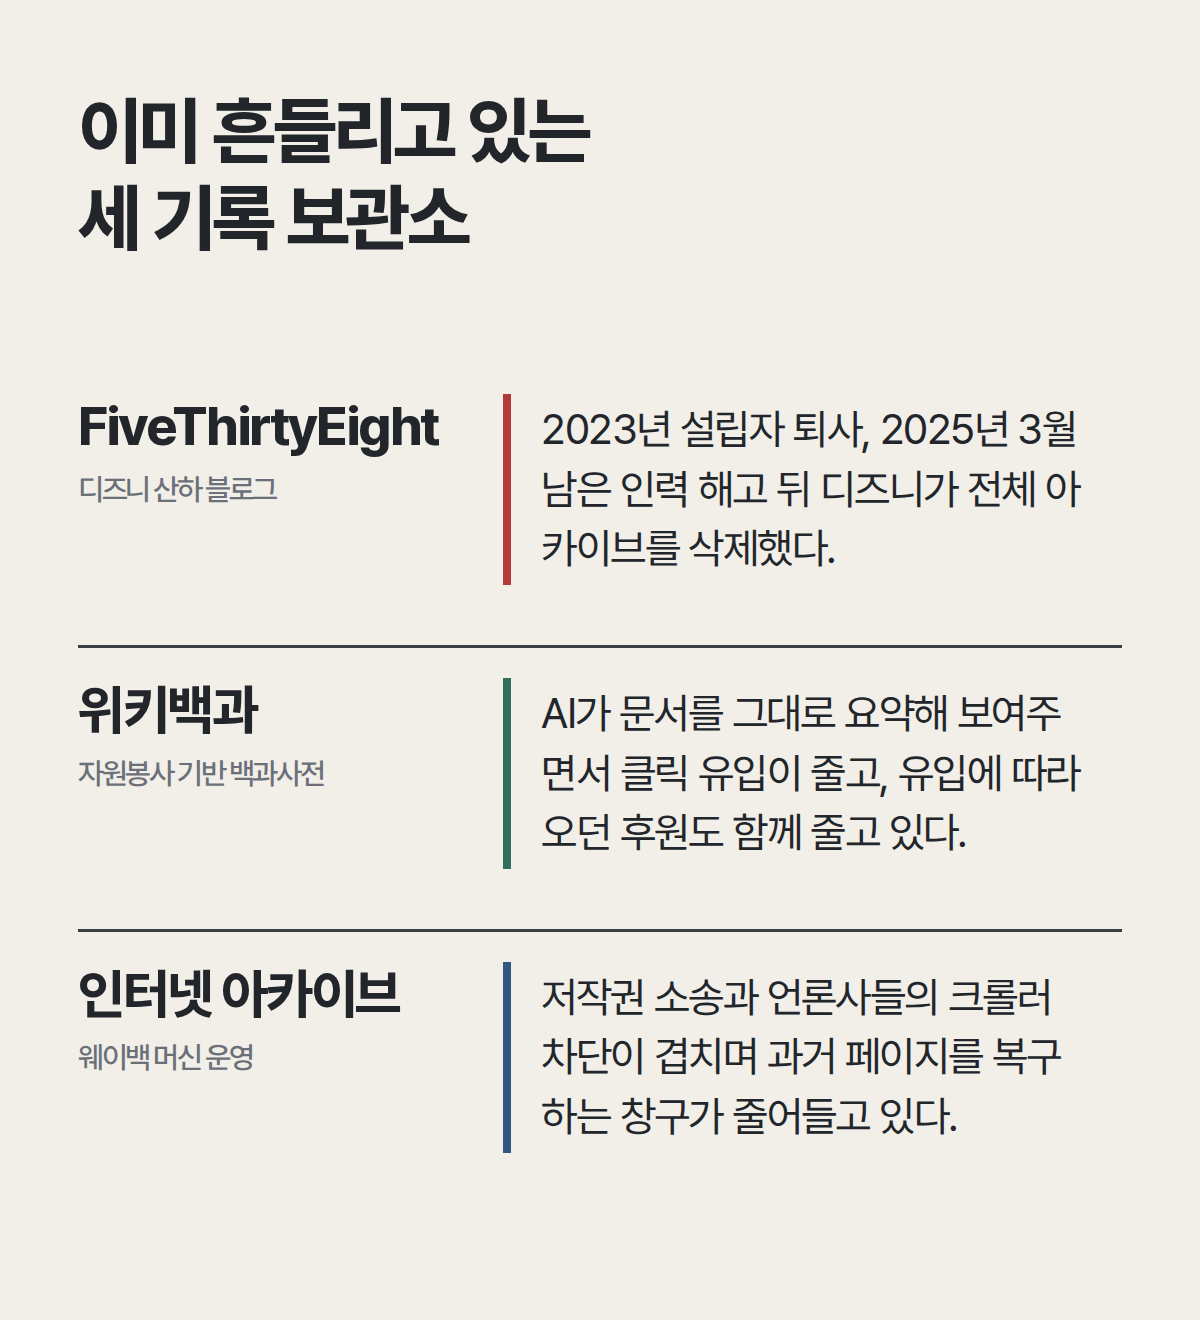
여론조사 분석과 정치·경제 블로그로 유명했던 FiveThirtyEight는 디즈니 자회사가 10년 넘게 소유해 온 사이트였다. 설립자 네이트 실버는 2023년 떠났고, 2025년 3월 남은 인력이 해고됐다. 새 저널리즘도 광고 수익도 없다고 판단한 디즈니는 사이트 전체 아카이브를 삭제했다.
위키백과도 같은 압력을 받고 있다. 오랫동안 검색엔진은 수십억 명의 이용자를 위키백과 문서로 직접 보냈지만, 이제 AI 시스템은 결과를 보여줄 때 위키백과 내용을 그대로 긁어와 제시하면서 이용자가 원문을 클릭할 필요를 없앤다. 그 결과 방문자 수가 줄면 관심과 후원도 줄어, 백과사전을 유지해 온 자원 자체가 흔들린다.
비영리 디지털 도서관인 인터넷 아카이브와 수천억 개의 웹 스냅샷을 보관한 웨이백 머신도 마찬가지다. 출판사들이 인터넷 아카이브의 디지털 대출 프로그램을 무단 복제로 걸어 소송에서 이긴 뒤, 언론사들은 저작권 있는 자료가 AI 기업에 간접적으로 흘러갈 것을 우려해 웨이백 머신의 크롤러를 차단하기 시작했다. 새로운 차단이 하나씩 쌓일 때마다 웨이백 머신이 웹의 최종 백업으로 기능할 여지도 줄어든다.
정부는 이 문제에 어떻게 대응하고 있나
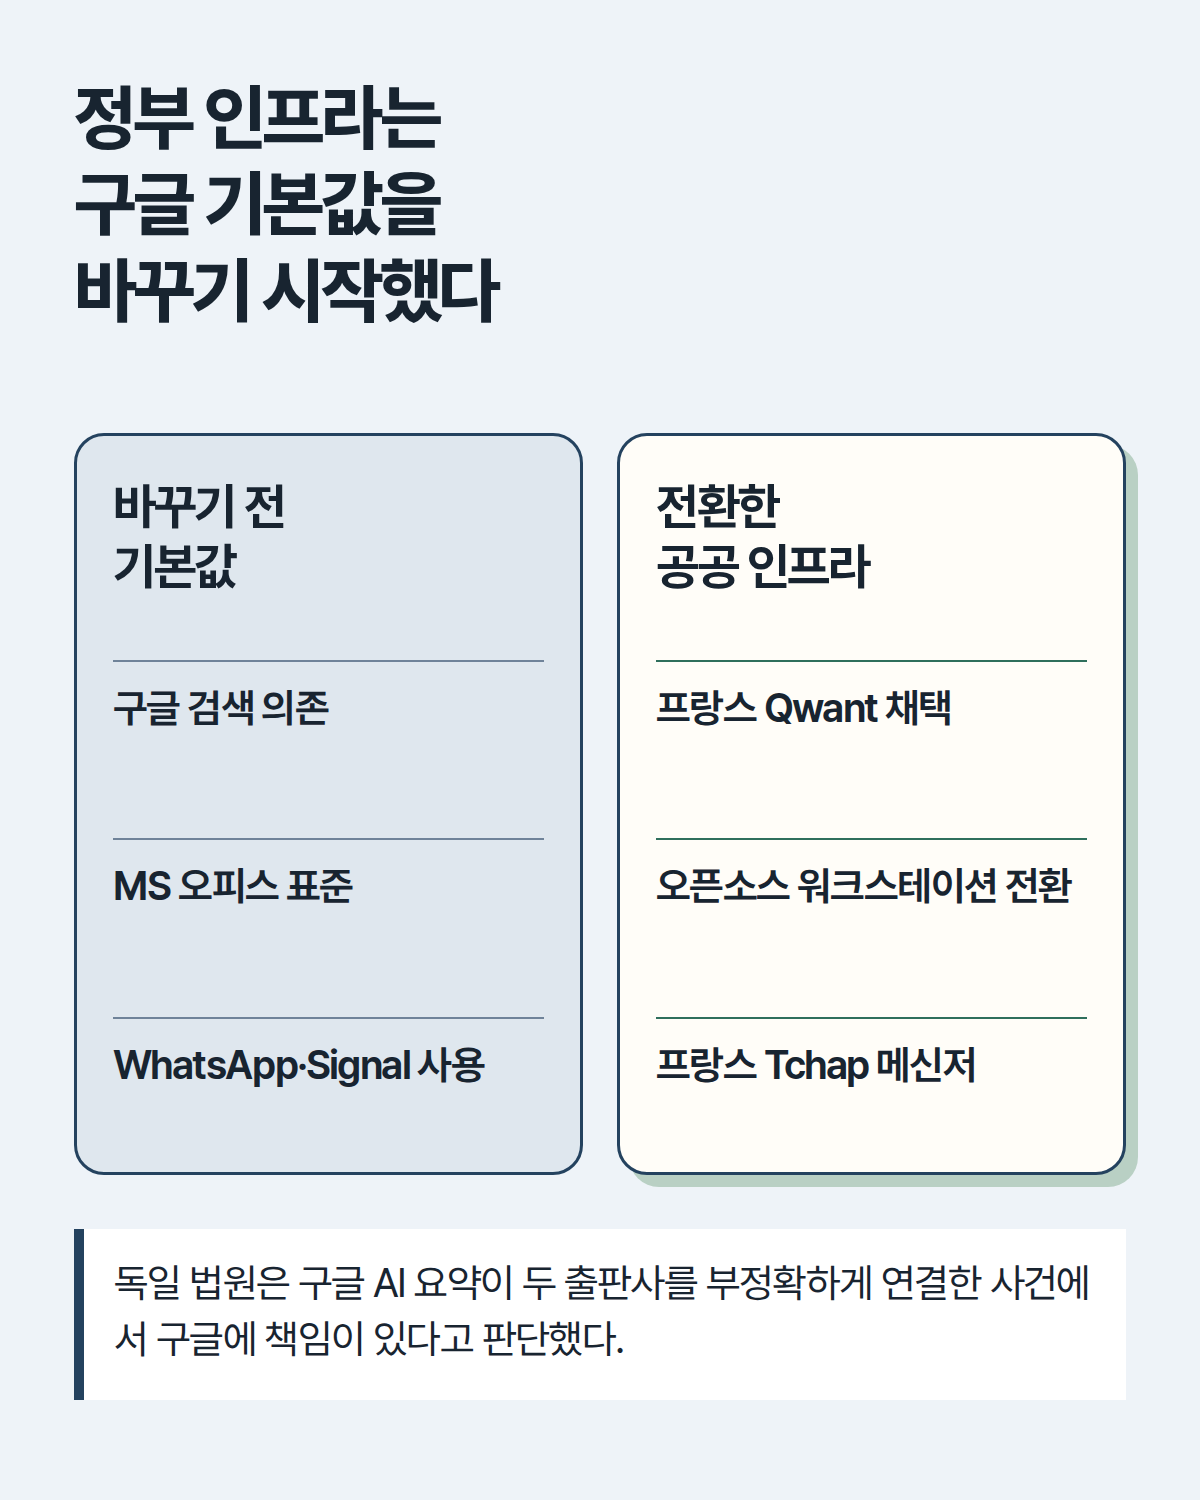
일부 정부는 이미 구글 의존을 줄이는 쪽으로 움직였다. 프랑스는 2018년 말부터 국민의회와 국방부가 사용자 데이터를 저장하지 않고 맞춤 광고도 쓰지 않는 유럽산 검색 서비스 Qwant를 도입했다. 720명의 선출직 의원과 수천 명의 행정 인력을 둔 유럽의회도 같은 선택을 했다. 프랑스는 공무원용 메신저도 WhatsApp·Signal 같은 외국 플랫폼 대신 자체 개발한 Tchap으로 바꾸도록 했고, 유럽 각국 정부는 수십만 대의 업무용 컴퓨터에서 Microsoft 제품을 오픈소스 대안으로 교체했다. 덴마크 디지털화 장관 캐롤라인 스테이지 올센은 “너무 많은 공공 디지털 인프라가 소수의 외국 공급업체에 묶여 있고, 이것이 우리를 취약하게 만든다”고 말했다.
법적 판단도 나왔다. 독일 법원은 최근 구글의 AI 개요 기능이 만들어 낸 허위 진술에 대해 구글에 책임이 있다고 판결했다. 구글의 AI가 두 출판사를 부정확한 사업 관행과 잘못 연결한 사건에서, 법원은 검색엔진이 공개 기록을 단순히 가리키는 데 그치지 않고 정보를 추출·재작성해 새로운 콘텐츠 층을 만들어 낸 이상 편집 책임도 함께 진다고 봤다. 구글은 이 판결에 항소했지만, 해외 기술 기업이 정보의 수동적 통로가 아니라는 판단이 나온 이상 각국 정부가 이들을 규제할 여지도 넓어졌다.
공공 기록 보존을 자원봉사에만 맡길 수 있는가
위키백과와 웨이백 머신은 지금까지 자원봉사와 기부만으로 운영돼 왔지만, 도로를 승차공유 기업이 관리하지 않고 결제 앱이 통화정책을 정하지 않는 것처럼, 공공 디지털 인프라도 같은 층위의 거버넌스가 필요하다는 지적이 나온다. 캐나다에는 이미 연방 웹 기록과 역사 정보를 보존하는 캐나다 도서관·기록보관소, 그리고 캐나다 대학에 데이터를 백업하는 인터넷 아카이브 캐나다 같은 자산이 있다. 1990년대 SchoolNet과 Community Access Program이 학교와 도서관을 인터넷에 연결했던 것처럼, 공공 기관이 먼저 나서 디지털 삶을 조직한 전례도 있다.
결국 관건은 지금 무엇이 남아 있느냐가 아니라, 누가 그것을 보존할 동기와 권한을 갖느냐다. AI 요약이 원문보다 먼저 도착하는 지금의 구조가 이어지면, 다음 세대가 참조할 수 있는 원문 자체가 줄어드는 흐름을 막을 사람이 마땅치 않다.