
컨테이너 이미지를 배포하는 조직은 대개 두 가지 요구를 번갈아 마주한다. 처음에는 설치와 운영을 가볍게 시작하고 싶고, 레지스트리가 배포 경로의 중심이 된 뒤에는 한 대의 장애가 이미지 내려받기와 배포 전체를 멈추지 않게 해야 한다. zot는 OCI 네이티브 레지스트리를 정적으로 빌드한 단일 Go 바이너리로 제공하면서도, 동기화와 클러스터 기능을 조합해 이 두 요구를 서로 다른 배치 방식으로 풀도록 설계했다.
여기서 단일 바이너리는 배포 단위가 단순하다는 뜻이지, 운영 규모가 한 프로세스에 고정된다는 뜻은 아니다. 같은 zot를 한 대로 실행해 로컬 저장소를 쓰거나, 여러 독립 인스턴스로 늘려 고가용성 구성을 만들거나, v2.1.0 이후 내장된 확장 클러스터로 요청과 저장소를 나눌 수 있다. 중요한 것은 세 구성이 해결하려는 문제가 서로 다르다는 점이다.
한 개의 실행 파일에서 세 가지 운영 경로가 갈린다
가장 작은 경로는 zot 한 인스턴스와 저장소 하나다. OCI Distribution·Image 사양을 따르는 레지스트리를 별도 제어 평면 없이 올릴 수 있으므로, 사내 개발용 이미지 보관소나 제품의 초기 배포 경로처럼 운영 요소를 적게 두고 싶은 곳에 맞는다. zot 문서는 이미지뿐 아니라 OCI 아티팩트를 저장·공유하는 레지스트리로 설명하며, skopeo·regclient·oras·Helm·crane 같은 클라이언트 예시도 제공한다.
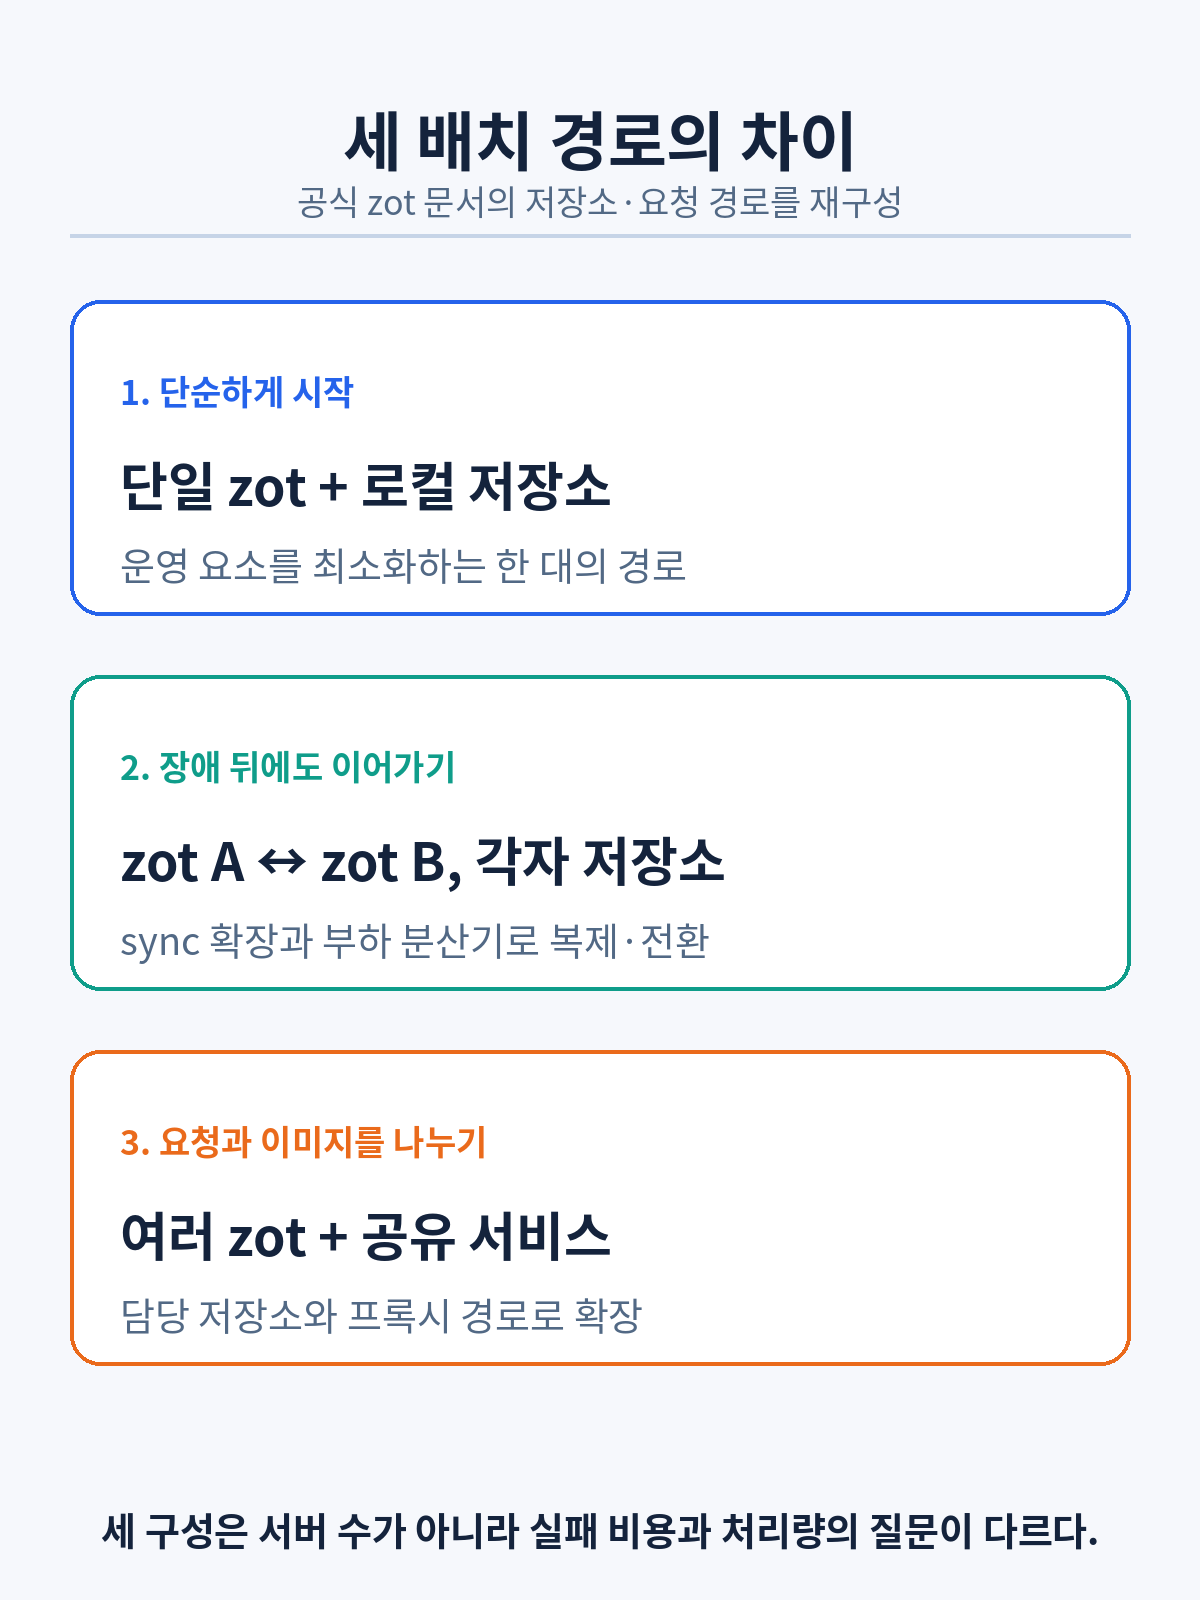
가용성이 먼저 필요한 경우에는 인스턴스를 단순히 여러 대 띄우는 대신 각 인스턴스에 별도 저장소를 두고 sync 확장으로 내용을 복제한다. 부하 분산기는 요청을 활성 zot로 보내고, 활성/대기 구성에서는 대기 zot가 활성 zot를 주기적으로 미러링한다. 활성/활성 구성에서는 두 zot가 서로를 미러링하며 부하 분산기 또는 DNS 기반 라우팅으로 요청을 나눌 수 있다. 이 방식은 공유 저장소 하나에 모든 인스턴스를 묶지 않아, 저장소 자체의 장애까지 같은 실패 지점으로 만들지 않는다는 것이 zot 문서가 구분하는 장점이다.
고가용성의 핵심은 복제 주기와 전환 경로다
동기화 기반 HA는 쓰기 직후의 최신 이미지까지 즉시 두 저장소에 존재한다고 가정해서는 안 된다. zot의 주기 동기화는 마지막 동기화와 다음 동기화 사이에 실패 창을 만든다. 활성 zot에 새 이미지가 올라온 직후 장애가 나면 대기 zot에는 그 이미지가 아직 없을 수 있다. 문서가 동기화 간격을 실용적인 범위에서 최대한 짧게 유지하라고 권하는 이유다. 배포 파이프라인에서는 이미지 푸시 성공과 대기 저장소에서의 가용성을 같은 사건으로 보지 않고, 전환 시 필요한 이미지가 복제됐는지를 운영 조건으로 따로 다뤄야 한다.
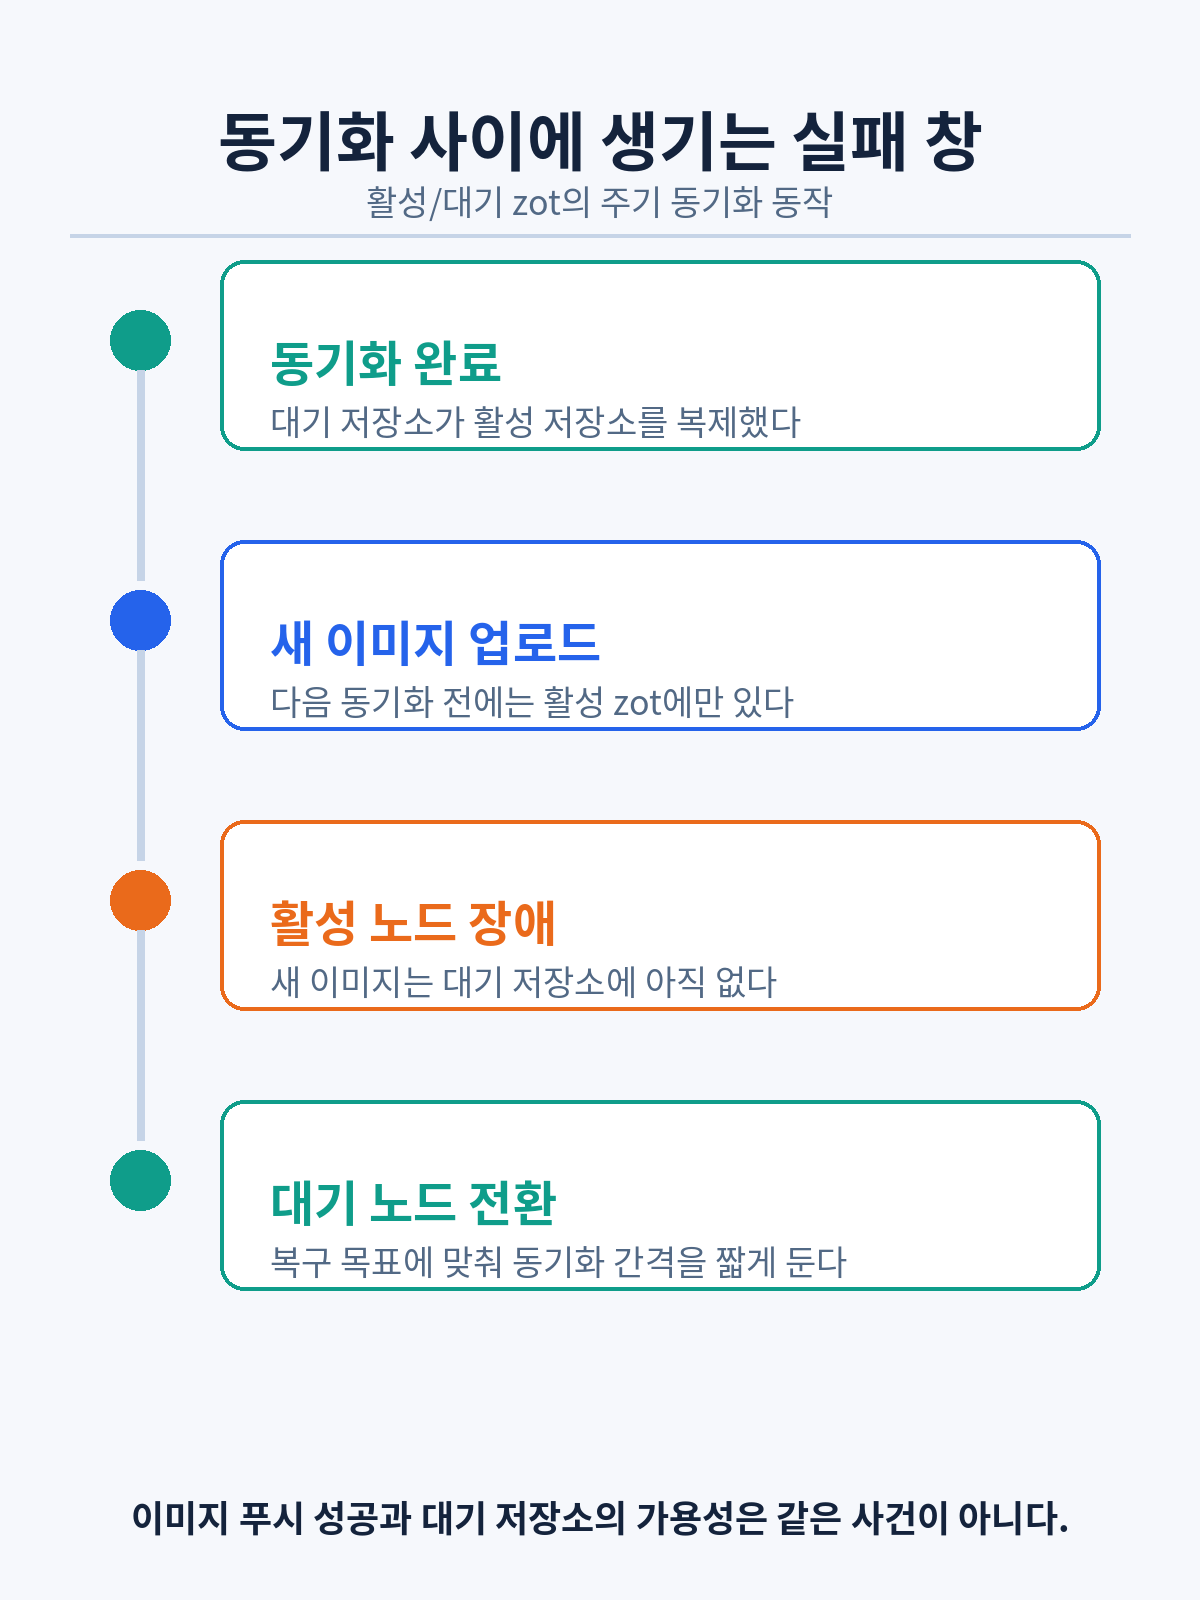
활성/활성은 두 인스턴스가 모두 요청을 받는 만큼 전환 대기 시간을 줄일 수 있지만, zot 문서는 이 구성에 경로 기반 라우팅을 요구한다. 반면 활성/대기는 부하 분산기가 한쪽으로만 보내다가 장애를 감지하면 대기 쪽으로 넘기는 구조다. 따라서 "두 대"라는 숫자보다 요청을 어디로 보내고, 어느 저장소가 어떤 시점의 이미지를 갖는지, 장애 감지가 무엇을 전환하는지를 먼저 정해야 한다.
확장 클러스터는 HA와 다른 질문에 답한다
이미지 수나 요청률이 커졌을 때의 선택지는 zot의 확장 클러스터다. v2.1.0부터 제공되는 이 기능은 저장소 이름의 경로를 SipHash로 계산해 담당 인스턴스를 정한다. 요청을 받은 zot가 다른 인스턴스가 담당하는 저장소를 만나면 그곳으로 전달하고 프록시로 응답을 돌려준다. 각 저장소는 한 zot 인스턴스가 맡고, 해당 저장소에 쓰기도 그 인스턴스만 수행한다. 앞단 부하 분산기는 어느 저장소를 누가 맡는지 알 필요 없이 임의의 인스턴스로 요청을 보낼 수 있다.
연산만 확장하는 구성에서는 모든 zot가 공통 캐시와 S3 호환 저장소를 공유한다. UI나 zli까지 클러스터에서 쓰려면 세션 정보도 공유해야 하며, v2.1.9 이상은 외부 Redis 호환 세션 저장소를 설정할 수 있다. 반대로 로컬 캐시와 로컬 저장소를 노드별로 두는 연산·저장소 확장 구성도 지원하지만 UI는 지원하지 않는다.
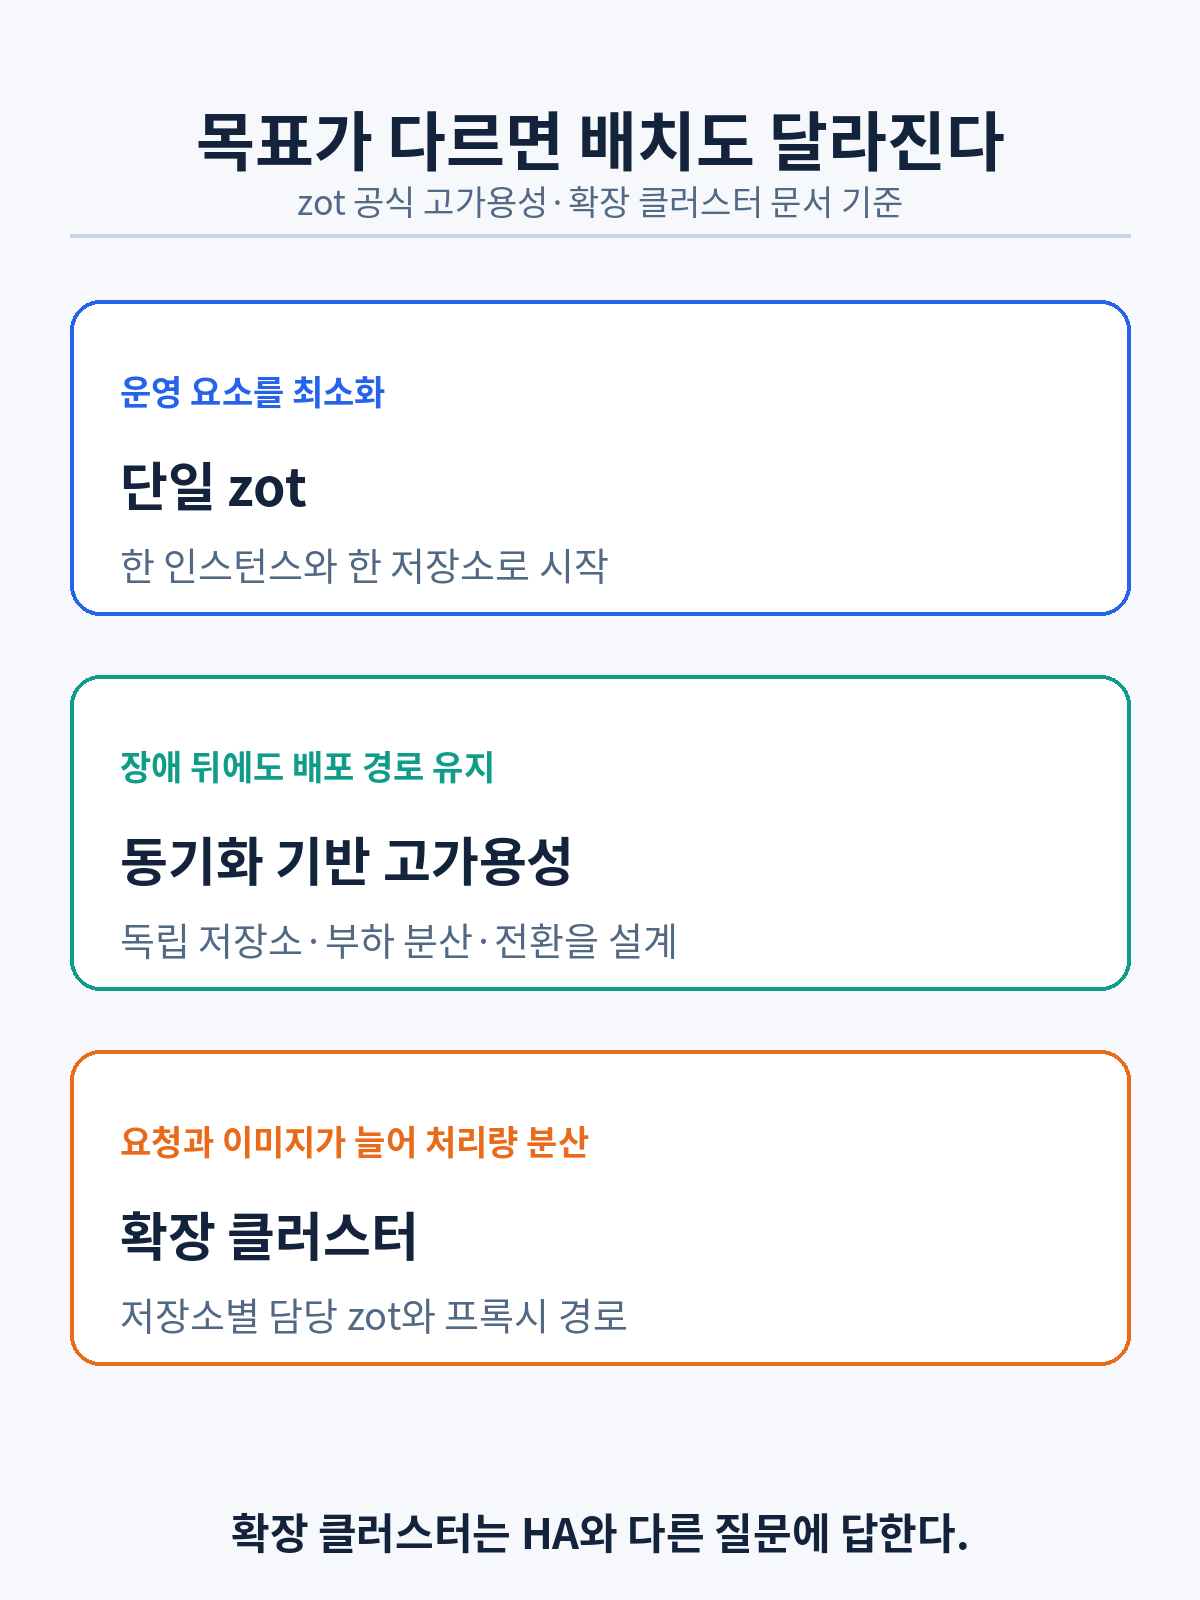
확장 클러스터를 고가용성과 같은 말로 부르면 장애 특성을 놓치기 쉽다. zot 문서는 확장 클러스터에서 인스턴스나 저장소가 내려가면 그 인스턴스에 매핑된 저장소가 영향을 받고, 영구 장애라면 해당 인스턴스를 제외하도록 클러스터 크기를 바꾼 뒤 재시작해야 한다고 설명한다. 성능을 나누는 설계와 장애 뒤에도 서비스를 계속하는 설계는 겹칠 수 있어도 자동으로 서로를 대체하지 않는다.
결국 먼저 정할 것은 레지스트리의 실패 비용이다
작은 팀이 내부 이미지를 보관하는 단계라면 단일 바이너리라는 출발점이 운영 복잡도를 낮춘다. 레지스트리 중단이 곧 배포 중단이라면 독립 저장소·동기화·전환 경로를 갖춘 HA 구성이 맞고, 그때는 동기화 간격에 남는 최신 이미지의 위험을 배포 절차에 넣어야 한다. 이미지와 요청이 늘어 특정 노드의 처리량이나 저장소 분산이 병목이라면 확장 클러스터의 담당 저장소 규칙과 공유 서비스 조건을 검토할 차례다.
zot가 단일 바이너리와 클러스터를 함께 내세우는 방식은 작은 설치를 거대한 배포판으로 바꾸지 않고, 같은 레지스트리의 배치와 저장소 관계를 바꿔 운영 문제를 나누는 데 있다. 설치의 단순성과 장애 내성, 처리량은 하나의 설정값이 아니라 서로 다른 토폴로지 선택으로 관리한다.
출처: zotregistry.dev, zot 고가용성 문서, zot 확장 클러스터 문서 (2026-08-07 확인)