
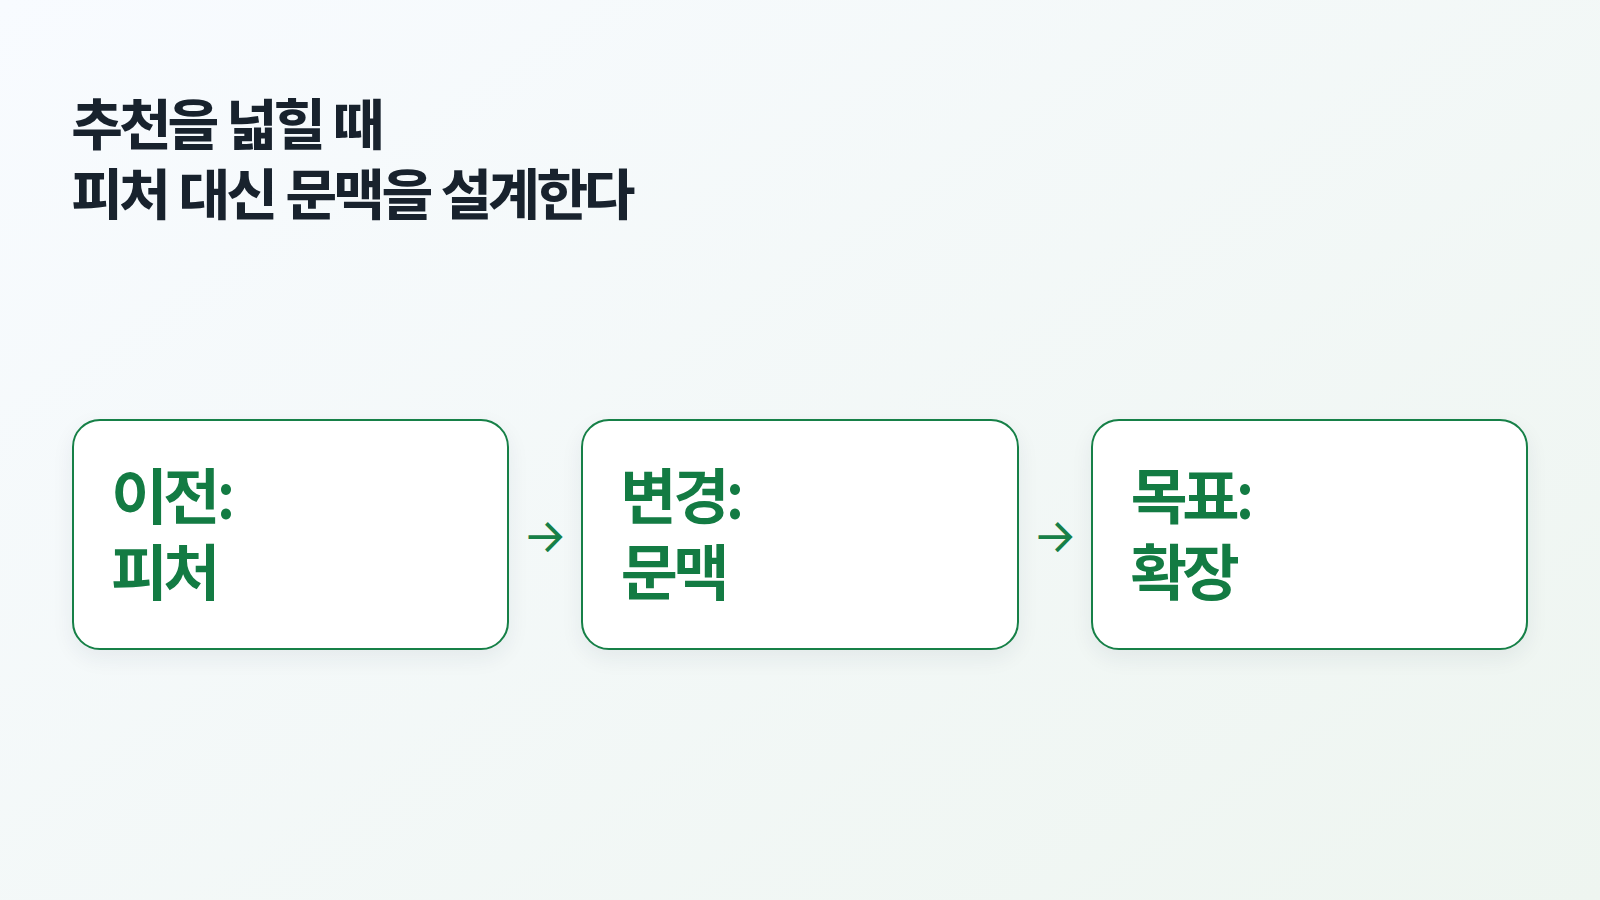
Netflix가 자사 기술 블로그에 공개한 GenRec은 추천 시스템의 핵심 엔진을 대형 언어 모델(LLM)로 바꾸는 실험 결과이다. Netflix는 지금까지 수천 개의 수작업 피처와 시퀀스 모델링·다중 과제 목적함수를 위한 전용 아키텍처로 추천 랭킹을 만들어 왔는데, 이 구조를 LLM 기반으로 대체하면서도 대규모 A/B 테스트에서 실질적인 개선을 확인했다고 밝혔다.
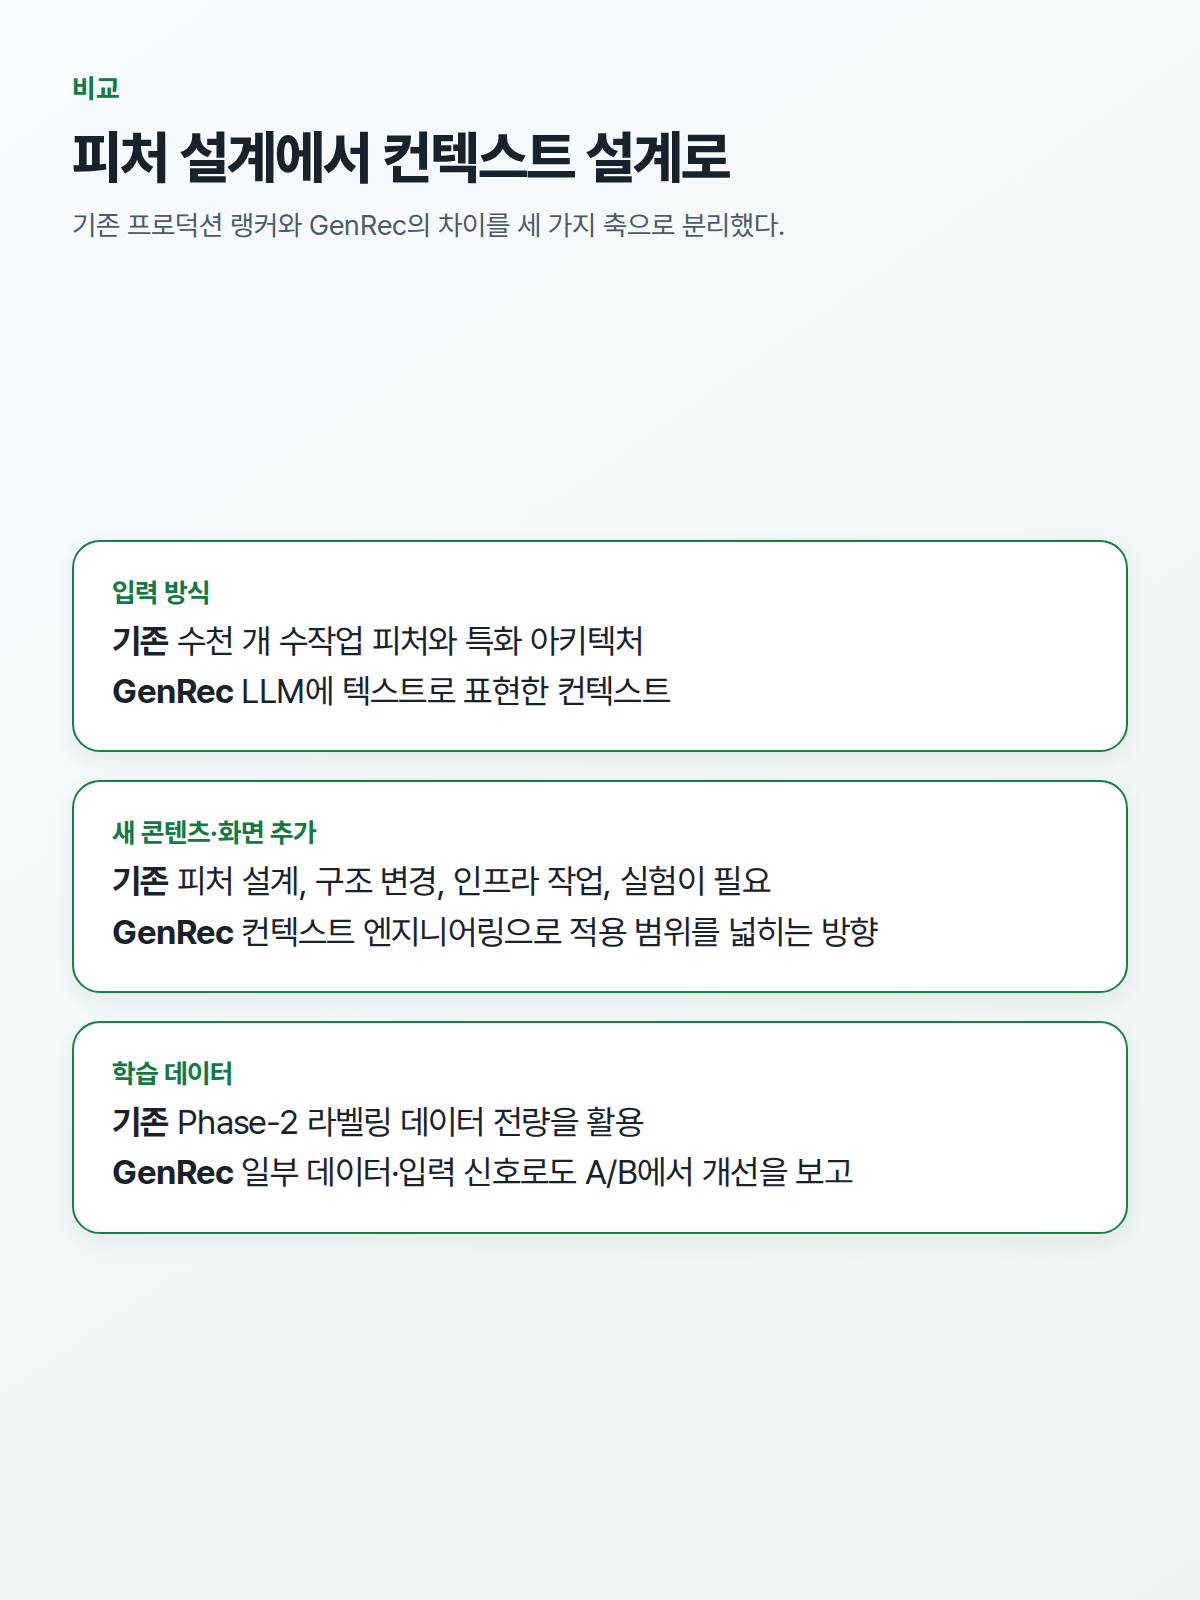
이 발표에서 특히 눈에 띄는 부분은 새로운 콘텐츠 유형이나 서비스 화면을 추가할 때마다 드는 비용이다. Netflix는 영화, 시리즈, 게임, 라이브, 팟캐스트처럼 다양한 콘텐츠 유형과 여러 제품 화면을 지원하기 위해 오랫동안 추천 스택을 키워 왔지만, 그만큼 새 콘텐츠 유형이나 화면을 추가하려면 피처 설계, 아키텍처 변경, 인프라 작업, 실험까지 상당한 비용이 들어간다고 설명한다.
기존 방식이 부딪힌 문제: 무엇을 새로 추가할 때마다 다시 설계해야 한다
Netflix의 기존 프로덕션 랭커는 오랜 기간에 걸쳐 튜닝된 성숙한 시스템이다. 문제는 그 정교함이 곧 새로운 것을 추가하는 데 드는 비용이라는 점이다. 새로운 콘텐츠 유형을 넣으려면 그에 맞는 피처를 새로 설계해야 하고, 필요하면 아키텍처 자체를 손봐야 하며, 인프라 작업과 실험까지 다시 거쳐야 한다. 반면 LLM은 사용자 시청 기록과 아이템 메타데이터를 텍스트로 직접 표현할 수 있고, 넓은 세계 지식과 언어 이해 능력으로 자연어 지시만으로 추천 방향을 조정할 수 있다. 다만 Netflix는 그대로 가져다 쓸 수 있는 기성 LLM은 아직 실무에 부족하다는 점도 함께 짚는다. 전 세계적으로 인기 있는 콘텐츠를 과도하게 추천하거나, 존재하지 않는 카탈로그 항목을 그럴듯하게 지어내거나, 비즈니스 제약을 무시하거나, 개인화가 제한적이라는 문제가 그대로 남아 있기 때문이다.
GenRec의 처리 흐름: 로그를 텍스트로, 텍스트를 점수로
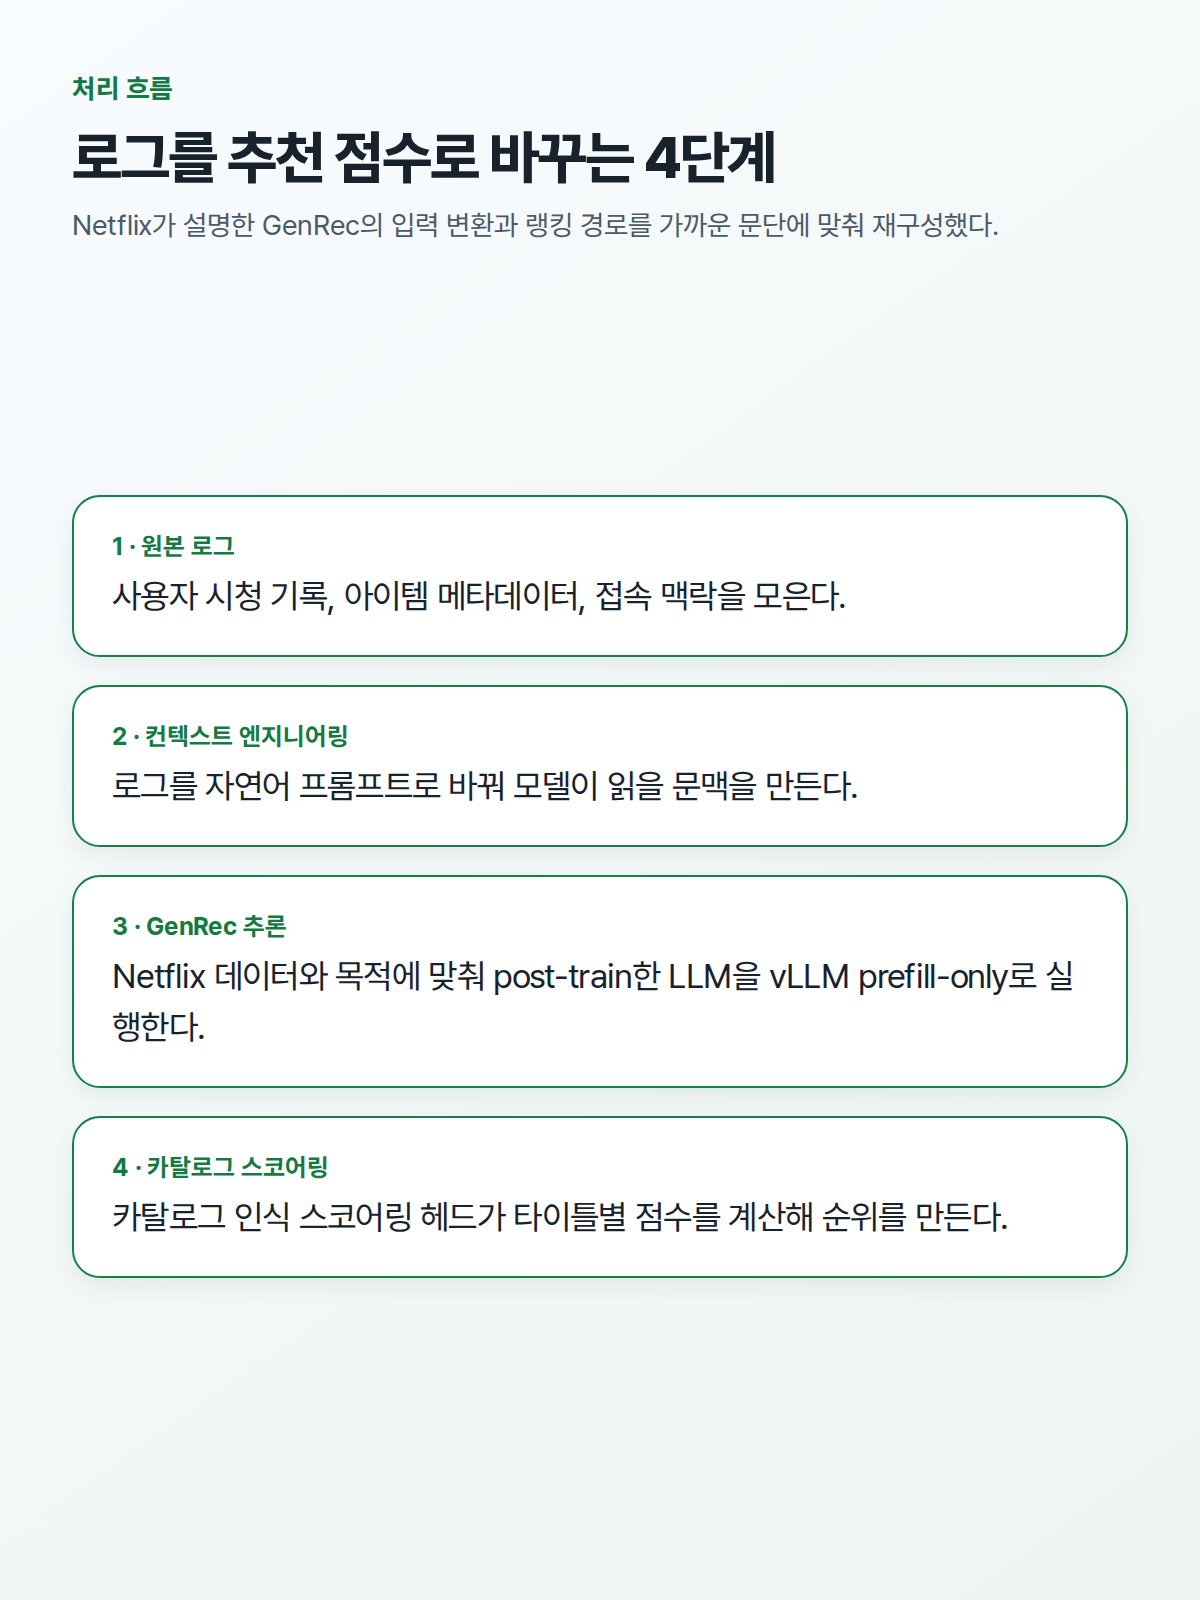
Netflix가 만든 GenRec은 내부 파운데이션 LLM을 Netflix 고유의 데이터와 목적함수로 재학습(post-train)한 추천 랭커이다. 처리 과정은 네 단계로 나뉜다. 먼저 사용자의 시청 기록, 아이템 메타데이터, 접속 컨텍스트(기기, 화면, 지역, 시간 등) 같은 원본 로그를 모은다. 이어서 "컨텍스트 엔지니어링" 단계에서 이 로그를 자연어 프롬프트로 변환한다. 변환된 텍스트는 GenRec에 입력되고, 이 모델은 Netflix 서빙 스택 위에서 prefill-only 모드로 vLLM을 통해 실행된다. 마지막으로 카탈로그 인식 스코어링 헤드가 각 타이틀에 점수를 매겨 최종 추천 순위를 만든다.
"피처 엔지니어링"에서 "컨텍스트 엔지니어링"으로
Netflix가 이 글에서 던지는 핵심 메시지는 작업의 성격 자체가 바뀐다는 것이다. 기존 방식에서 엔지니어의 일은 어떤 신호를 어떤 피처로 가공해 모델에 넣을지 설계하는 "피처 엔지니어링"이었다. GenRec에서는 로그를 어떤 자연어 문장으로 표현할지, 어떤 맥락 정보를 프롬프트에 포함할지를 설계하는 "컨텍스트 엔지니어링"이 그 자리를 대신한다. 모델 자체의 구조를 바꾸는 대신, 모델에 무엇을 어떻게 보여줄지를 설계하는 쪽으로 엔지니어링 작업의 중심이 옮겨간다는 뜻이다.
왜 이 방식이 데이터가 적어도 통할 수 있는가
Netflix가 밝힌 대규모 A/B 테스트 결과에서 GenRec은 잘 튜닝된 프로덕션 랭커 대비 단기·장기 온라인 지표 모두에서 통계적으로 유의미한 개선을 보였다. 더 주목할 부분은 이 결과가 Phase-2 라벨링 데이터와 입력 신호의 아주 일부만 사용한 상태에서 나왔다는 점이다. 기존 방식이 수천 개의 피처와 방대한 라벨 데이터에 의존해 성능을 유지했다면, GenRec은 LLM이 사전에 학습한 넓은 지식을 일부 활용함으로써 더 적은 데이터로도 비슷하거나 더 나은 결과를 낼 수 있다는 뜻이다. 이는 새로운 콘텐츠 유형이나 국가·언어권으로 서비스를 넓힐 때, 처음부터 대량의 라벨 데이터를 쌓지 않아도 추천 품질을 어느 정도 확보할 수 있는 가능성으로 이어진다.
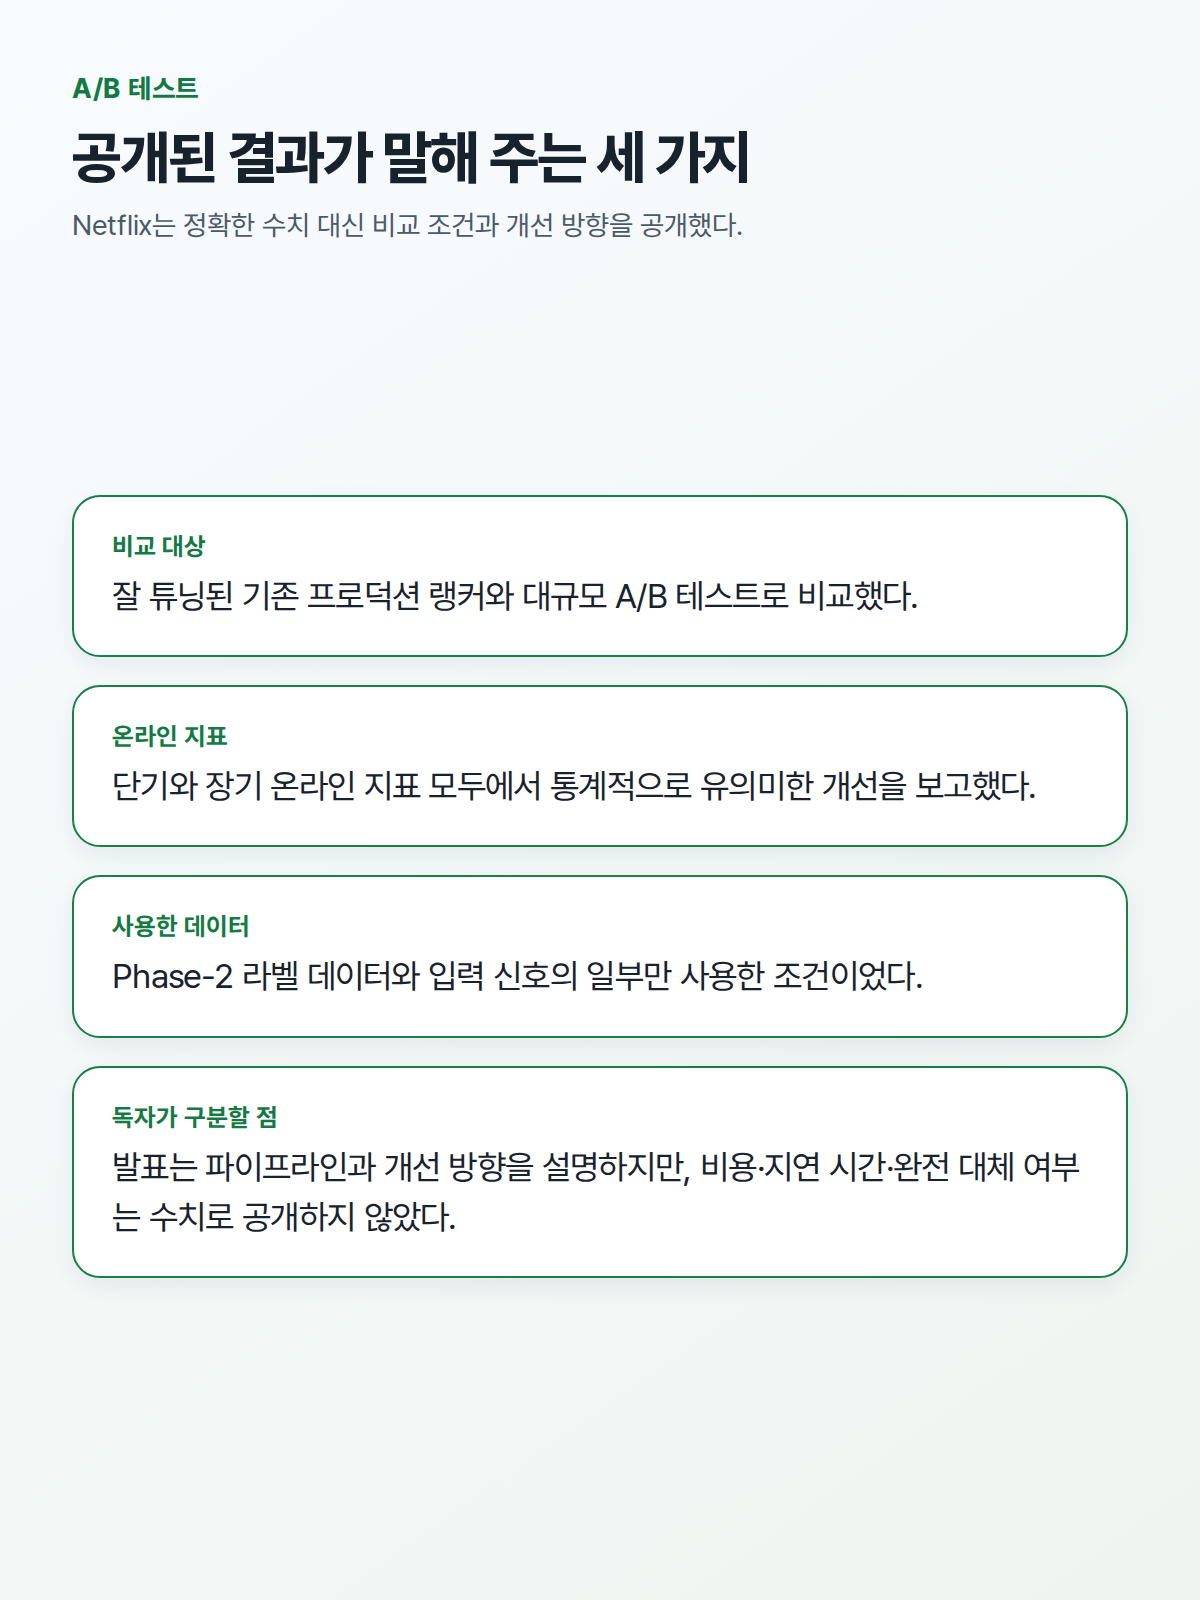
다만 Netflix가 밝힌 것은 A/B 테스트 결과와 파이프라인 구조까지이다. GenRec이 기존 랭커를 완전히 대체했는지, 어떤 조건에서 성능 차이가 벌어지는지, 실제 서빙 비용이 어느 정도인지는 이 발표만으로는 알기 어렵다. LLM 기반 추천이 대형 스트리밍 서비스에서 실제로 작동한다는 사례라는 점에서 의미가 있지만, 다른 규모나 다른 콘텐츠 구성을 가진 서비스에 그대로 적용될지는 별개의 문제로 봐야 한다.
출처: Netflix Technology Blog, GenRec: Towards LLM-Native Recommendation at Netflix