
Amazon 내부의 대형 티켓 시스템에서 티켓에 분류 라벨을 붙이는 일을 Claude Sonnet 4.6에서 Strands Decider로 바꿨다. 티켓 하나를 처리하는 평균 시간이 4,215ms에서 897ms로 줄었고, 100만 건당 비용은 약 2만 2,200달러에서 약 500달러가 됐다. Strands 팀이 11월 9일 블로그에 공개한 사례다. Decider는 글을 쓰지 않고 선택지만 고르는 모델이다.
상태와 선택지를 주면 확률이 나온다
Decider는 한 달 전에 공개된 판단 모델이다. 상태와 질문, 선택지를 받으면 선택지마다 확률을 돌려주고 확신도를 함께 붙인다. 문장은 만들지 않는다. 팀은 이 구조를 「상태는 티켓, 선택지는 라벨 목록」이라고 설명한다.
대상 업무는 고객 에스컬레이션, 용량 요청, 자동 알람, 보안 점검 결과 같은 티켓을 20개 분류 중 하나로 보내는 일이었다. 기존에는 Sonnet 4.6이 긴 시스템 프롬프트를 매 티켓에 붙여 받고 JSON을 생성했다. 새 구성에서는 티켓이 SQS 큐에 들어오면 Lambda가 SageMaker 엔드포인트의 Decider를 호출한다. 모델은 Gemma 4 기반 E4B 빌드이고, A10G GPU 한 장이 달린 ml.g5.xlarge 인스턴스에서 돈다.
같은 티켓 한 건에서 줄어든 것
티켓당 입력 토큰은 6,554개에서 2,009개로, 출력 토큰은 170개에서 1개로 줄었다. 출력이 1개인 이유는 JSON 대신 선택 하나만 내기 때문이고, 입력이 줄어든 이유는 프롬프트가 짧아졌기 때문이다. 비용은 Sonnet을 Bedrock 공개 단가(입력 100만 토큰당 3달러, 출력 15달러)로, Decider를 인스턴스 시간당 1.408달러로 계산한 값이다. 인스턴스를 꽉 채우면 시간당 약 5,600건을 처리해 100만 건에 약 250달러이고, 500달러는 갑자기 몰리는 양에 대비한 여유까지 넣은 값이다.
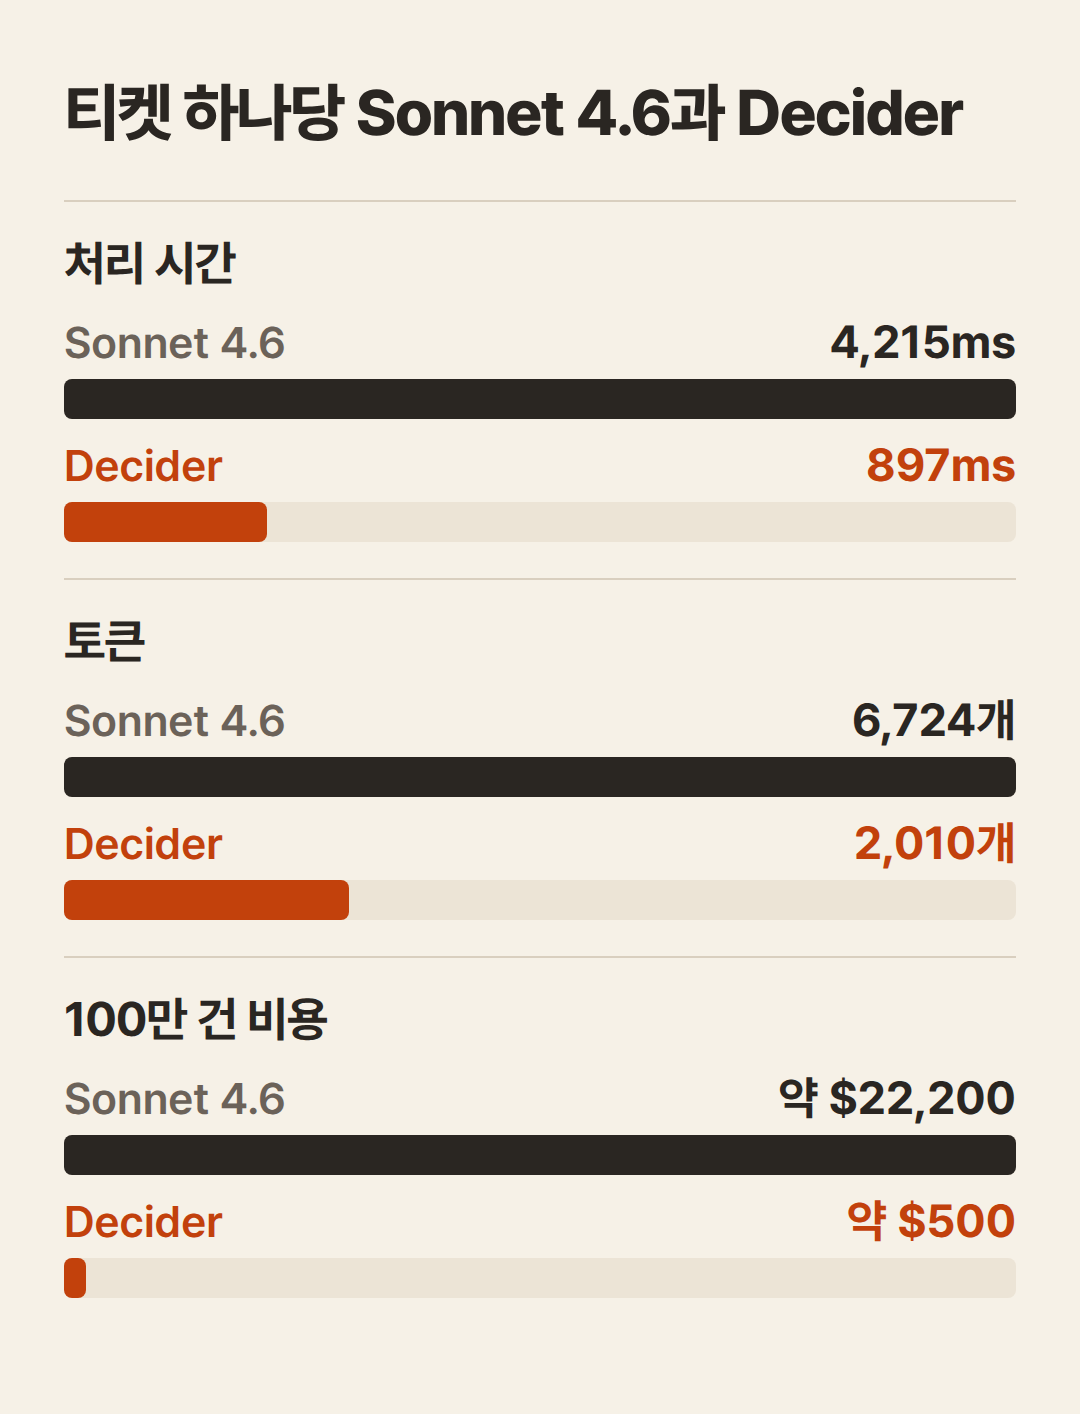
팀은 E4B가 별도 티켓 묶음에서 운영 중이던 Sonnet보다 나은 결과를 냈고, 라벨을 붙이는 확신도 기준을 조정한 뒤 전환했다고 밝혔다. 이 전환으로 연 단위 토큰 비용이 수백만 달러 줄 것으로 본다.
라벨 설명을 두 문장으로 줄이는 일이 작업의 절반이었다
Decider의 입력 창은 4,096토큰이다. 운영용 라벨 설명은 이보다 길어서, 20개 라벨 각각을 한두 문장짜리 판단 기준으로 다시 썼다. 이 기준들을 하나의 선택 질문에 넣고 「해당 없음」 선택지를 하나 더 붙였다. 티켓이 길면 오래된 댓글부터 잘려 나간다.
같은 요청에서 JSON 키 순서만 바꿨는데 확률이 최대 0.19까지 움직인 경우도 있었다. 팀은 키를 정렬해서 보내고, 실행 결과를 비교하기 전에 이 점부터 확인하라고 권한다.
전환은 설정 한 줄로 되돌릴 수 있게 했다
AWS AppConfig 값 하나가 메시지마다 경로를 정한다. BEDROCK은 Sonnet이 모든 티켓에 라벨을 붙이고, DECIDER는 Decider가 붙인다. DUAL은 둘이 나란히 돌면서 서로 다른 결과를 비교한다. 되돌리는 데 45초가 걸렸고, 팀은 모델이 무엇이든 이 세 갈래 스위치는 그대로 가져다 쓰겠다고 적었다.
직접 물어보는 방법
공개 저장소 strands-decider의 CLI로 내 컴퓨터에서 먼저 시험할 수 있다. 설치는 pip install strands-decider다. 다음처럼 상태와 선택지를 주면 선택지별 확률이 나온다.
strands-decider ask StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 \
  --state "Help! My payouts have been failing for 3 days!" \
  --choice "Which team should handle this?=billing,sales,retail"
저장소 예시에서는 billing이 0.773으로 나온다. README는 처음 보는 짧은 분류 문제에서 확신도 0.9 이상인 답이 약 95% 맞았다고 소개하고, 그 아래라면 사람에게 확인하라고 안내한다.
적용해 볼 점
정해진 목록에서 하나를 고르는 일, 호출량이 많은 일, 응답 속도가 중요한 일에서 효과가 컸다. 문의를 담당 팀으로 보내거나, 알람의 심각도를 나누거나, 메일을 분류하는 업무가 같은 모양이다. 지금 LLM으로 이런 분류를 돌리고 있다면 입력 토큰과 출력 토큰이 티켓당 얼마인지부터 확인해 볼 만하다. 라벨 설명이 몇 문장으로 줄어드는지가 이 방식으로 옮길 수 있는지 가르는 기준이다. 라벨마다 설명문을 써야 하거나 목록이 매주 바뀌는 업무는 LLM이 그대로 맞는다고 팀도 적었다.