
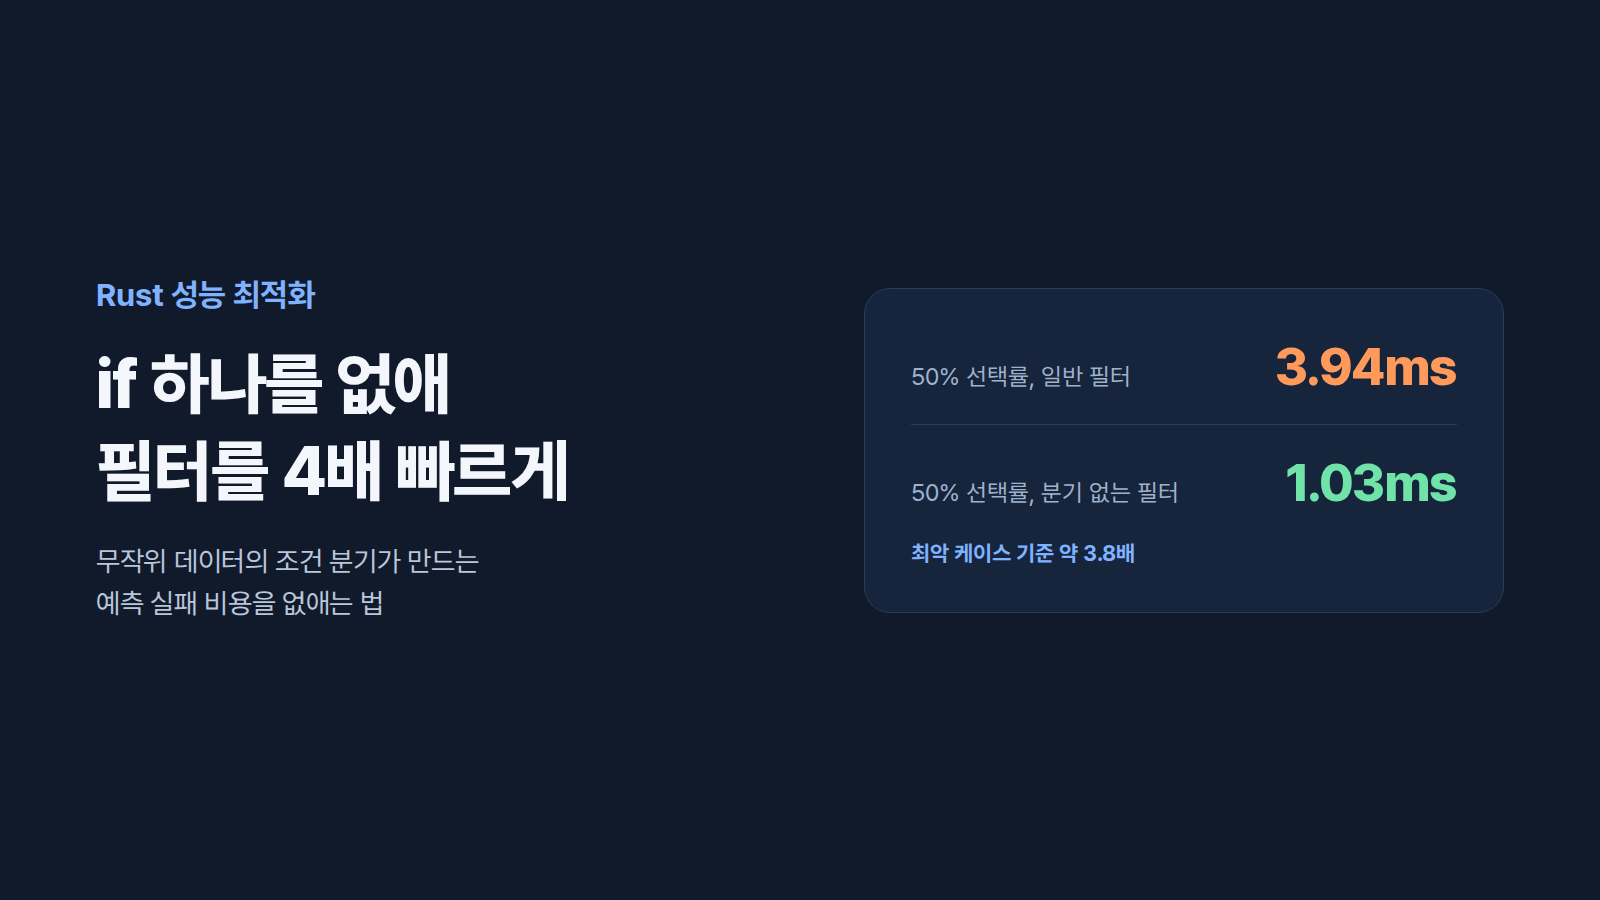
Rust에서 숫자 100만 개를 거르는 루프가 가장 느린 지점은 결과를 절반 남길 때였다. Serhii Potapov가 2026년 8월 2일 공개한 실험에서, 무작위 f64 입력을 임계값보다 큰 값만 남기는 관용적 반복자 필터는 50% 선택률에서 3.94ms가 걸렸다. 1%를 남길 때의 0.59ms나 99%를 남길 때의 1.49ms보다 느리다. 출력량이 많아서가 아니라, if가 매 원소마다 어느 쪽으로 갈지 예측하기 어려웠기 때문이다.
글의 해법은 조건을 없애는 것이 아니라 조건이 제어 흐름을 나누지 않게 바꾸는 것이다. 매 원소를 출력 버퍼에 먼저 쓰고, 비교 결과를 0 또는 1로 바꿔 출력 위치만 전진시킨다. 거짓인 값은 다음 반복에서 덮어쓰며, 끝에서 실제로 남긴 원소 수만큼 벡터를 자른다. 이 방식은 무작위 데이터에서 가장 나쁜 경우를 약 3.8배 줄였지만, 언제나 빠른 만능 최적화는 아니다.
왜 50% 선택률에서 시간이 가장 길어졌나
실험 입력은 0.0부터 100.0 사이에 균등하게 분포한 무작위 실수 100만 개다. 임계값을 바꿔 1%, 25%, 50%, 75%, 99%를 남기도록 했고, 각 경우 읽는 입력량은 같다. 일반적인 예상이라면 많이 복사하는 99%가 가장 느려야 한다. 실제 표에서는 절반만 복사하는 50%가 가장 느렸다. collect()가 출력 크기를 모르니 벡터 재할당이 문제일 수 있다는 가설도 시험했지만, 입력 길이만큼 미리 할당한 버전은 3.87ms로 약 2%만 개선했다.
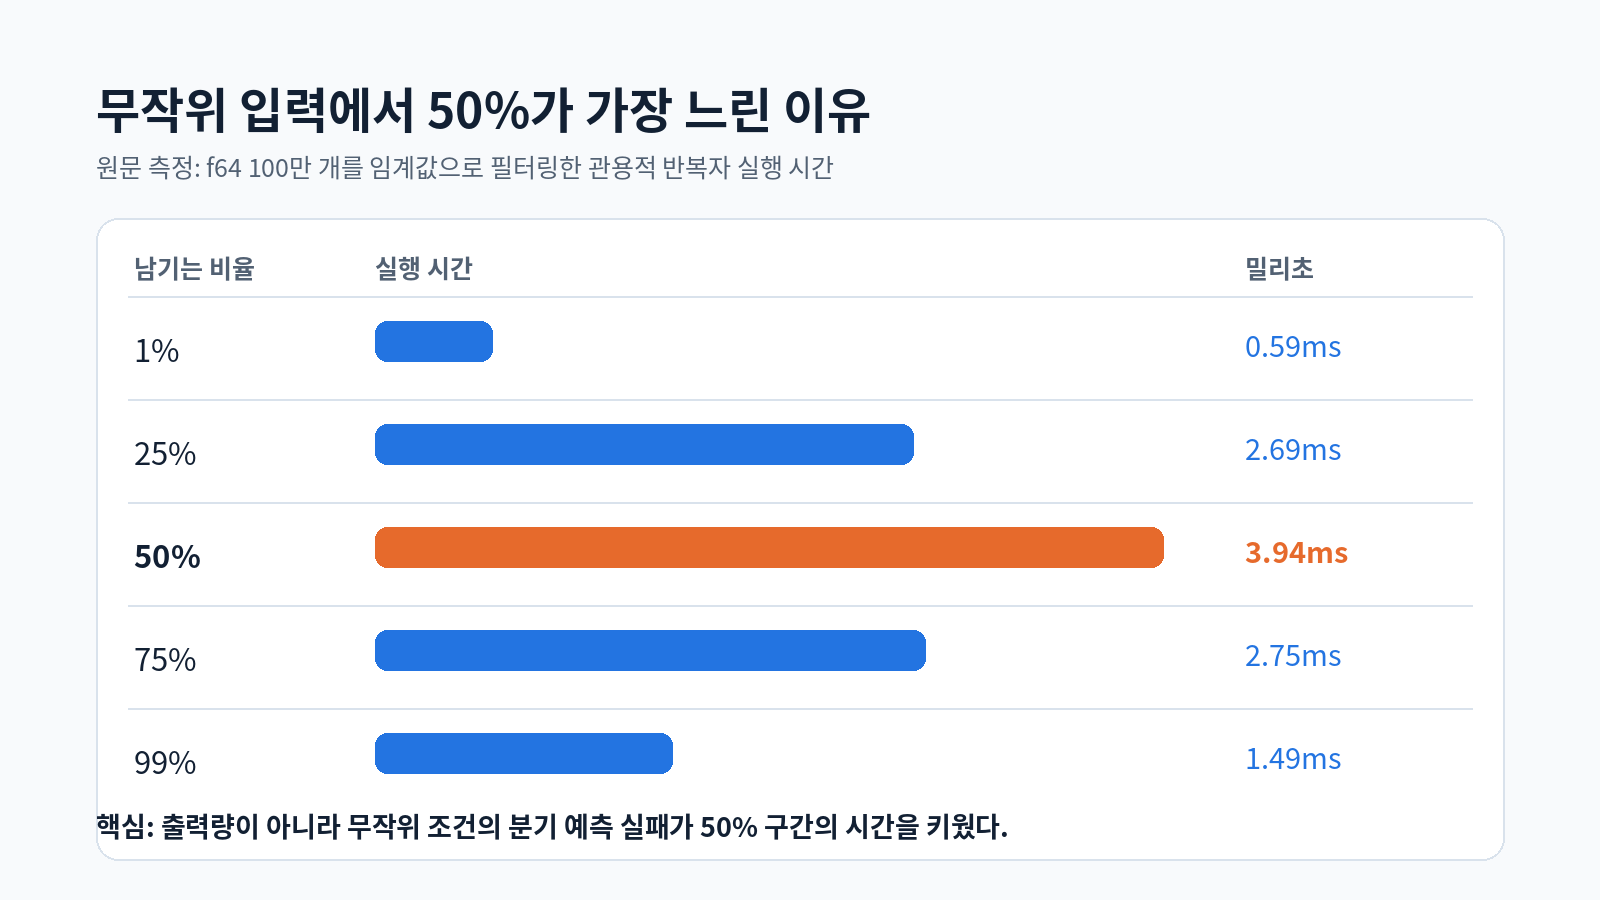
현대 CPU는 비교 결과가 나오기 전에 다음 명령을 추측해 처리한다. 조건이 대부분 참이거나 대부분 거짓이면 분기 예측기는 곧 패턴을 배운다. 1% 선택률에서는 거의 계속 건너뛰고, 99%에서는 거의 계속 저장하므로 예측 실패가 드물다. 반면 균등 무작위 입력에서 50%를 남기는 조건은 다음 결과를 알기 어렵다. 추측이 틀리면 이미 진행한 명령을 버리고 파이프라인을 다시 채워야 한다. 원문은 일반적인 현대 x86 코어에서 이 비용을 약 15~20사이클로 설명한다.
데이터 순서만 바꿔도 무엇이 드러나나
저자는 같은 필터와 같은 50% 임계값을 쓰되, 측정 구간 밖에서 입력을 정렬해 다시 돌렸다. 섞인 입력은 4.15ms, 정렬된 입력은 0.93ms였다. 전자는 참과 거짓이 뒤섞여 있고, 후자는 앞 절반에서 계속 거짓이었다가 뒤 절반에서 계속 참이 된다. 원소 수와 임계값, 필터 함수가 같은데 약 4.5배 차이가 난 결과는 메모리 복사량보다 예측 실패가 병목이라는 증거가 된다.
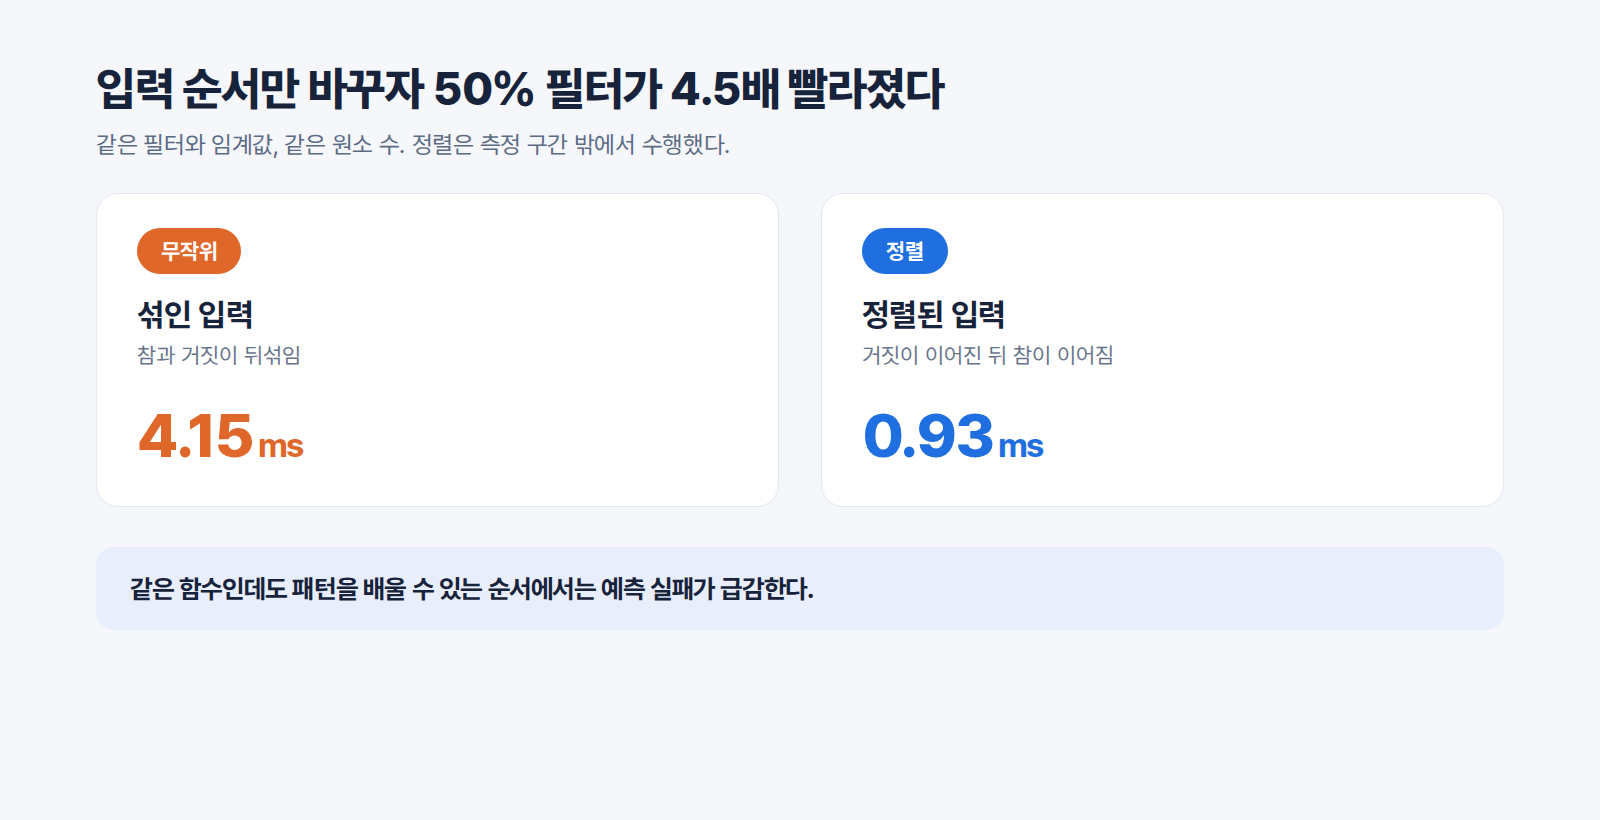
정렬을 해결책으로 삼을 수는 없다. 정렬 자체의 비용이 필터보다 클 수 있고, 호출자가 원래 순서를 필요로 할 수도 있다. 여기서 순서 변경은 분기 예측을 분리해 관찰하기 위한 실험이다. 최적화할 대상은 “분기가 있다”는 문법이 아니라, 실제로 뜨거운 루프 안에서 데이터에 따라 무작위로 흔들리는 분기다.
항상 쓰고, 조건부로 위치만 옮기는 이유
분기 없는 버전은 출력 벡터를 입력 길이만큼 만들고, 매 반복에서 현재 위치에 값을 쓴다. 비교식의 결과를 usize로 변환하면 참은 1, 거짓은 0이 된다. 따라서 참일 때만 다음 출력 위치가 한 칸 이동하고 거짓이면 같은 자리에 다음 값이 덮인다. 마지막에 위치 값으로 벡터 꼬리를 자르면 원래 필터와 같은 순서의 결과가 남는다. 비교는 사라지지 않았지만, 프로그램이 갈림길을 택하는 제어 의존성에서 숫자를 더하는 데이터 의존성으로 바뀐다.
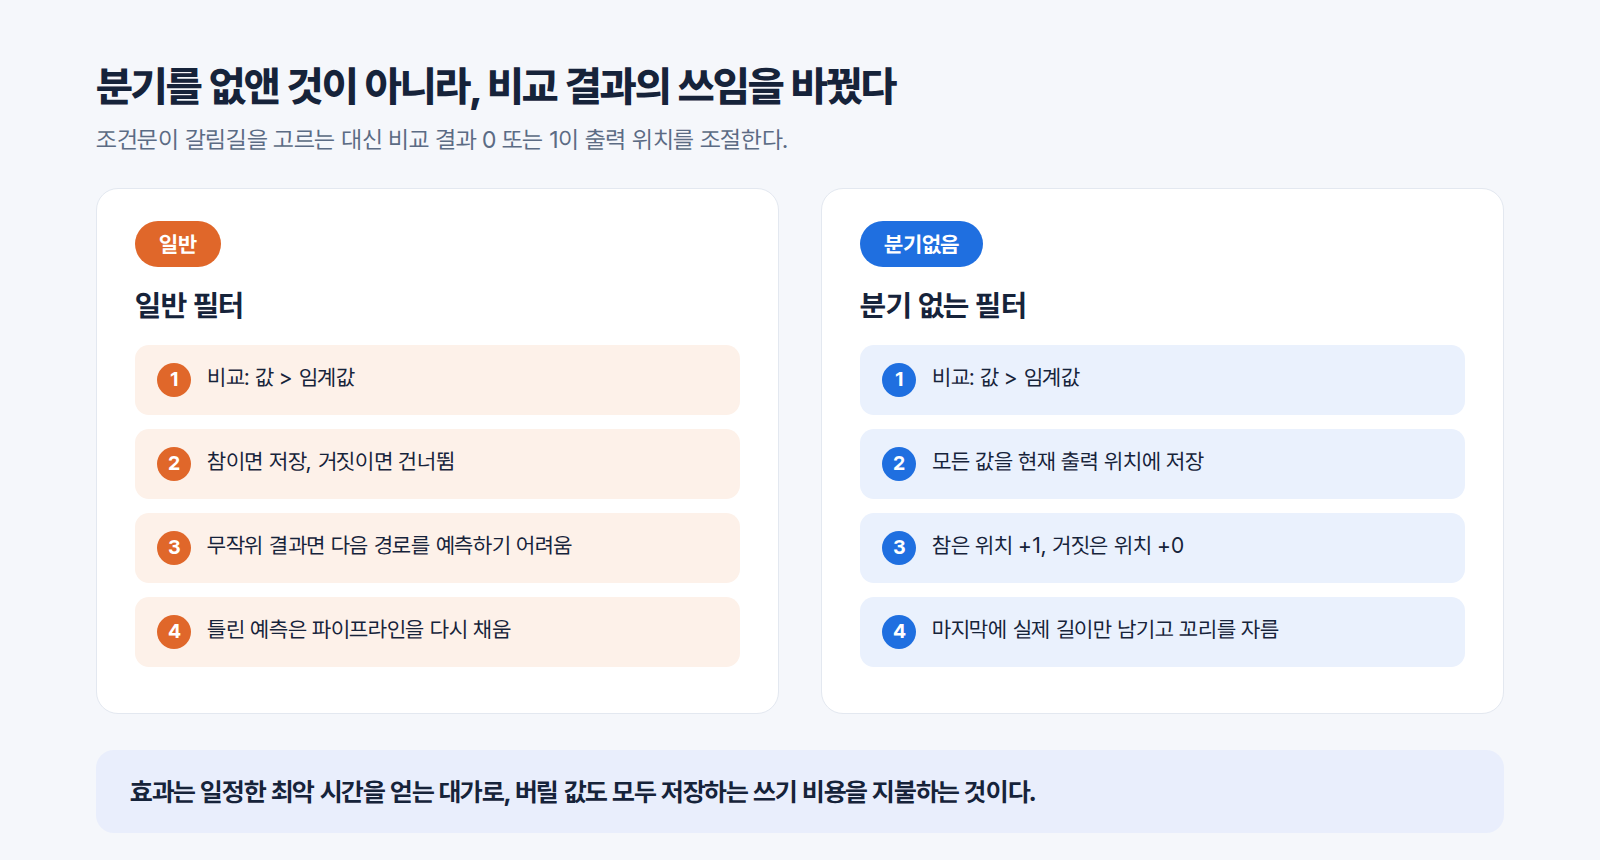
원문의 결과에서 이 버전은 1%·25%·50%·75%·99% 선택률에 각각 1.09ms·1.05ms·1.03ms·1.02ms·1.11ms를 기록했다. 50%의 관용적 반복자 3.94ms와 비교하면 약 3.8배 빠르고, 데이터 비율에 따른 흔들림도 작다. 대신 1%만 남기는 경우에는 원래 버전의 0.59ms보다 느리다. 예측 가능한 분기는 거의 비용이 없지만, 분기 없는 방식은 버려질 값까지 100만 번 기록하기 때문이다.
Rust 코드에서 이 기법을 적용할 기준은 무엇인가
이 사례는 읽기 쉬운 iter().filter(...).collect()를 먼저 의심하라는 뜻이 아니다. Rust 컴파일러와 CPU는 이미 많은 최적화를 수행하며, 분기 없는 루프는 저장 공간을 입력 길이만큼 확보하고 덮어쓰기 규칙을 이해해야 하므로 유지보수 비용도 커진다. 프로파일러가 특정 루프를 뜨거운 경로로 지목했고, 그 루프의 조건 결과가 입력 데이터에 따라 예측 불가능하며, 최악 지연 시간이 실제 문제일 때 비교 벤치마크로 선택할 수 있다.
따라서 이 글에서 가져갈 판단 기준은 간단하다. 출력량만 보고 필터의 비용을 추측하지 말고, 같은 데이터와 같은 CPU 조건에서 선택률과 입력 순서를 바꿔 측정한다. 중앙값 선택률에서만 급격히 느려진다면 분기 예측이 원인 후보가 된다. 그때도 분기 없는 구현은 최고 성능을 노리는 교체가 아니라, 최악 조건의 지연을 일정하게 만드는 교환으로 평가해야 한다.
출처: Serhii Potapov, “Branchless Rust: Making a Filter 4x Faster by Removing an if”, 2026년 8월 2일