
채팅 서버의 처리량을 높여도 새 메시지 알림이 몇 분 늦게 도착할 수 있다. 개발자 Piotr Sarnacki는 2026년 10월 11일 공개한 글에서 자기 서버에 설치하는 그룹 채팅 제품 Campfire의 Rust·Elixir 재작성 버전을 비교하며 이런 문제를 짚었다. PM과 운영자는 사용자가 새 내용을 볼 때까지 기다릴 시간과 과부하 뒤의 복구 방식을 승인 조건에 넣어야 한다. 서버가 쓸 수 있는 메모리 한도도 함께 정해야 한다.
Ruby on Rails를 만든 DHH는 AI 에이전트에 이 제품의 다른 언어 버전을 만들게 했다. Sarnacki가 살펴본 구현들은 같은 기능을 옮기는 과정에서도 서로 다른 선택을 했다. 그의 측정은 프로그래밍 언어의 순위를 매기는 자료보다, 재작성 요청에서 빠뜨린 제품 요구사항을 찾는 사례로 읽는 편이 유용하다.
메시지를 저장하는 속도와 새 내용을 보여 주는 속도는 다르다
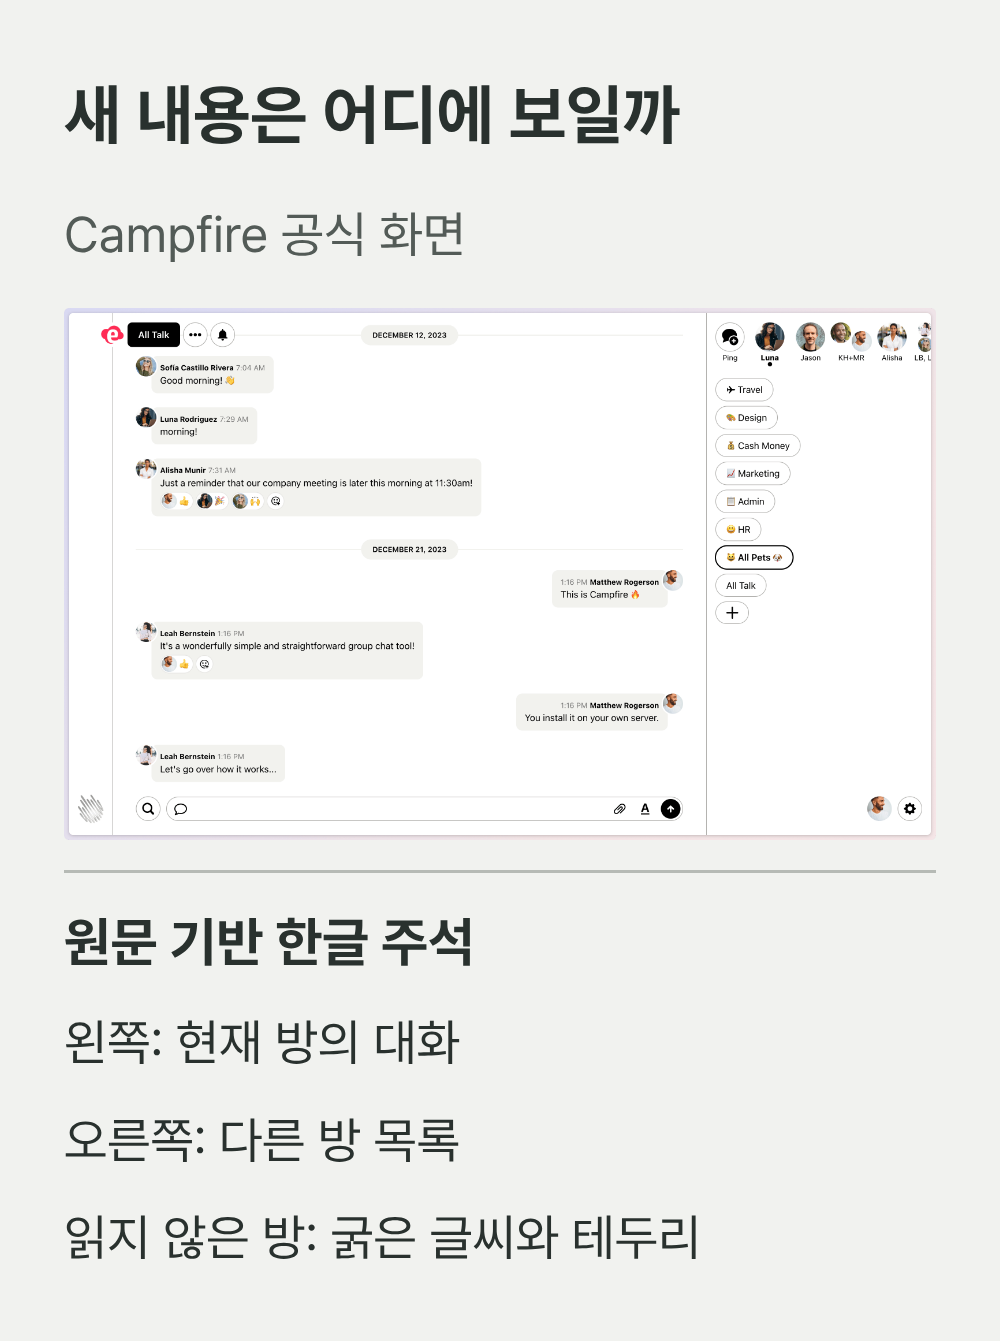
채팅에서는 메시지 등록 요청에 성공 응답을 보내는 일과, 다른 사람의 화면에 새 메시지가 있다는 이벤트를 보내는 일이 나뉜다. 여기서 이벤트는 새 내용을 가져오거나 화면을 갱신하도록 알리는 신호다. 앞단의 요청 처리가 빨라도 뒷단의 전달이 밀리면 사용자는 대화가 멈춘 것처럼 느낀다. Campfire의 공식 화면도 현재 대화와 다른 방의 읽지 않은 내용을 구분한다. 제품이 제공하려는 경험은 서버가 요청을 받았다는 사실보다 이 화면이 제때 갱신되는 데 가깝다.
구현의 비교 조건도 달랐다. Sarnacki가 검토한 Rust 버전은 캐싱을 쉽게 하려고 CSRF 토큰을 제거하고, Redis 대신 프로세스 안의 큐를 쓰는 등의 변경을 했다. Elixir 버전은 원래 Rails 구현에 더 가까웠다. 이는 언어가 자동으로 정해 주는 차이가 아니다. 기존 클라이언트와의 호환성이나 프로세스 종료 뒤 알림이 남아야 하는지도 재작성 범위에 포함해 합의할 항목이다.
같은 초당 100건을 보내자 전달률 밖의 실패가 보였다
먼저 나온 부하 비교는 정해진 수의 클라이언트가 응답을 받은 뒤 다음 요청을 보내는 폐쇄형 테스트였다. 원문이 인용한 비교에서 Rust는 약 6천~7천 건의 알림 중 1%를, Elixir는 약 1,700건 중 100%를 전달했다. 처리한 요청 수가 다르면 전달해야 할 이벤트 수도 달라진다. 이 결과만으로 어느 쪽이 같은 업무량을 더 잘 감당한다고 결론내리기는 어렵다.
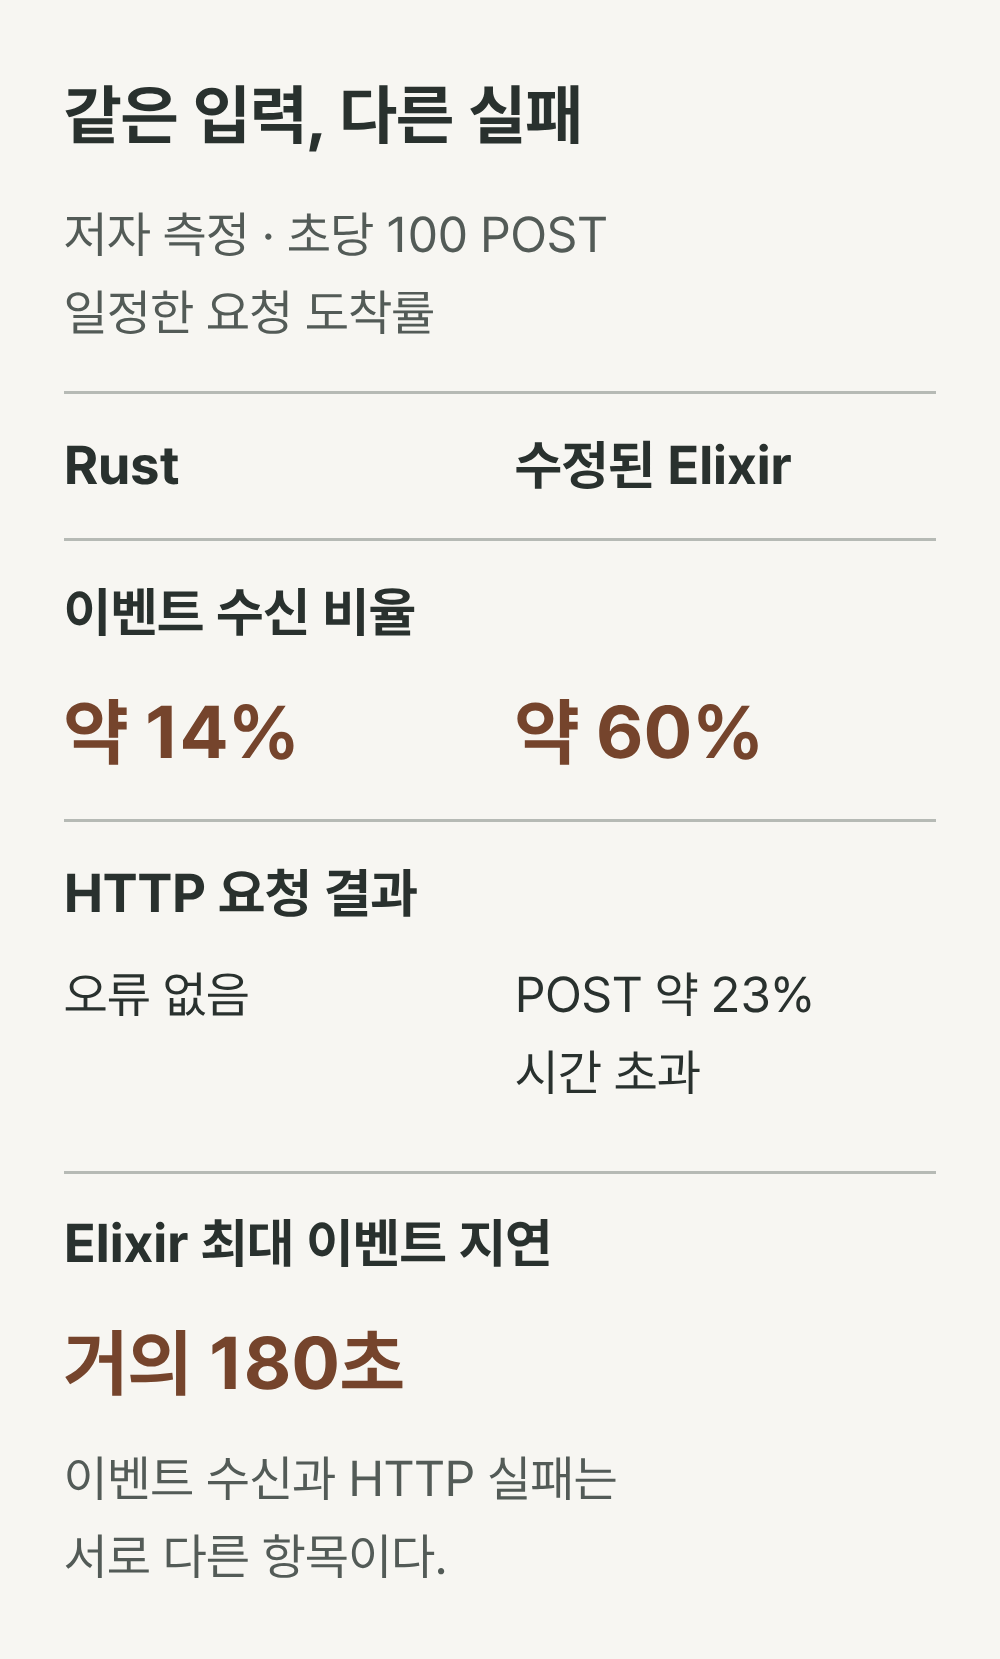
Sarnacki는 서버 응답 속도와 무관하게 요청을 일정하게 보내는 방식으로 다시 측정했다. DHH의 Rust 버전과 여러 수정이 들어간 Zach의 Elixir 버전에 초당 100건의 POST 요청을 보냈다. Rust의 이벤트 수신 비율은 약 14%, Elixir는 약 60%였다. 이때 Rust에는 HTTP 오류가 없었지만, Elixir에서는 POST 요청의 약 23%가 시간 초과로 끝났다. Elixir의 가장 늦은 이벤트는 도착까지 거의 180초가 걸렸다. 이 전달률, 요청 실패율, 최대 지연은 서로 다른 항목이며 하나의 성공률로 합쳐 읽을 수 없다.
원문에서 설명한 Rust 구현은 전달이 뒤처진 클라이언트의 연결을 끊는다. 브라우저는 재접속하면서 최신 메시지를 가져온다. 따라서 실시간 이벤트를 놓쳤다는 사실을 저장된 채팅 메시지가 사라졌다는 뜻으로 바꾸면 안 된다. 반대로 이벤트를 많이 전달해도 이미 몇 분 지난 소식이라면 사용자에게 유용한 갱신이라고 보기 어렵다. 운영팀은 전달률과 함께 재접속 후 실제 화면이 최신 상태로 돌아오는 시간을 측정해야 한다.
버퍼를 늘리면 놓치는 알림은 줄지만 대기 시간은 길어진다
Rust 구현은 Tokio의 방송 채널을 사용했다. 하나의 이벤트를 여러 연결에 보내되, 보관할 이벤트 수에 상한을 두는 구조다. 느린 수신자가 보관 범위 밖으로 밀리면 RecvError::Lagged 오류로 뒤처짐을 알린다. Tokio 자체가 이 오류만으로 연결을 끊는 것은 아니며, 원문이 설명한 재작성 구현이 연결 종료를 선택했다.
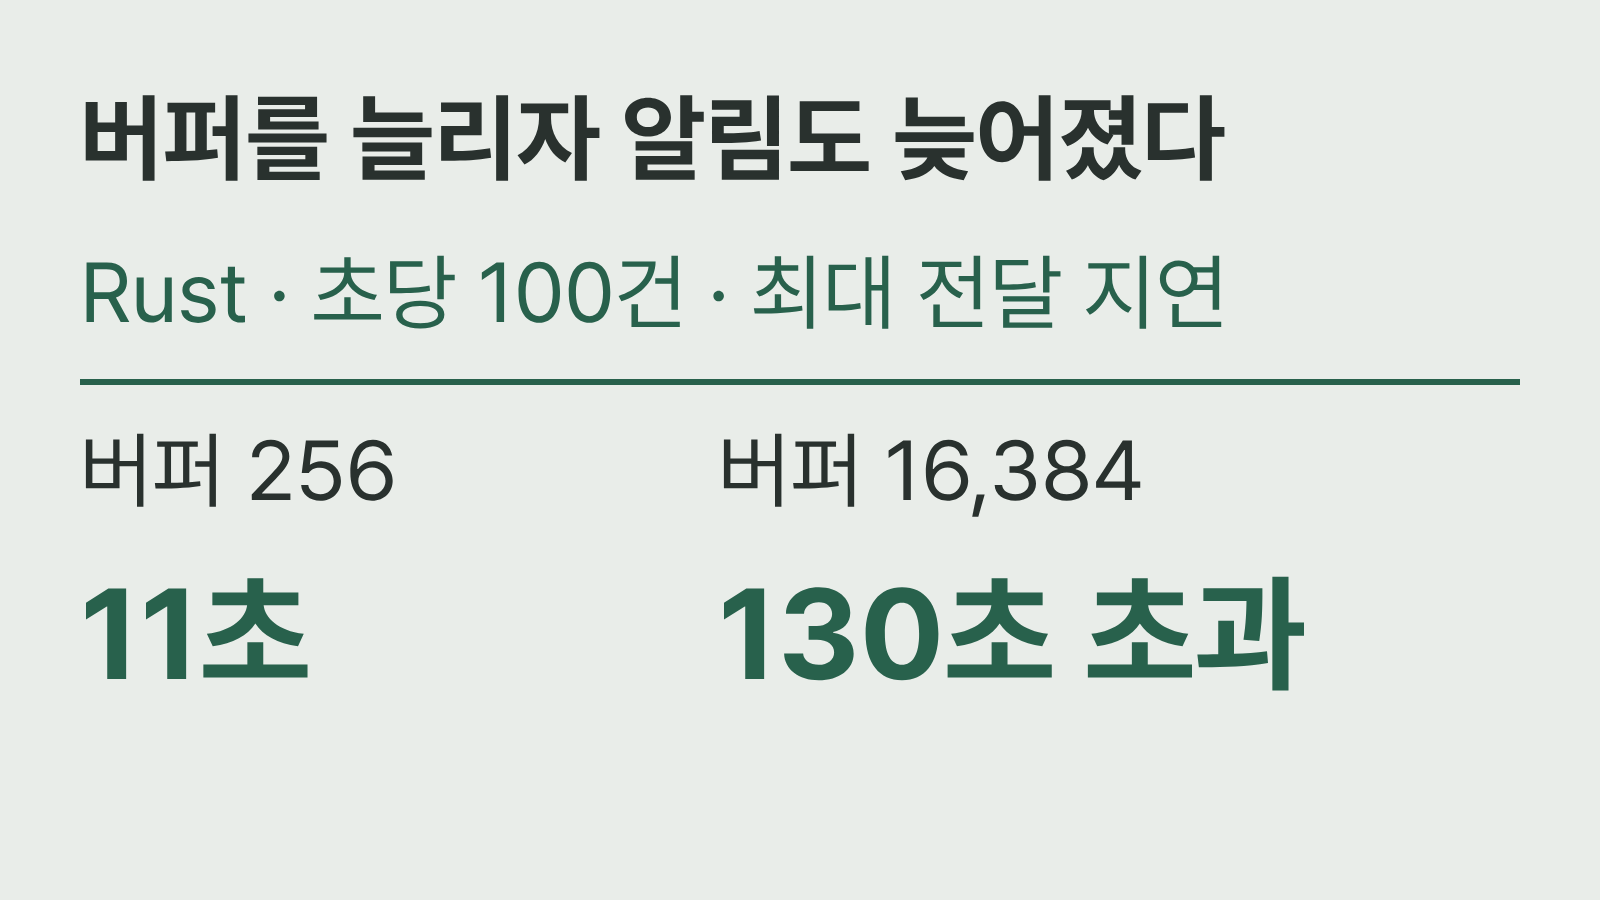
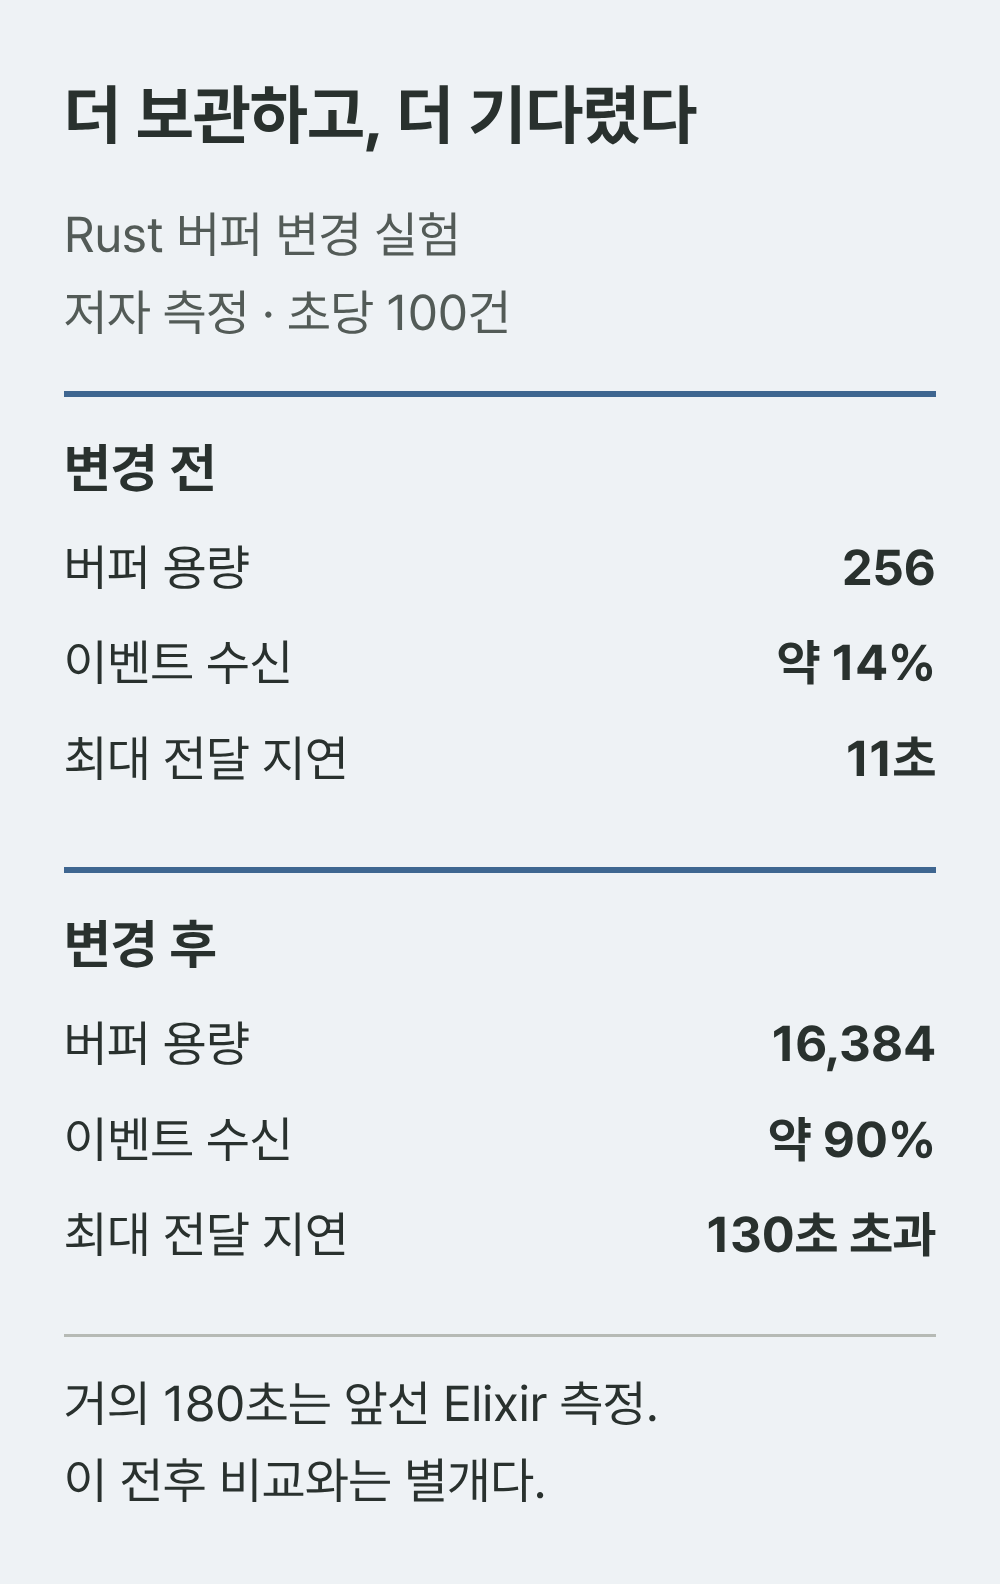
저자는 Rust의 버퍼 용량을 256에서 16,384로 바꾸는 실험도 했다. 초당 100건 조건에서 이벤트 수신 비율은 약 14%에서 약 90%로 올랐다. 동시에 최대 이벤트 전달 지연은 11초에서 130초 초과로 늘었다. 앞서 Elixir에서 관측한 거의 180초와는 별개의 측정이다. 더 큰 버퍼는 기다리는 이벤트를 더 오래 보관했지만, 그만큼 사용자가 늦은 알림을 받게 됐다.
Elixir 쪽의 기본 GenServer 메일박스에는 상한이 없다. 원문의 초당 100건 부하 테스트에서 이 구현의 메모리 사용량은 1.8GB에 도달했다. 대기열에 계속 쌓는 정책은 메모리 한도를 만나면 서버가 강제 종료되는 위험으로 이어진다. 얼마까지 기다리고, 언제 연결을 끊거나 요청을 거절할지는 언어 선택과 별도로 정할 운영 정책이다.
재작성 승인서에는 사용자가 기다릴 시간을 적어야 한다
PM은 “기존 기능을 더 빠르게 옮겨 달라”는 요청을 관측 가능한 조건으로 바꿔야 한다. 알림의 목표 도착 시간과 허용할 최대 지연을 정하고, 이를 넘긴 연결을 계속 기다리게 할지 재접속시킬지 명시한다. 재접속을 선택했다면 최신 메시지를 다시 가져오는 시간과 누락·중복 표시 여부까지 통과 기준에 넣는다. 이 글의 11초나 180초는 관측값이지 모든 제품에 적용할 목표값이 아니다.
운영자는 정상 부하와 과부하를 나눠 검증해야 한다. 같은 요청 도착률과 실행 시간에서 HTTP 실패, 이벤트 전달 지연의 분포, 메모리 최고 사용량을 함께 기록하고, 부하가 줄어든 뒤 대기열과 화면 갱신이 회복되는지도 확인한다. 기존 클라이언트의 인증·보안 동작을 바꿔도 되는지, 프로세스가 재시작됐을 때 무엇을 다시 읽어 복구하는지도 승인 범위에 남겨야 한다.
코드를 다시 만들 때 제품팀이 먼저 정할 요구사항이 이번 사례에서는 알림 도착과 복구의 조건으로 구체화된다. 코드 검토에서는 느린 데이터베이스 작업이 다른 처리를 막는지, 큐에 상한이 있는지, 뒤처진 연결을 어떻게 처리하는지 확인할 수 있다. PM과 운영자가 이 조건을 정해 두면 개발팀은 “더 빠른 구현”이라는 완료 보고 대신, 정해진 부하에서 화면이 언제 갱신되고 과부하 뒤 어떻게 회복됐는지를 보여 줄 수 있다.