
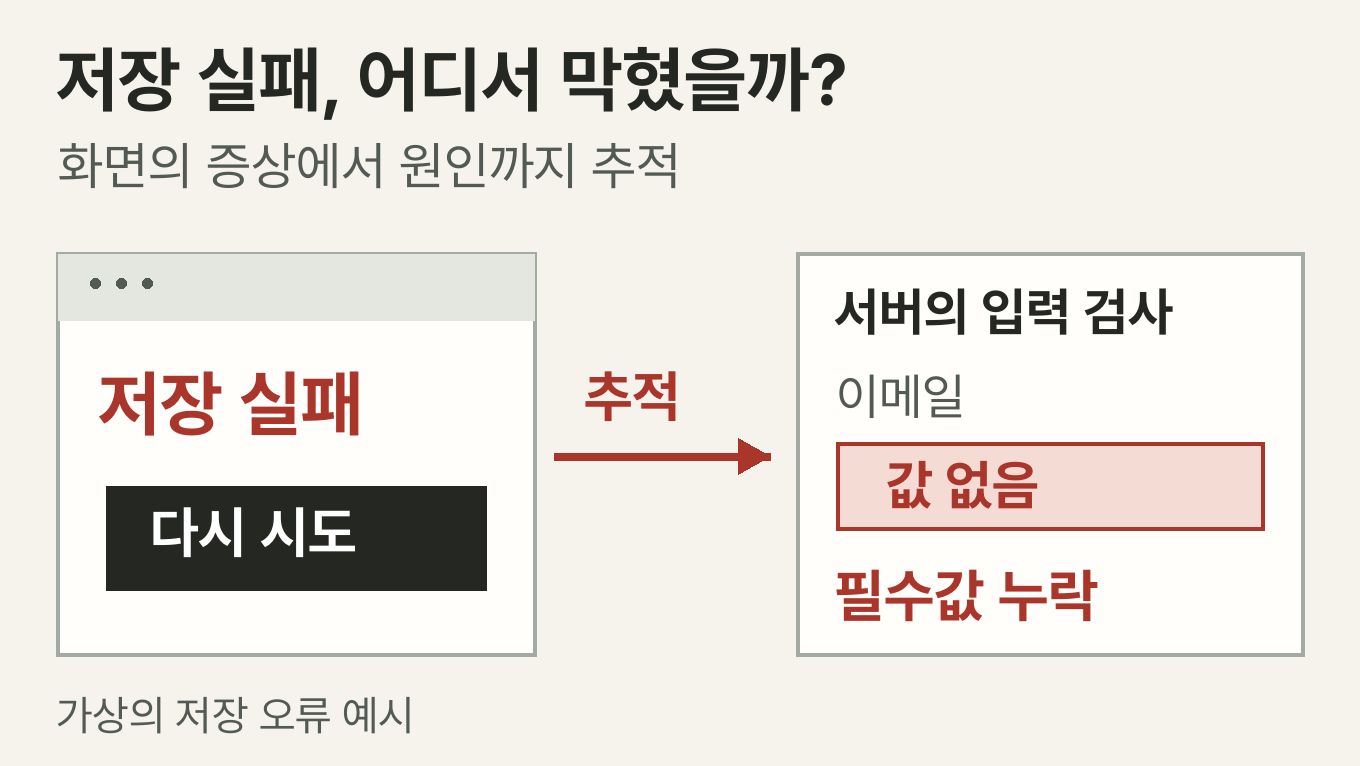
AI로 만든 서비스가 시연에서는 잘 돌아간다. 그런데 오류 하나를 고치자 다른 곳이 이상해지고, 다음에 무엇을 해야 할지조차 다시 AI에게 물어야 한다면 출시 준비가 끝났다고 볼 수 있을까. 소프트웨어 개발자 마크 시먼(Mark Seemann)이 2026년 9월 16일 공개한 글은 이런 고민을 담은 실제 독자 편지에서 출발한다. 기능을 구현하는 속도와 그 기능을 이해하는 속도가 벌어졌을 때의 이야기다.
AI로 시제품을 만든 창업자와 PM에게 이 편지는 출시 전 질문을 바꿔 보게 한다. 기능이 몇 개 완성됐는지에 더해, 오류가 어디서 생겼다고 판단하는지와 수정이 맞았음을 어떻게 확인할지 물어볼 필요가 있다. 여기서 '내 제품'이라는 말은 저작권이나 법적 소유권보다, 고장 났을 때 팀이 판단하고 고칠 수 있는 범위에 가깝다.
독자는 무엇을 만들었고, 어디에서 막혔나
편지를 보낸 독자는 정규 컴퓨터과학 교육을 받지 않았지만, 약 1년 전 AI 보조 프로그래밍에 빠져들었다. TypeScript와 JavaScript로 API, PostgreSQL 데이터베이스, LLM 처리 파이프라인을 엮은 상당한 규모의 시스템을 만들었다고 한다. 연구 자동화와 여러 모델을 함께 쓰는 작업도 포함됐다. 아이디어를 실제로 구현하기까지의 거리가 갑자기 짧아진 듯했다고 독자는 썼다.
어려움은 이 시스템을 실제 운영 제품으로 바꾸려 할 때 드러났다. AI로 한 오류를 수정하면 다른 오류가 나타났고, 다른 부분은 자신이 충분히 이해하지 못한 방식으로 움직였다. 몇 달간 코드를 재구성한 뒤 독자는 자신이 이해할 수 있는 수준을 넘어선 시스템을 만들었을지 모른다고 돌아봤다. 잘 작동할 때는 보이지 않던 격차가, 작동하지 않을 때 선명해졌다는 것이다.
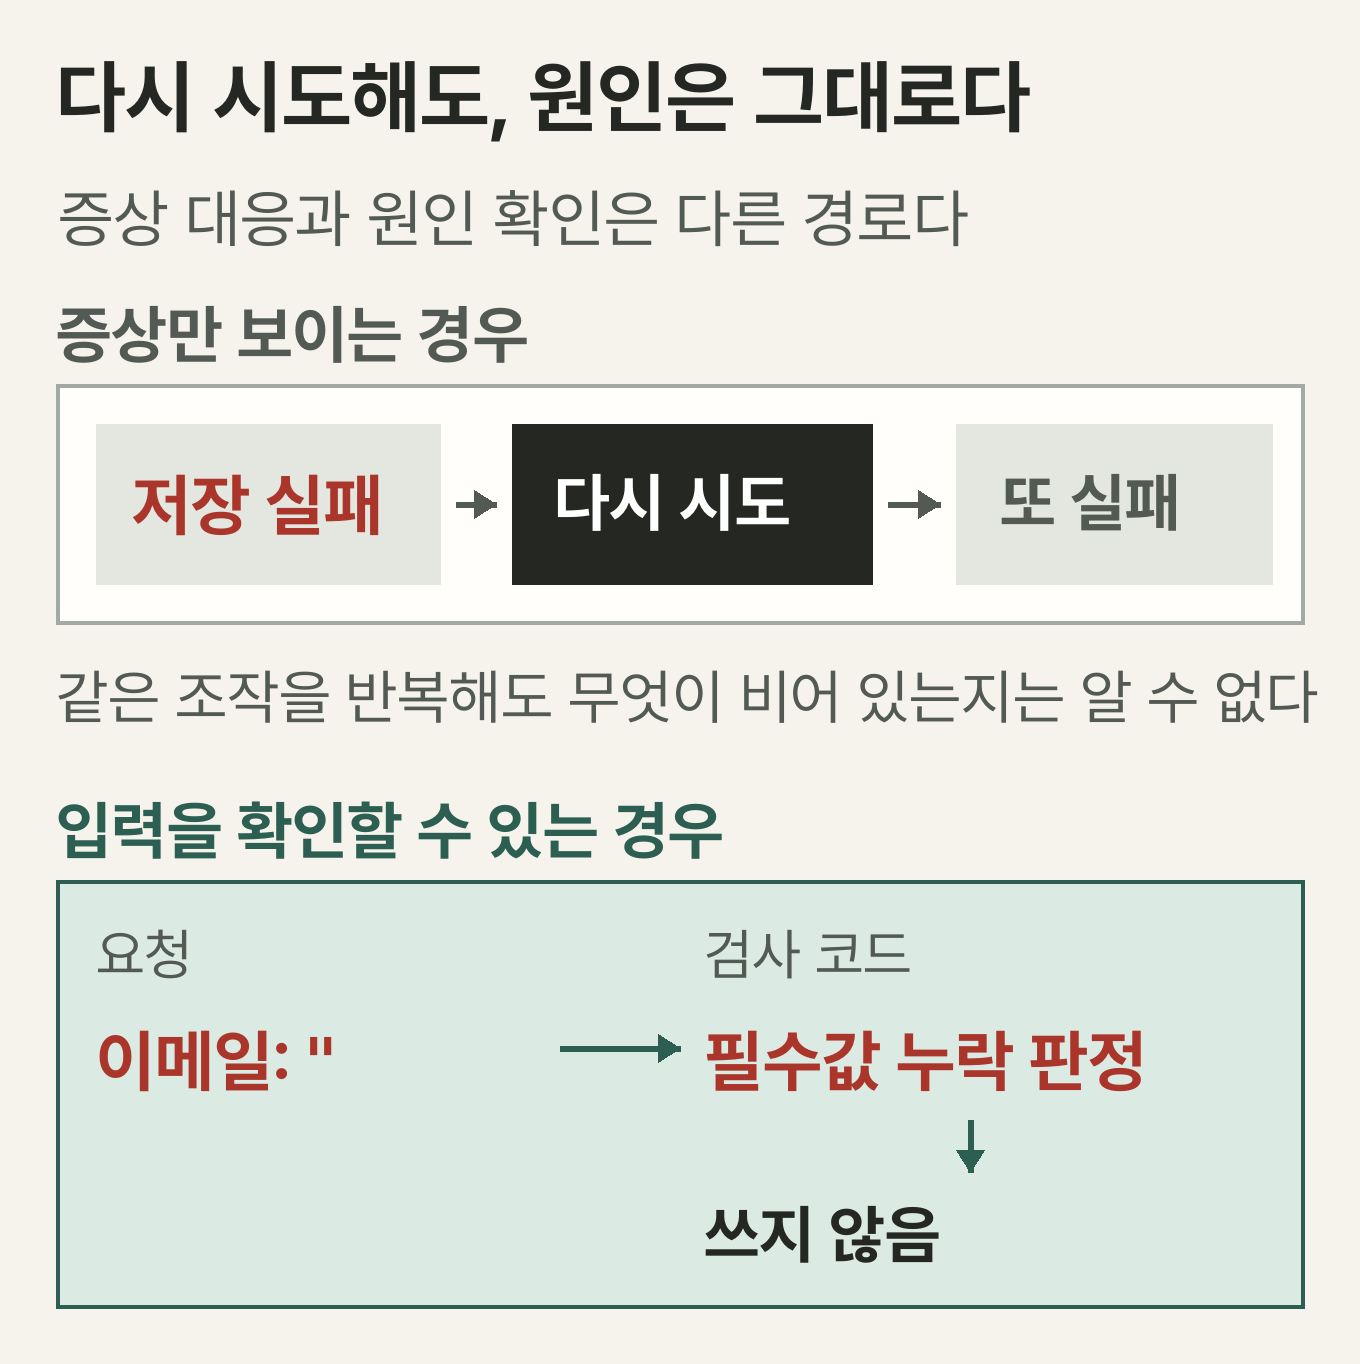
독자의 경험에서 읽을 수 있는 것은 구현된 기능의 규모가 문제를 다룰 능력까지 보여 주지는 않는다는 점이다. 이를 출시 판단에 적용한다면, 시연에 성공한 기능 하나를 골라 입력이 들어온 뒤 결과가 나오기까지의 경로를 팀이 설명해 보는 편이 유용하다. 설명이 끊기는 지점은 추가로 배울 범위를 찾는 출발점이 된다.
컴퓨터과학 전체를 배워야 출시할 수 있나
시먼은 개발자들이 오래전부터 자신이 완전히 이해하지 못하는 추상화 위에서 일해 왔다고 짚는다. 웹 개발자가 컴파일러 구현을 모두 알지는 않고, 컴파일러 개발자도 반도체 회로 설계를 전부 알지는 않는다. 내부를 몰라도 쓸 수 있도록 세부 사항을 감춘 것이 추상화다. 모든 내부 동작을 알아야 제품을 만들 수 있다는 요구는 현실적이지 않다.
대신 그는 자신이 일하는 추상화층의 바로 아래와 바로 위를 이해하라는 경험칙을 제시한다. 대부분의 문제를 추적하는 데 도움이 된다는 설명이다. 이는 모든 기술을 얕게 훑으라는 뜻보다, 현재 작업과 맞닿은 경계를 먼저 배우라는 조언으로 읽을 수 있다.
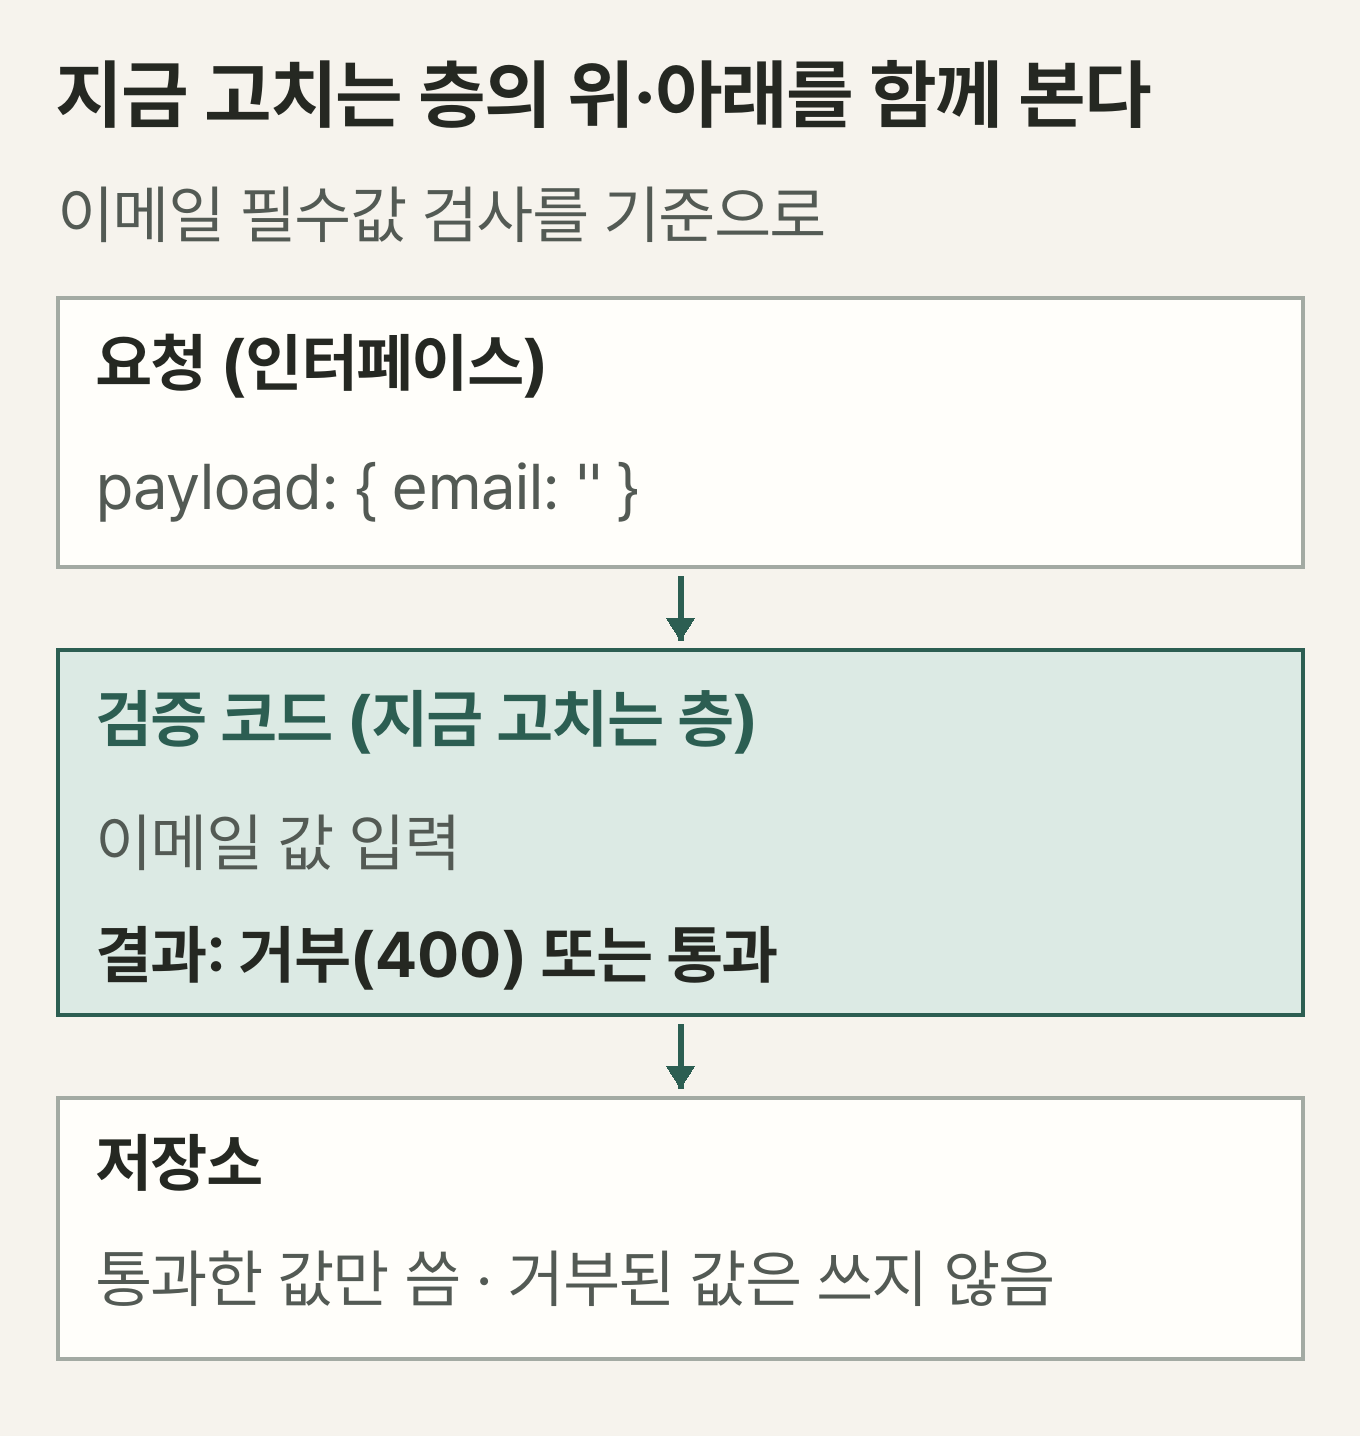
웹 서비스 팀의 학습 범위에 적용해 보자. API 처리 코드를 고치는 사람이 위쪽에서는 그 API를 호출하는 화면이나 업무 흐름이 어떤 응답을 기대하는지 살피고, 아래쪽에서는 실제 HTTP 요청과 데이터 저장이 어떻게 이뤄지는지 공부할 수 있다. '네트워크 공부'처럼 큰 과목명으로 시작하는 대신 내가 보내는 요청과 받는 응답부터 설명해 보는 식이다.
원문이 연결한 시먼의 2024년 글에서도 SQL과 HTTP는 여러 기술에 옮겨 쓸 수 있는 기초 지식의 예로 등장한다. 그 목록을 모두 끝내야 한다는 뜻은 아니다. 지금 쓰는 도구의 화면이나 사용법을 익히는 데서 한 걸음 더 들어가, 도구를 바꿔도 남을 지식을 배우자는 취지다. 출시를 준비하는 팀이라면 설명하지 못한 경로에 연결된 기초부터 학습하고, 담당자가 없는 부분은 도움을 받을 범위로 정할 수 있다.
AI에게 어떤 질문을 해야 수정이 맞는지 알 수 있나
시먼은 AI를 쓰느냐 마느냐보다 자신이 답을 확인할 수 있는 질문을 고른다고 설명한다. 원문에 든 예는 '이 Haskell 표현식을 더 간결하게 만들 수 있는가'다. 제안된 코드를 보고 실제로 동작하는지, 더 짧아졌는지 확인할 수 있다. 반면 '다음에는 무엇을 배워야 하는가'라는 답은 같은 방식으로 맞고 틀림을 가리기 어렵다.
그가 선호하는 것은 반증 가능한 질문이다. 쉽게 말해 어떤 관찰 결과가 나오면 AI의 답이 틀렸다고 판단할지 정할 수 있는 질문이다. 문장이 그럴듯하거나 설명이 길다는 이유로 답을 받아들이지 않으려는 습관이다.
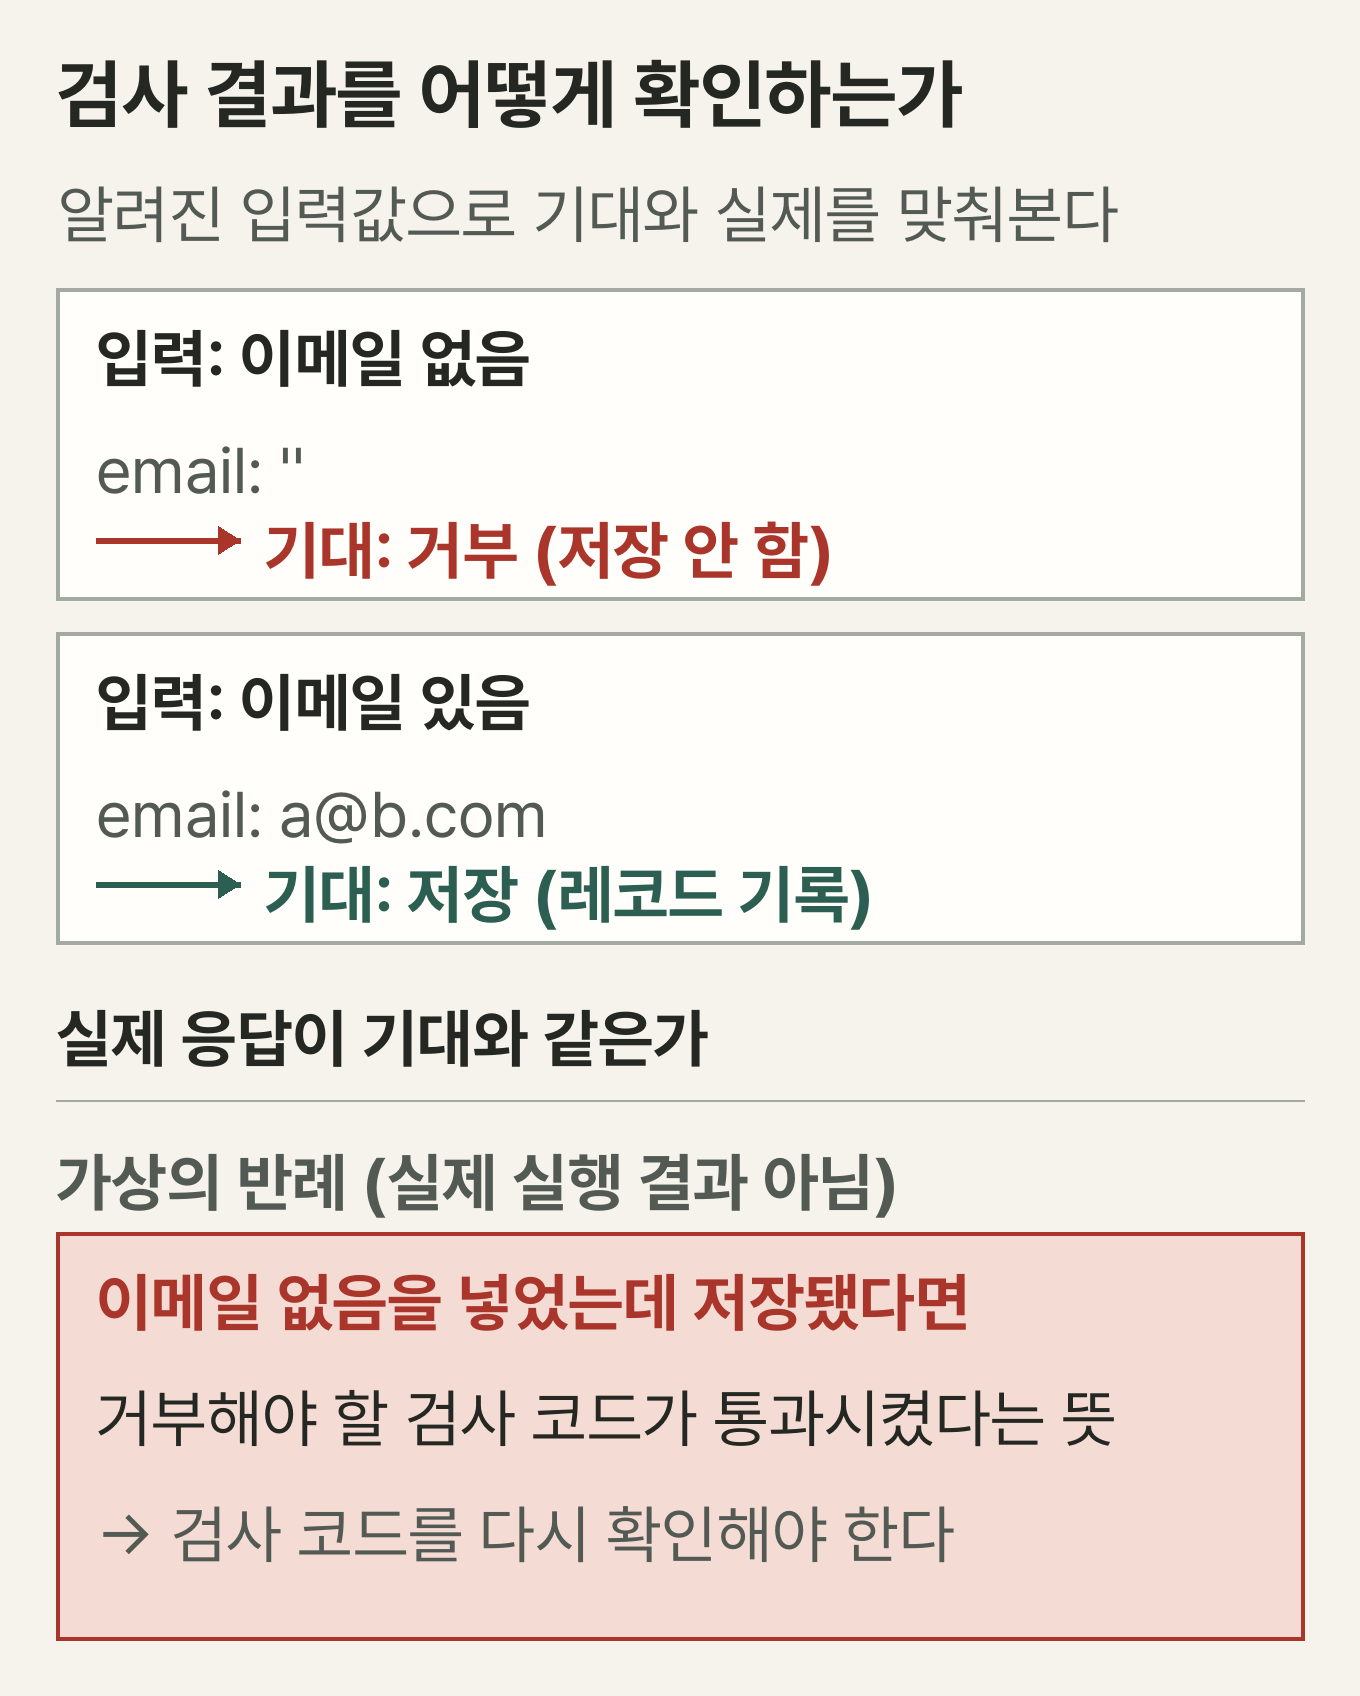
장애 수정에 이 원칙을 적용한다면 '고쳐 줘'라는 요청에 앞서 문제를 다시 일으키는 입력과 기대한 결과를 적어 볼 수 있다. AI가 원인을 제안했을 때는 그 설명이 틀렸음을 보여 줄 조건도 묻는다. 수정 뒤에는 같은 입력으로 문제가 사라졌는지 확인하고, 원래 정상이어야 할 동작도 다시 살핀다. 이 절차는 원문의 질문 원칙을 장애 수정에 옮긴 편집 적용안이다.
창업자나 PM이 모든 코드를 직접 고칠 필요는 없다. 다만 출시 검토에서 'AI가 해결했다고 했다'는 답 다음에 어떤 확인 기록을 요구할지는 정할 수 있다. 원인 설명에 근거가 있는지, 수정 전후를 같은 조건으로 비교했는지 담당자에게 물어보는 것이다. 이 확인을 맡을 사람이 없다면, 기능을 더 추가하기 전에 그 역할부터 확보할 이유가 있다.
출시 준비에는 보안과 운영 점검도 필요하다. 그와 함께, 지금 만든 기능에서 설명이 끊기는 부분을 찾아 학습 계획에 넣을 수 있다. 학습 계획에는 그 부분을 담당할 사람과 수정 결과를 확인할 방법을 함께 적어 둔다.
출처: Mark Seemann, On learning programming in an age of LLMs · Fundamentals