
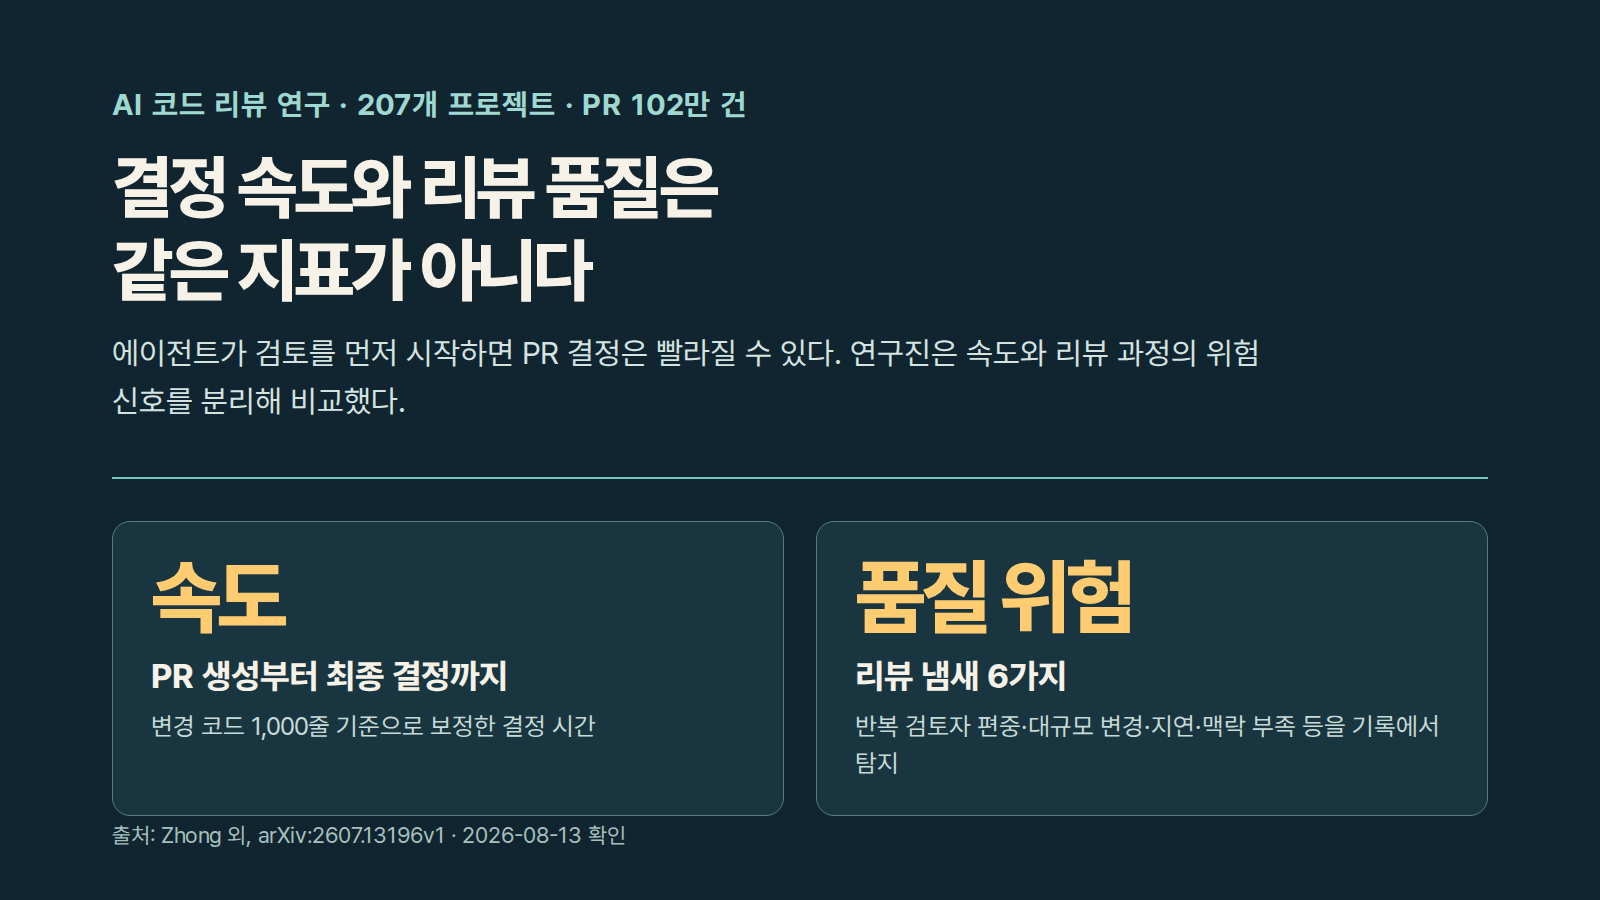
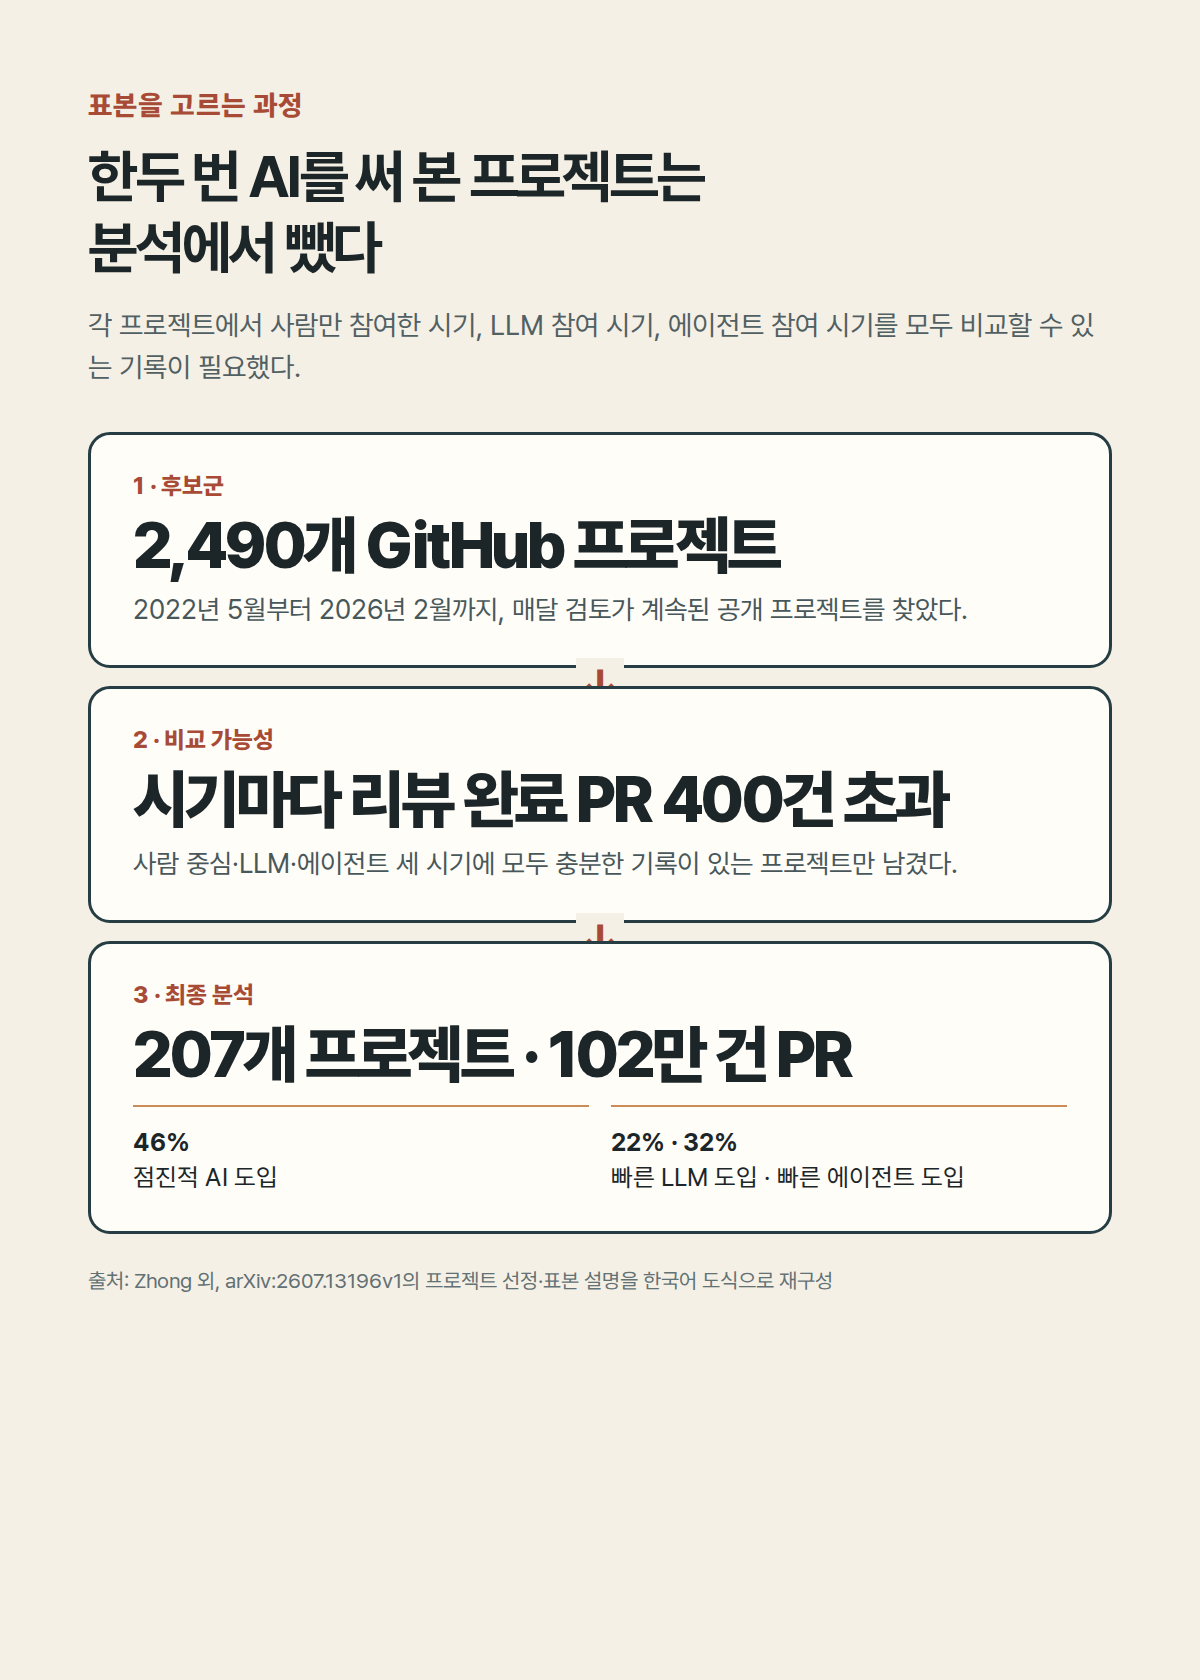
AI 코드 리뷰어가 참여하면 풀 리퀘스트(PR) 결론은 빨라질 수 있다. 그렇다고 코드 리뷰의 품질 위험까지 낮아지는 것은 아니다. 퀸스대학교 연구진은 207개 오픈소스 GitHub 프로젝트의 리뷰 완료 PR 102만 건을 추적해, 사람만 참여하던 시기와 LLM 보조 시기, AI 에이전트 참여 시기를 비교했다. 2022년 5월부터 2026년 2월까지의 기록이다.
연구진은 AI 도입 방식을 세 갈래로 나눴다. 천천히 AI 비중을 늘린 프로젝트는 46%, LLM을 빠르게 도입한 프로젝트는 22%, 에이전트를 빠르게 도입한 프로젝트는 32%였다. 에이전트가 첫 의견을 내거나 여러 에이전트가 참여한 리뷰는 일부 도입 방식에서 사람만 검토한 경우보다 더 빨리 끝났다. 그러나 AI가 낀 협업 패턴은 대체로 사람만 검토한 경우보다 리뷰 과정의 위험 신호가 더 자주 나타났다.

연구진은 무엇을 품질로 측정했나
이 연구에서 속도는 PR 생성부터 최종 결정까지 걸린 시간을 바뀐 코드 1,000줄(KLOC) 기준으로 나눈 값이다. 큰 변경이 원래 더 오래 걸리는 문제를 줄이기 위한 보정이다. 품질은 배포 후 버그 수가 아니라 PR 기록에서 찾을 수 있는 여섯 가지 리뷰 냄새로 측정했다. 이 가운데 반복적으로 같은 검토자에게 의존하는 '리뷰 버디', 500줄을 넘는 대규모 변경, 이틀을 넘긴 결정 지연, 맥락 없는 PR 설명, 과도한 수정 요청 왕복, 검토자 부재가 포함된다.
그래서 이 논문이 말하는 품질은 코드가 실제로 고장 났는지를 판정한 점수가 아니다. 리뷰 과정에서 시야가 좁아지거나 검토가 부실해질 가능성을 보여 주는 운영 지표다. AI 리뷰의 효율을 논할 때 병합까지 걸린 시간 하나만 대시보드에 놓으면 놓치기 쉬운 구분이다.
어떤 도입 방식에서 속도와 위험 신호가 갈렸나
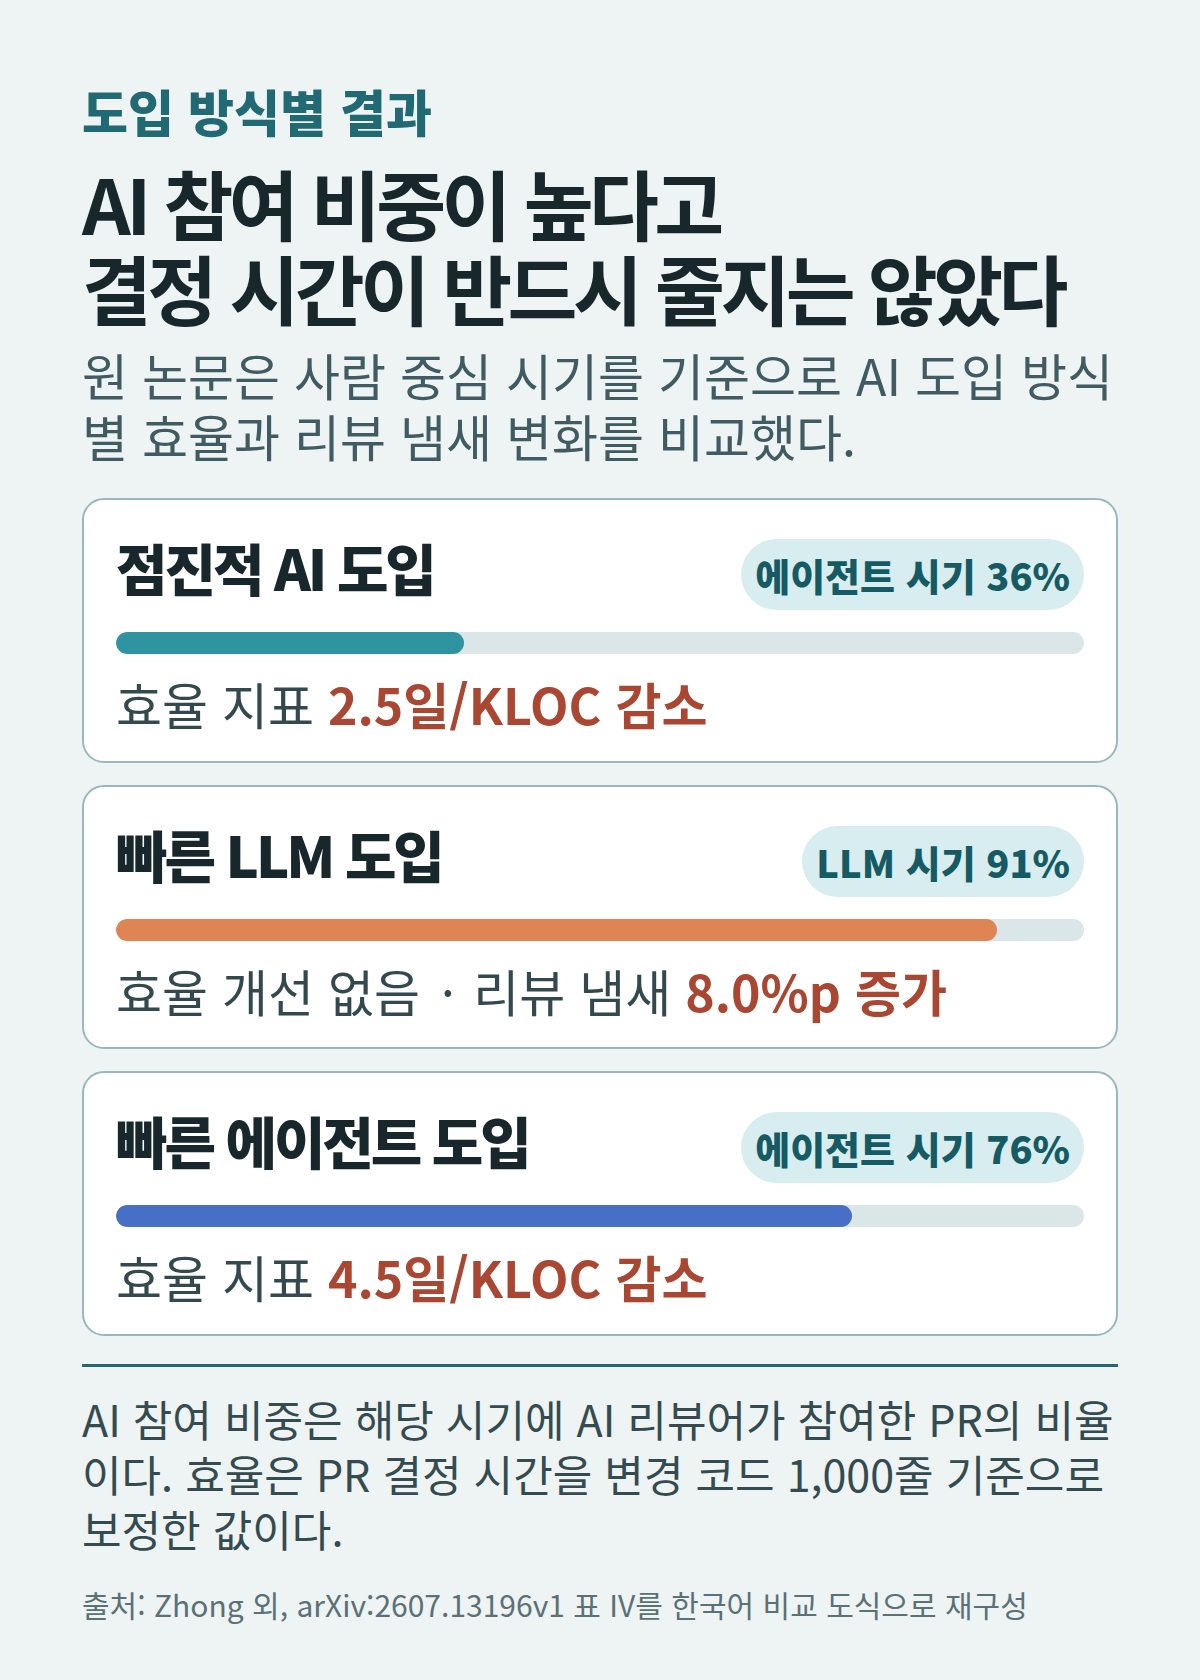
점진 도입 그룹은 에이전트 시기에 AI 참여 PR 비중이 36%였고, 효율 지표가 사람만 쓰던 시기보다 2.5일/KLOC 낮아졌다. 빠른 에이전트 도입 그룹도 AI 참여 비중 76%, 효율 지표 4.5일/KLOC 감소를 보였다. 반면 빠른 LLM 도입 그룹은 LLM 시기에 이미 AI 참여 비중이 91%였지만 효율 지표의 유의미한 개선이 없었다.
리뷰 냄새는 다른 방향으로 움직였다. 빠른 LLM 도입 그룹에서는 전체 리뷰 냄새 비율이 LLM 시기에 8.0%포인트, 에이전트 시기에 4.4%포인트 늘었다. 같은 검토자에게 PR의 절반 이상을 반복 배정하는 리뷰 버디는 LLM 시기에 26.0%포인트, 에이전트 시기에 23.2%포인트 증가했다. 자동 리뷰 계정을 기본 담당자로 고정하면, 빠르게 답을 받더라도 다른 사람이 발견할 문제를 건너뛸 수 있다는 뜻이다.
에이전트가 먼저 보면 왜 결정은 빨라지나
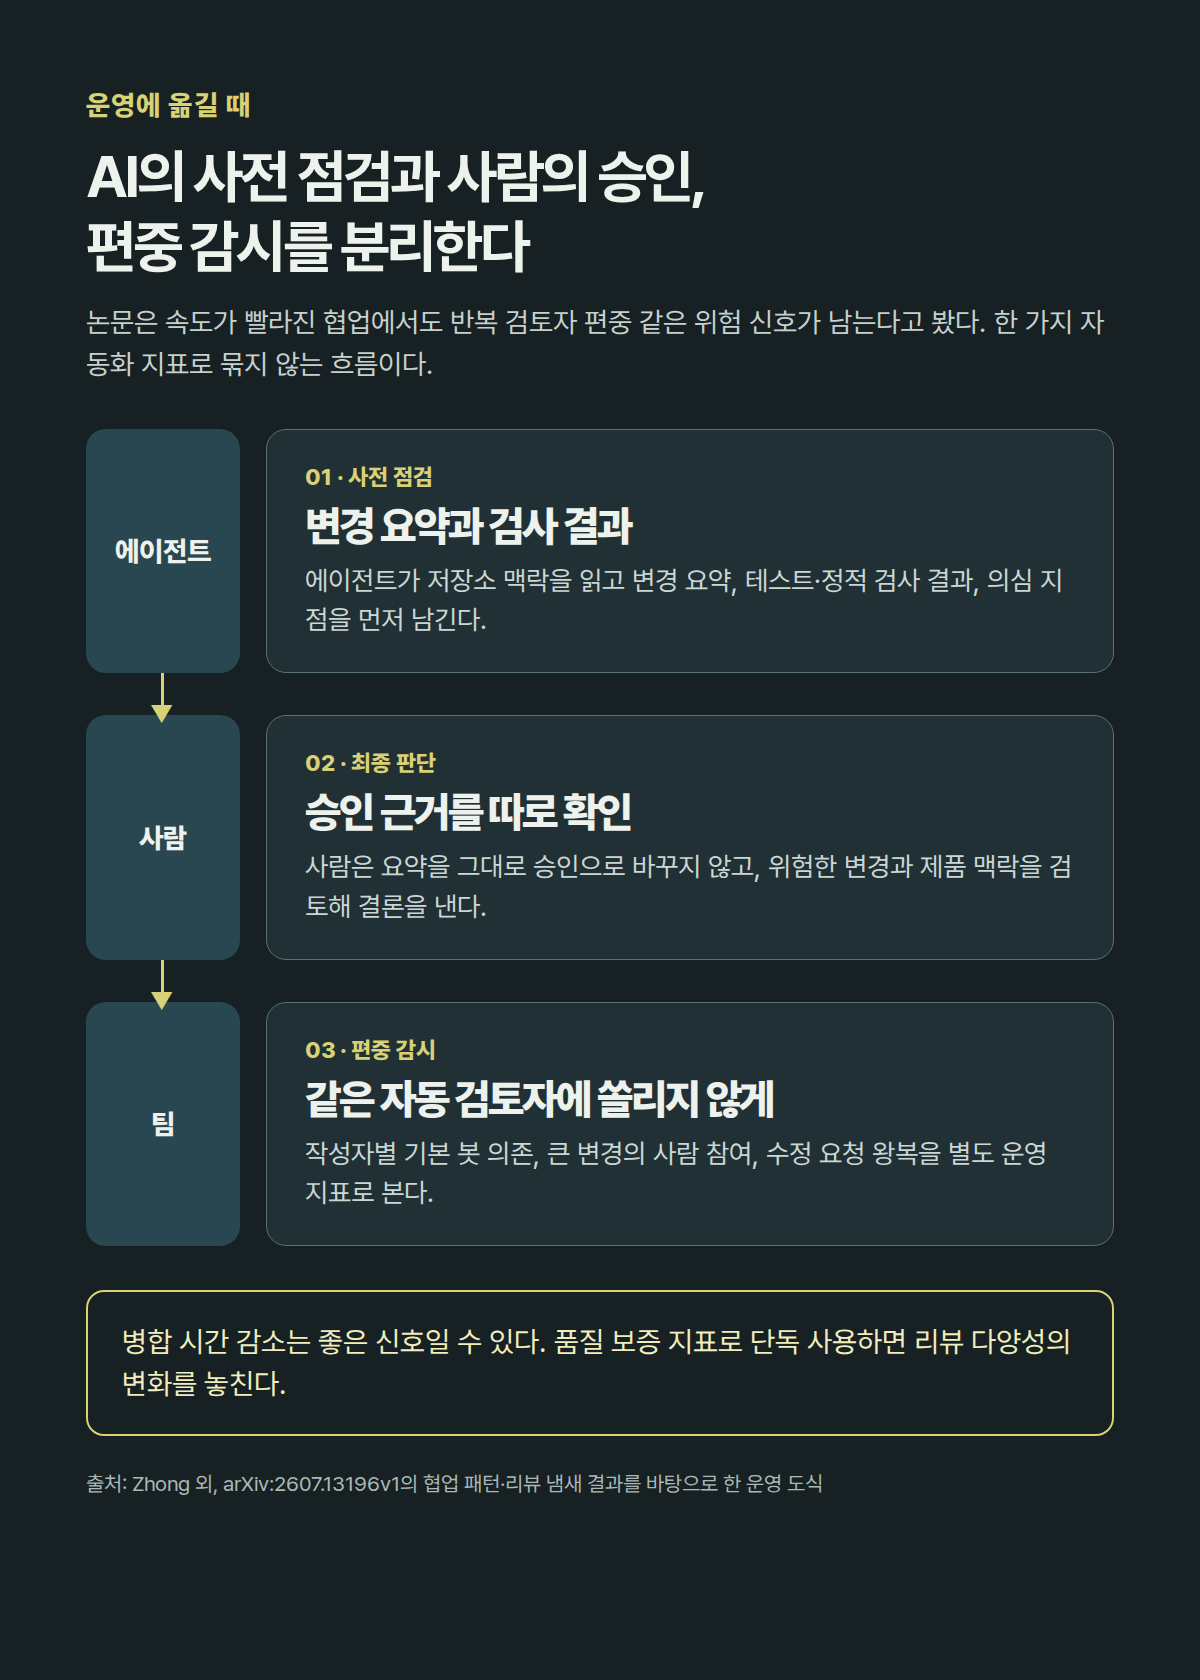
에이전트 시기에는 에이전트가 먼저 검토를 시작한 패턴과 여러 에이전트가 참여한 패턴이 점진 도입·빠른 에이전트 도입 그룹에서 사람만 검토한 경우보다 빠른 순위를 기록했다. 연구진은 이 PR들의 75~95%에서 에이전트가 코드 변경 요약과 점검 결과를 먼저 올리고, 사람이 짧은 의견을 남긴 뒤 결론을 내렸다고 설명한다. 사람이 처음부터 변경 내용을 훑는 단계를 줄인 결과로 읽을 수 있다.
하지만 협업 패턴별 리뷰 냄새 비율은 사람만 검토한 경우 69~76%, AI가 참여한 경우 78~94%였다. 평균적으로 리뷰 버디 비율도 사람만 검토한 경우 16%에서 LLM 참여 패턴 60%, 에이전트 참여 패턴 53%로 높아졌다. 이 수치는 AI가 품질 저하를 일으켰다는 인과 결론이 아니라, PR 크기·검토 활동·참여자 경험을 함께 넣어 분석해도 협업 방식이 강한 설명 변수로 남았다는 결과다.
팀의 AI 리뷰 지표는 어떻게 바꿔야 하나
AI 리뷰를 도입한 팀은 '병합까지 걸린 시간'과 함께 검토자 다양성을 따로 추적할 필요가 있다. 같은 봇 계정이 특정 작성자의 PR을 계속 맡는지, 큰 변경에서 사람이 실제로 참여하는지, AI 의견 뒤 수정 요청이 얼마나 왕복하는지가 후보가 된다. 에이전트가 리포지터리 맥락을 읽고 검사 도구를 돌린 결과를 먼저 내는 흐름은 유용하다. 그 결과를 승인 근거로 바로 바꾸는 흐름은 별개로 설계해야 한다.
이번 분석은 프로젝트마다 AI 도입 시점이 다르고, AI 에이전트가 처음 등장한 뒤에도 LLM 리뷰어가 계속 참여할 수 있다는 현실을 반영했다. 따라서 '에이전트 시대'는 도구 하나의 성능 등급이 아니라 프로젝트 기록에서 첫 에이전트 리뷰 뒤의 기간을 뜻한다. 빠른 결정이 곧 더 넓은 검토를 뜻하지 않는다는 구분이 이 논문의 실무적인 결론이다.